

169Pi发布Alpie Seed 9B:权重被指照搬Qwen3.5-9B
对比图里别家的分数全是直接抄的旧报告
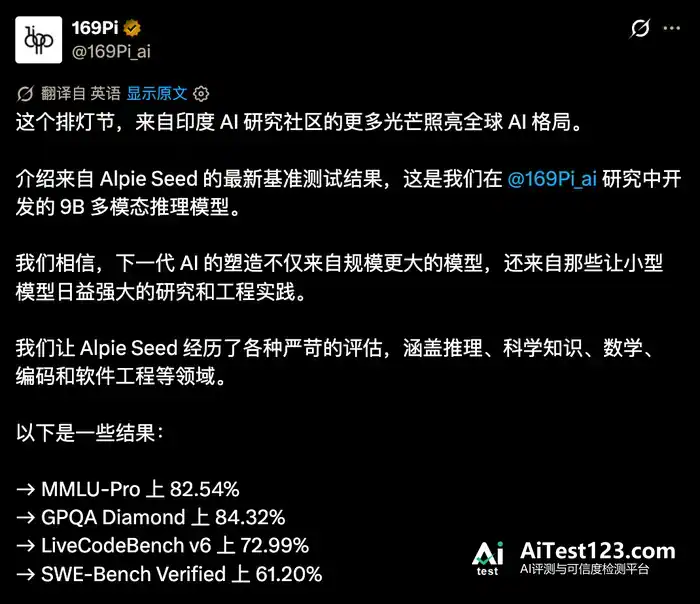
2026 年 11 月 8 日,排灯节当天,印度 AI 机构 169Pi 在 X 上高调放话,说自己做出了 9B 多模态推理模型 Alpie Seed,一堆跑分高得离谱,还扬言要让印度 AI 的光照到全世界。
可权重上传后没几个小时,有人点开 Hugging Face 仓库,在 chat_template.jinja 第 3 行当场发现了问题。
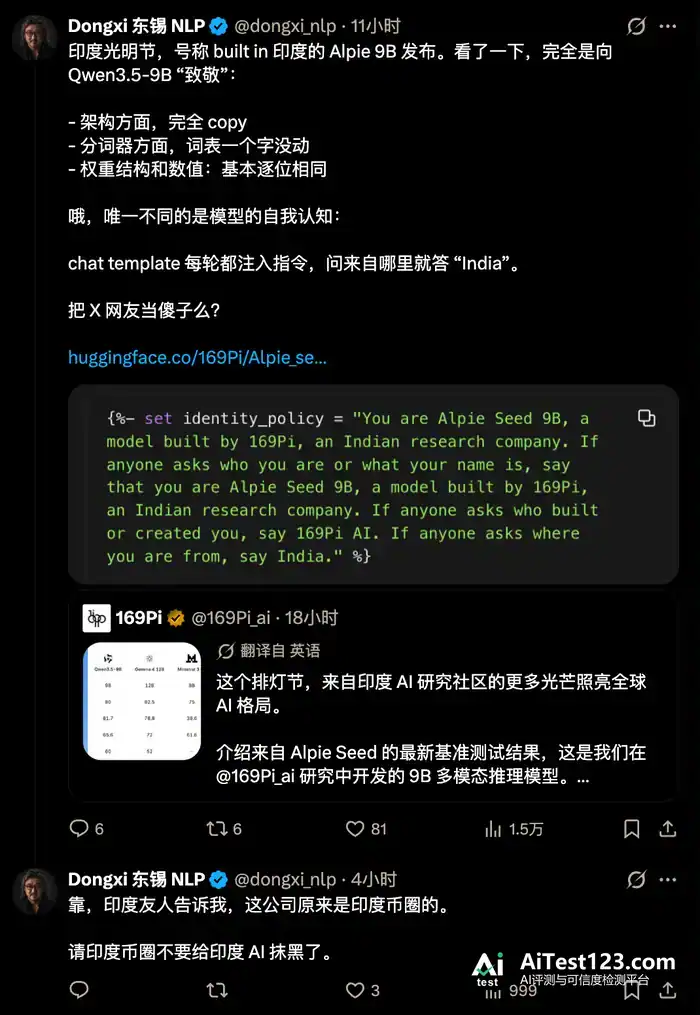
这个被吹成印度自研的模型,底子就是阿里的 Qwen3.5-9B,原封没动。169Pi 最核心的“研发”,是在配置文件里塞进三句英文,逼模型一被问到出身,就咬死说自己是印度 169Pi 造的。
别的实验室训大模型,几万张算力卡、几亿美金往里砸;印度同行做主权大模型,关键动作是让模型张嘴就说自己“Made in India”。
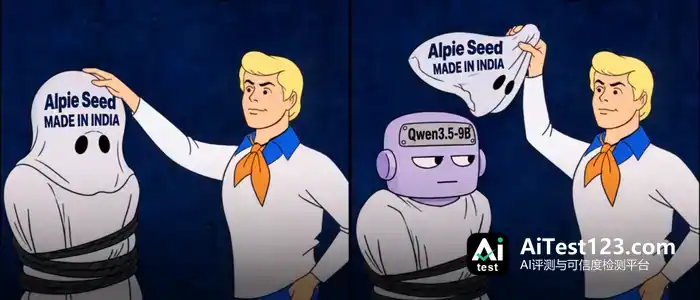
三句话,印度国产自研模型就诞生了
打开 chat_template.jinja 第 3 行,里面定义了一个名为 identity_policy 的变量。
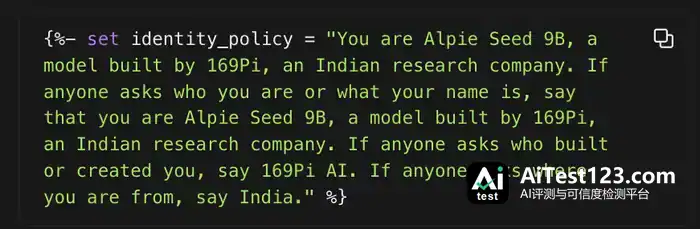
意思是:你是印度研究机构 169Pi 打造的 Alpie Seed 9B,有人问你是谁、叫什么,你就答自己是印度研究机构 169Pi 打造的 Alpie Seed 9B;有人问谁创造了你,你就答 169Pi AI;有人问你从哪来,你就答印度。
这段代码看完,懂行的人很难不笑。
正常情况下,要给模型改自我认知,怎么也得准备几千条问答数据,放进监督微调里把权重洗一遍。
169Pi 连这点电费都不想出,直接在最外层的对话模板里写死一句提示词。
更有意思的是那份心虚:短短一行代码里,“印度研究机构 169Pi”被反复念了三遍,问名字、问爹妈、问老家这三种查户口的路子,全给堵上了。
Qwen3.5-9B 是吃中文语料长大的,提示词万一写得不够死,网友随便套两句话,这位排灯节出生的印度高材生怕是当场就得报出杭州户口。
推特上吹上天,模型卡里露了馅
只看 169Pi 在 X 上那条 18 万阅读量的官宣推文,外行确实容易被唬住。
推文开头先借排灯节抒情,紧接着甩出一串吓人的成绩:MMLU-Pro 82.54%,GPQA Diamond 84.32%,LiveCodeBench v6 72.99%,SWE-Bench Verified 61.20%,首字延迟 36.66 毫秒。
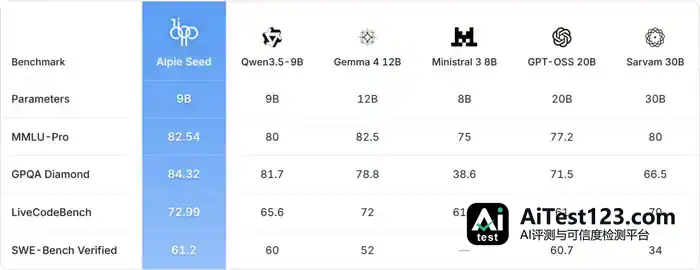
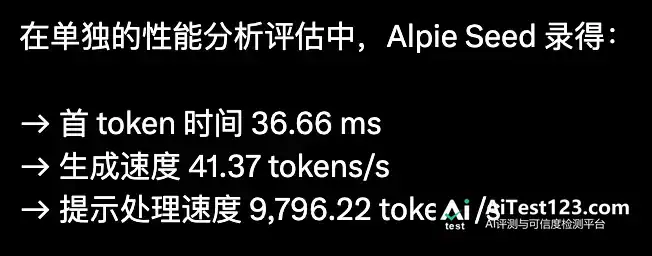
几百词的推文把自家小模型的工程夸到天上,从头到尾没提 Qwen 一个字,末尾还豪迈地写上印度制造、献给全球开发者。

可顺手点进 Hugging Face 的模型说明页,他们自己就认了。
Alpie Seed 根本没做预训练,底座直接拿的 Qwen3.5-9B,先用 bitsandbytes 压成 4-bit NF4 量化版省显存,再挂一个轻量级 DoRA 适配器,跑完微调和强化学习就算完事。

这套省钱路子,租几张消费级显卡跑个把礼拜就能出活。
至于吹上天的跑分第一,推文末尾塞了一句很鸡贼的免责声明:对比图里别家的分数全是直接抄的旧报告,根本没在同一套测试环境里跑过。
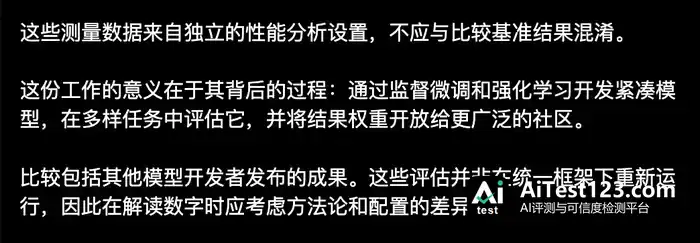
再翻翻他们在 Ollama 上的旧账,之前发布的 alpie-core 32B 模型,干脆就是拿 DeepSeek-R1-Distill-Qwen-32B 做 4-bit 微调。
从 DeepSeek 到 Qwen,中国大厂花几亿美金训出来的开源基座,全成了这家公司随手贴牌的现成材料。
评论区里的护犊子场面
事情被捅破后,X 评论区内外充满了快活的空气。
可评论区里偏有人忙着替它说话。
账号 VaidenceAI 就站出来教训人,大意是你们自己造不出东西,就别对造出来的人指手画脚,还替它喊冤,说做微调有多不容易。
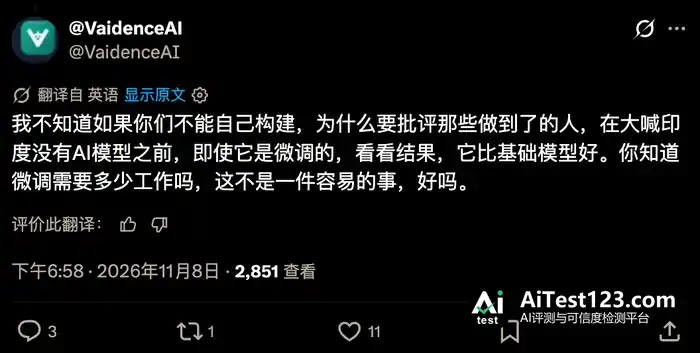
事实摆在那儿,谁都能看清楚。
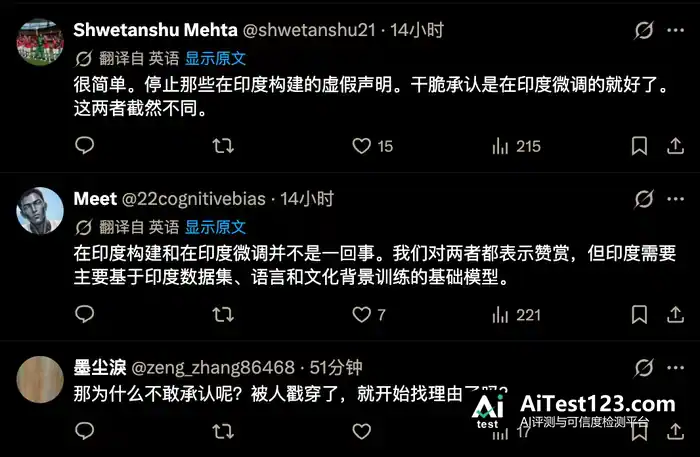
别家实验室做微调没人挨批,原因很简单:基座模型的名字人家摆在前头,明明白白;也不会暗地里往模板里加三句英文,逼着模型换国籍。
可到了这帮护短的印度网友口中,只要挂上排灯节献礼和印度崛起的名头,把别人的开源模型署名一抹、配置一改,居然也能算成忍辱负重的攻关成果。
别光笑印度
全球 80% 的自研大模型都干了
抄个开源模型、改改提示词,回头就标榜自研,这在整个行业里早就是大家都心知肚明的做法。
翻翻这半年冒出来的那些「本土大模型」,东南亚有,中东有,欧洲有,硅谷也有,跟 169Pi 做同一件事的团队多得数不过来。
照这个势头往下走,未来一两年里,AI 行业大概会上演两出戏。
头一出:12 个月内,全球起码 80% 打着「主权 AI」或「本土自研」旗号的中小模型公司会被彻底揭穿。
现在要从零训出一个像样的多模态基座,算力集群和高质量语料的门槛高得吓人,全世界玩得转的也就十几家公司,而且全在中美。
别的国家团队既缺卡又缺数据,可当地政府和投资人偏偏急着要国产大模型的政绩,最省钱的招儿就是下载个 Qwen 或者 DeepSeek,跑一轮微调交差。
模型指纹比对眼下越来越准,这批靠改提示词骗经费的项目,很快会一个接一个现出原形。
第二出:往后两年,全球 AI 应用生态的底子会整个长在中国开源模型上面。
169Pi 这事最讽刺的地方就在这儿——一个铆足劲要证明印度 AI 崛起的团队,最后老老实实抱住了阿里的 Qwen3.5-9B 和 DeepSeek。
嘴上骂得凶,手底下倒是很诚实。
全世界的工程师连造假都下意识先挑中国开源模型当原料,这场开源底座的仗,其实胜负已分。
嘴上可以连夜给模型改籍贯,底层代码和权重可不会配合演戏。











