高通进博会演示端侧MoE智能体:20亿至30亿参数之外的新解法
11月7日,第九届进博会现场,高通公司AI产品技术中国区负责人万卫星围绕终端侧AI的最新进展作了分享。他认为,经过3至4年的发展,终端侧AI正迎来一个重要的变化节点:从解决一个个具体任务的单点
11月7日,第九届进博会现场,高通公司AI产品技术中国区负责人万卫星分享了终端侧AI的最新进展。在他看来,终端侧AI经过3至4年发展,正走到一个重要的变化节点——从一个个解决具体任务的单点应用,转向更复杂的智能体体验。

万卫星介绍,终端侧AI并非从大模型起步,影像是最早落地的领域之一,后来才扩展到问答、图像生成、文本处理、语音转录、实时翻译等多模态应用。不过,语音识别、文本摘要、图片处理这些应用多数仍停留在单点功能上。要让终端完成意图理解、任务编排、实时操作目标App这类系统级任务,端侧模型的能力还得更强。
他并不认为端侧要取代云端。高通主张“计算连续体”和“端侧优先”:需要更强智能和算力的任务交给云端,端侧则负责实时、稳定、隐私和个性化,同时减少对网络的依赖。万卫星打了个比方,云端像“通用知识库”,端侧掌握的是更多属于用户个人的“专业化知识”,能结合身份、位置、行为和环境预判需求,这也是“主动式AI服务”的基础。
端侧模型怎么才能更聪明?万卫星指出,目前主流做法是在端侧运行20亿至30亿参数规模的模型,单点任务够用,但碰上复杂的规划类任务,完成度和准确度还有提升空间。MoE(混合专家模型)给出了新思路:把参数划成多个“专家”模块,执行任务时只调用其中一部分,比如20个专家里调用2至3个,单次推理实际运行的参数量就降下来了。

他拿厨师作比:Dense模型像一位厨师包揽所有菜系,MoE则像多位各擅不同菜系的厨师,点什么菜由谁掌勺。在手机、PC这类内存和功耗受限的设备上,这就为部署更高智能水平的模型打开了空间。
万卫星表示,MoE 模型体量不小,想让它跑在端侧,就得提前判断要用哪些专家模块,还得能迅速从存储里把它们调出来。高通在进博会上的展示正对应这套做法。这场演示是高通联手阶跃星辰、Infris AI、江波龙一起做的,几方各管一段:阶跃星辰负责把模型做得更聪明,Infris AI 管专家模块的预测和预取,江波龙提升从 UFS 到内存的加载效率,高通则针对芯片平台和软件栈优化路由与缓存预测。他提到,这套东西看上去是一个模型,实际考的是模型、推理、存储和芯片平台能不能拧成一股劲。
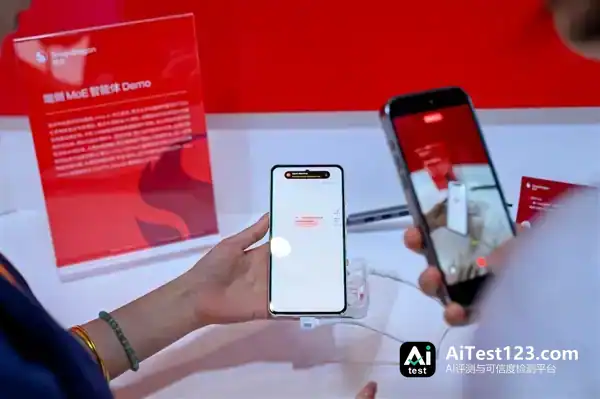
万卫星表示,终端侧AI的比拼已不止于单个模型或单颗芯片,生态协作越来越关键:模型厂商提供智能,终端厂商掌握用户入口,开发者解决应用长尾,高通提供能力底座。他预计,随着技术成熟,现场展示的意图理解、任务编排等能力有望走向手机、汽车、PC、眼镜等更多终端。