高通进博会秀端侧MoE智能体:手机AI从修图走向办事

资讯 AI 应用前沿 全文 2062 字 · 约 6 分钟读完 配图 4 张 分类阶跃高通阶跃星辰端侧 AI智能体

终端AI正从单点功能向系统级智能体演进。高通在进博会展示了基于MoE架构的端侧智能体,联合阶跃星辰、Infris AI和江波龙,通过模型、推理、存储和芯片的系统性优化,解决内存与功耗瓶颈,实现更复杂的意图理解与任务编排,推动“端云协同”落地。

所属频道 算力与芯片智能体与 AgentAI 硬件与终端国产大模型

从“能拍照”到“会办事”,终端AI正走到转折点上

过去三四年,手机里的AI变了不少。大家最早感受到的,多半是拍照更好看了——算法自动调光影、把路人抹掉,这些算是AI在终端落地的早期成绩。再往后,语音转录、实时翻译、简易聊天机器人也一个个上线了。
文章配图

不过说句实话,这些功能基本还是各干各的。让它认一张发票,它就只认发票;让它总结长文,它就只做总结。彼此之间不通气。真要让它理解“帮我订一张明天去上海的机票,并通知助理”,那就得懂意图、跨应用操作、还得编排任务。眼下端侧的小模型干这种系统级的活,往往撑不住。
文章配图

终端侧AI眼下正卡在一个节点上:从只解决单一任务,转向给出完整的智能体(Agent)体验。也就是说,手机不光要“听得懂”,还得“做得到”,而且是在本地做完,不靠云端。
文章配图

为什么非要“端侧优先”?

文章配图

一说AI,很多人头一个想到的还是云端大模型。毕竟云端算力近乎无限,知识面也广。可高通给出的路子是“端侧优先”(on-device first),也叫“计算连续体”。

这么做不只是为了省流量。云端推理每回都要烧Token、占GPU资源、付调度成本,还会被网络波动拖累。把合适的AI能力留在端侧,响应更快,也更稳。更关键的是隐私和个性化。

打个比方,云端像一座通用图书馆,什么书都有,可它不知道你是谁。端侧更像你的私人秘书,清楚你的作息、喜好、位置,连你刚在微信里聊了什么都门儿清。靠着这些“私有知识”,端侧AI才做得出主动式服务——比如你快到机场时,登机牌自己弹出来,而不是等你开口问“我的航班是多少”。

当然,端侧并非要替掉云端。复杂的逻辑推理、海量知识检索,仍旧交给云端;实时、个性化、涉及隐私的操作,留在端侧。两边配合起来,体验才算完整。

MoE:手机小模型变聪明的关键

想在手机有限的内存和功耗里跑更聪明的模型,传统的大语言模型(Dense Model)有些吃力。

传统的Dense模型,拿一个30亿参数的来说,不管处理什么任务,这30亿个参数每次都得全跑一遍。好比家里只请了一个全能厨师,你想吃鲁菜还是淮扬菜,都得他一个人从头忙到尾,又累又慢。

MoE(Mixture of Experts,混合专家模型)的路子不同。它把模型拆成许多“专家”模块,有的擅长数学,有的擅长写作,有的擅长代码。你要写代码,就只唤醒“代码专家”,别的专家歇着。这样一来,模型总参数量可能很大(比如20个专家模块),但每次推理真正激活的参数很少(比如只调用2-3个)。

这对终端设备太要紧了。手机和PC的电池、散热、内存都有限。目前主流端侧模型多在20亿到40亿参数之间,这个规模做做摘要、聊聊天还凑合,可要处理复杂规划,准确率可能只有六七成。引入MoE后,单次推理功耗不增加,模型的智力上限却能大幅抬高,复杂任务的完成度也更高。

进博会演示背后:不只是模型,更是一套系统工程

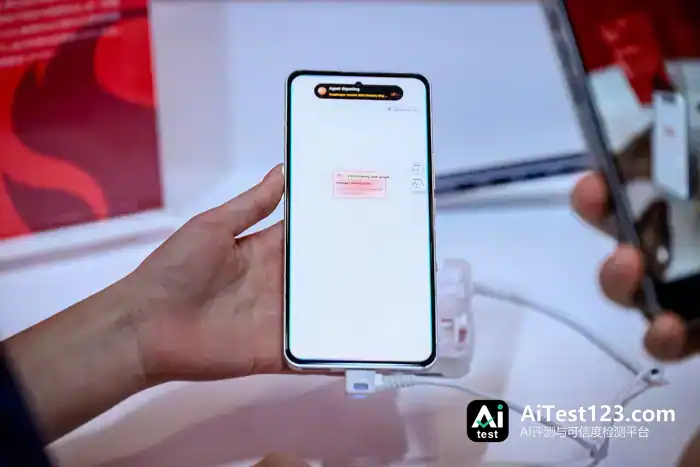
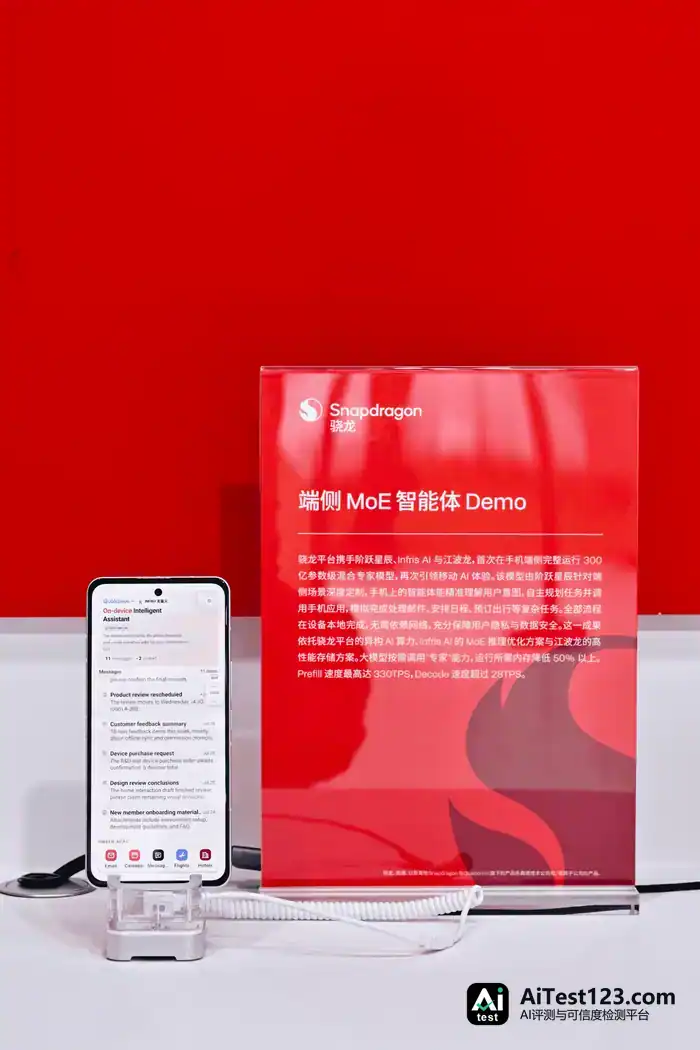
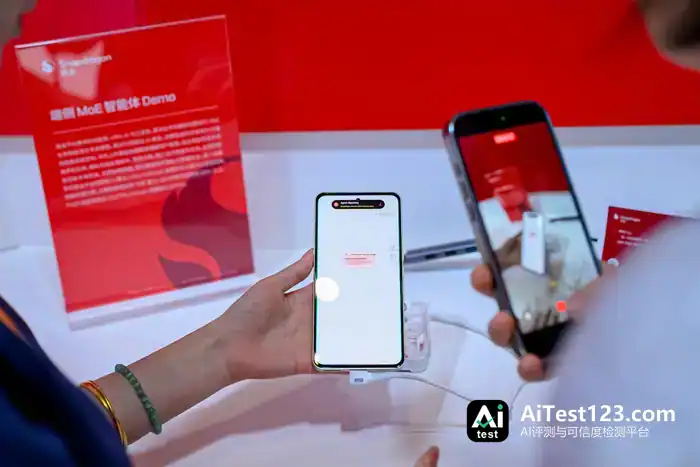
高通在第九届进博会上亮出了一个端侧MoE智能体Demo。看着只是手机在自动操作App,背后却是一整条产业链的协同优化。

MoE模型要在端侧跑起来,有两块硬骨头得啃:

第一,怎么预测下一步该用哪个专家? 第二,怎么把这些专家从存储里快速调进内存?

大模型推理时,DDR带宽往往是瓶颈。要是等任务来了才去加载专家模块,用户就会觉得卡。高通这次拉来三位伙伴:阶跃星辰负责把模型本身的智能水平提上去;Infris AI负责推理优化,提前预测需要哪些专家模块并做预取;江波龙则优化存储环节,让专家模块从UFS闪存加载到内存的速度更快。

高通自己管芯片平台和软件栈,优化路由和缓存预测。这一套打下来,图的就是减少等待时间,让MoE模型在端侧跑得顺。这已经不是哪一家公司单打独斗,而是模型、推理、存储、芯片四个环节的系统性调优。

生态协作:从“搬模型”到“融体验”

从前芯片厂商和模型厂商合作,大致就是把模型量化一下,塞进芯片里跑通就完事。现在,这种合作深多了。

在这个新生态里,各家的角色分得很清楚:

  • 模型厂商(如阶跃星辰)提供“大脑”,负责智能核心。
  • 芯片公司这边,高通拿出的思路是当“底座”——靠NPU和软件栈,把模型压得更小、跑得更快、耗电更少。合作方式也变了味:不再是过去那种“模型+芯片”的简单拼装,而是走向“模型for芯片”或“芯片for模型”的深度定制。手机、PC、汽车这些终端厂商手里攥着“入口”,它们有操作系统、有用户数据,任务就是把芯片能力和模型智能捏成用户能感知到的功能。
  • 剩下的“长尾问题”落在开发者肩上。底层能力再强,也得落成一个个具体的App功能,才铺得开成千上万种使用场景。

进博会上的Demo就是个缩影。它说明的是一件事:终端侧AI的较量,已经不看谁的模型参数更大,而是看谁能把模型、推理、存储和硬件更好地揉在一起。

往后,这类能力会从手机蔓延到汽车、PC,甚至眼镜上。等设备真能本地完成意图理解和任务执行,对着屏幕点来点去或许就没必要了——直接告诉设备“我要做什么”,剩下的它自己办。这一天,比想象中来得要快。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 高通万卫星谈端侧MoE:20亿参数模型如何更聪明

    11月7日,第九届进博会现场,高通公司AI产品技术中国区负责人万卫星围绕终端侧AI的最新进展作了分享。他认为,经过3至4年的发展,终端侧AI正迎来一个重要的变化节点:从解决一个个具体任务的单点应用,走向更杂的智能体体验。高通公司AI产品技术中国区负责人万卫星万卫星介绍,终端侧AI并非从大模型起步,影像是较早落地的...

    来源 腾讯网
  2. AMD、高通、英特尔齐聚进博会:硬件厂商的智能体生意怎么走

    记者 任晓宁进博会3号馆技术装备展区,有一群展台面积不算大,市值却在全球位居前列的半导体公司。2026年进博会期间,这些公司不约而同都讲起了智能体的故事。智能体是今年火起来的概念,相比对话式AI,智能体可以帮人干活。软件公司的智能体,一般是一个能自主完成任务的AI程序,核心能力是规划、工具调用与记忆能力。硬件公司的智能

    来源 腾讯网
  3. 苹果Siri明年更像智能体:古尔曼曝AI升级时间表

    彭博社记者马克·古尔曼称,苹果最早可能在明年让Siri的功能“更像一个智能体”,但具体如何实现仍有待观察。他指出,Dots、Muse和Grok能持续跟踪目标、在用户无需逐条指令下推进任务,苹果最终也希望朝这一方向发展;古尔曼还称苹果CEO特努斯在闭门会议上要求加快软件路线图。

    来源 凤凰科技
  4. 高通安蒙:6G自设计起就是AI原生,2029年启动商用

    在本周的 2026 移动网络大会上,高通总裁兼 CEO 安蒙抛出一个判断:6G 从设计之初就将是 AI 原生的,AI 不再是外挂功能,而要融进网络本身。他的设想是,借助连接,上下文信息在终端、边缘与云端之间持续流转,AI 直接嵌入无线通信系统——系统不仅能估计信道状态,还能预测其变化,即便信号偏弱,也尽量保住性能。同时

    来源 AI 开发者社区
  5. Agent 越用越多,企业为何仍不够 AI Native?

    AI 生码率飙升,端到端交付却没有变快;通用 Agent 提效办公生产力,整体业务效能却未同步提升。当企业把 AI 工具推向业务流程,“局部更快、整体不快”的现象值得审视。阿里云智能集团副总裁、CIO 蒋林泉复盘了三年 AI 实践,从问题中找到了答案,也对 AI Native 有了清晰的认识。 AI Native,越热

    来源 AI 行业观察
  6. 进博会观察|算力向端侧下沉,芯片巨头竞速AI落地

    第九届中国国际进口博览会(下称“进博会”)已于11月5日在上海开幕。第一财经记者今日走访技术装备展区发现,尽管高通、三星、AMD、新思科技、SK海力士等厂商处于芯片制造产业链的不同环节,但参展商表达出的一致信号是:AI正从模型能力和单点技术展示加速走向行业和真实工作流,AI落地成为多家科技厂商的共同主线。AI加速...

    来源 腾讯网
  7. 鲁传颖谈AI入口之争:拒绝封闭圈地,呼吁共建共享

    随着大模型能力持续提升、开源技术加速扩散以及推理成本不断下降,AI发展的重点正在从技术突破转向实际应用。唯有坚持开放合作、互联互通、共建共享,才能让智能时代赋能更大范围的普惠发展 当前,人工智能(AI)正处于从技术突破迈向规模化应用的关键阶段。特别是随着智能体技术快速发展,AI正在从辅助人类完成特定任务的...

    来源 腾讯网
  8. 特纳斯施压费德里吉:苹果AI要更大胆,Siri转向自主智能体

    《科创板日报》11月9日讯 继杀入折叠赛道后,约翰·特纳斯(John Ternus)点燃了接任苹果CEO以来的“第二把火”。在AI赛道掉队的压力之下,其正向软件业务负责人克雷格·费德里吉(Craig Federighi)施压,要求在AI战略上采取更大胆的布局,致力于将Siri打造为可自主执行任务的AI智能体。据媒体报道

    来源 腾讯网
  9. 谷歌母公司押注AI芯片:豪掷5.48亿美元建仓高通

    快科技11月7日消息,Alphabet(谷歌母公司)最新提交的13F持仓文件披露,公司在第三季度首次建仓高通,购入297.7万股,持仓市值约5.48亿美元,占高通总股本不足0.5%,这笔新增持仓直接跻身Alpha

    来源 快科技
  10. Alphabet斥资5.48亿美元买入高通,AI芯片布局再落一子

    IT之家 11 月 7 日消息,路透社今天(11 月 7 日)发布博文,报道称谷歌母公司 Alphabet 在第三季度首次买入芯片巨头高通约 297.7 万股股票,持仓市值约 5.48 亿美元(IT之家注:现汇率约合 36.62 亿元人民币),约占高通总股本 0.5%。 根据美国证券监管文件披露,Alphabet 第三

    来源 AI 行业观察
  11. Airbnb AI智能体2027年上线:数百种旅行界面实时拼合规划行程

    IT之家 11 月 6 日消息,据科技媒体 neowin 今天报道,民宿出租平台 Airbnb 爱彼迎在 2026 财年第三季度报告中透露,公司正开发全新 AI 智能体,计划 2027 年推出,可帮助用户规划旅行。 Airbnb 表示:“我们的智能体并没有采用传统聊天窗口,而是调用带有数百种旅行专用界面元素的资源库,它

    来源 AI 行业观察
  12. AI Agent自主优化黑盒问题:统一评测平台AgenticBBO-Bench出炉

    你有没有想过这样一个场景:你要调试一个数据库的参数配置,上百个旋钮,调一个可能影响另外十个,而你每次试错的代价是等上几分钟甚至几个小时才能看到效果好不好。这就是黑盒优化要解决的问题。黑盒优化:一类优化问题的统称,目标函数你能评估它的输出,但不知道它内部的数学公式,也没法求导数,只能像摸黑一样不断试探...

    来源 腾讯网
  13. 腾讯云ADP升级:企业级Agent如何对经营结果负责

    当 AI 从个人办公助手走向企业核心业务,单纯的工具搭建已无法满足需求。腾讯云 ADP 通过全生命周期升级与 FDE 交付方法论,解决跨系统打通、权限治理及规模化落地难题,让 Service Agent 真正嵌入业务流程,对华润信托、伊利等企业的实际经营指标负责。

    来源 AI 应用前沿
  14. 美国人正在反抗,用史无前例的行动抵制AI

    起初,没有人在意这一场变革。 这不过是一次算法的升级、一张自动生成的插画、一个客服岗位的裁员、一家传统公司的倒闭。。。直到这场变革烧穿了电网、抽干了水井,和每个人的生活息息相关。 AI 泡沫破了吗? 破了? 没破? 如破。 就在周四晚,统治了全球资本市场整整两年的美股 AI 神话,迎来了一场史诗级的大崩盘。 印象中,差

    来源 AI 行业观察
  15. 苹果AI掉队焦虑:特努斯催费德里吉重做软件路线图

    【TechWeb】由于成本上涨剥夺了安卓手机的价格优势,苹果对安卓平台的侵蚀已不再担忧,真正危险的敌人换成了那些AI大厂。iOS 27.3版Siri虽能实现更多自动化任务,但与最强大的智能体相比仍相去甚远。若不能迎头赶上,一旦OpenAI、谷歌甚至Anthropic有心发布一款集成前沿模型的个人终端,iPhone或许会

    来源 腾讯网
  16. 美股AI神话一夜崩盘:纳指暴跌5.52%,英伟达跌9%

    起初,没有人在意这一场变革。 这不过是一次算法的升级、一张自动生成的插画、一个客服岗位的裁员、一家传统公司的倒闭。。。直到这场变革烧穿了电网、抽干了水井,和每个人的生活息息相关。

    来源 快科技
  17. 硅谷华人团队开源Comma:单入口调度多Agent并行,解决上下文瓶颈

    DeepSeek提出Super-agent概念引发关注,而硅谷华人团队AFK AI早在半年前就推出了类似架构的产品Comma并开源。Comma采用“单Router+多Worker”模式,用户只需在一个对话窗口下达指令,系统即可自动调度多个独立上下文的Agent并行处理代码、文档等任务。它支持跨应用协作(如微信、Line

    来源 AI 应用前沿
向下滚动自动加载更多