苹果人形机器人研究:宇树G1背着跑千问的Mac mini
终于不是后空翻、跳舞、跑步了
苹果新 CEO 最近对自家 AI 的进度有点不满意。
彭博社最新爆料称,苹果 CEO 约翰·特努斯已要求软件主管费德里吉加快 AI 开发节奏,拿出更大胆的方案,不能只满足于给 Siri 升级几个功能。
不过,比起苹果 AI 落地的速度,苹果在研究上的进展其实超出很多预期,具身智能就在其中。苹果也在研究怎么让 AI 拥有一副能在现实世界行动的身体。
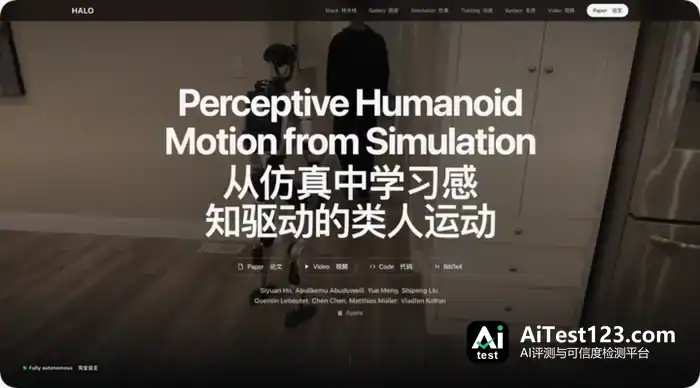
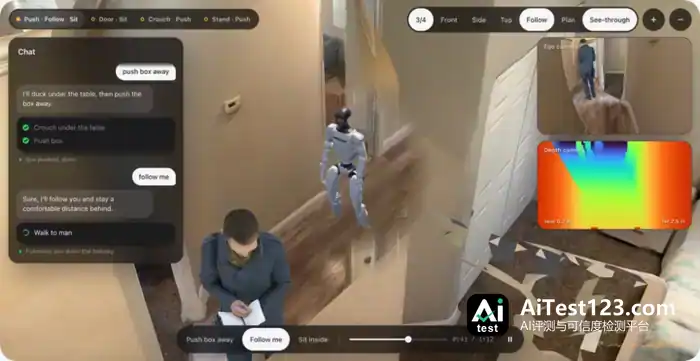
苹果研究团队近日公布了一项人形机器人研究,名字叫 HALO。它的身体直接用的是宇树 G1,后背上固定了一台 Mac mini M4 Pro,跑的是阿里的千问模型。
这套搭配看着有点杂,但已经能让人形机器人自己走进陌生的家庭,找到椅子坐下去、从桌子底下钻过去、把箱子推开。6 个此前没见过、也没提前扫描过的真实环境里,一共做了 360 次测试,平均成功率 91%。
更有意思的是,苹果甚至没有专门找人遥控机器人来采集这些训练数据。
研究团队用几百张 GPU,在上千个虚拟家庭中批量生成机器人的动作和视觉数据,再把学到的技能直接搬进现实世界。
这意味着,人形机器人原本需要人类手把手教的动作,现在开始有机会靠算力来学习。
[demo-1080.mp4]
教机器人坐下,得先拍到它看见了什么
我们听到「去椅子上坐」,一般会先看椅子在哪儿,然后走过去,转身,再把身体的重量落到座面上。
机器人要学这件事,得靠一种相当具体的训练数据。一条常见样本里,既包含它听到的指令和第一视角画面,也包含完成任务过程中全身各关节如何运动的记录。如果靠人来遥操作采集,每多一条样本,就得把同样的动作再做一遍。
这种配对机器人的数据叫做「视觉-语言-动作 Vison-Language-Action,VLA」,和训练大语言模型可以使用互联网上取之不尽的文本不同,现实世界中并不存在已有的 VLA 语料数据。
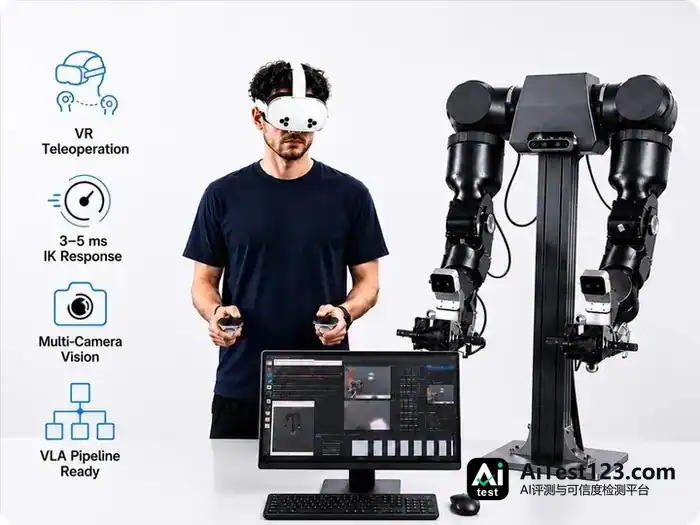
每条训练样本都得有人专门做出来:遥操作系统(如 ALOHA)、穿戴式动捕设备(如 UMI),产出 1 小时数据,至少也要耗掉 1 小时人力。人形机器人领域那个有名的「数据瓶颈」,说的就是这件事。
苹果的这篇论文 HALO 给出的方案是不采人数据了,全部用仿真合成。
团队的做法是:用运动扩散模型生成全身动作;用程序化生成器(INFINIGEN)造出 1000 个虚拟家庭,客厅、办公室、卧室都有,家具疏密随机;然后在 Isaac Sim 里把动作放进场景,渲染出机器人头部相机看到的第一视角画面;最后由自动校验器筛掉穿模、滑脚这类坏样本。
以坐椅子为例,研究人员先定下走过去、转身、坐下这几个阶段,还有最后坐稳的姿势。动作生成模型据此给出多组轨迹,程序再检查脚底有没有打滑、身体有没有穿过地面、关节有没有超出活动范围,筛过的动作会和椅子一起摆进虚拟房间,同时避开周围家具。
接着,仿真器从机器人头部摄像头的位置把这个场面拍下来。团队在约 1000 个程序生成的房间里,做出了 16.3 万条配对样本,合计近 300 小时,数据规模只受算力限制。
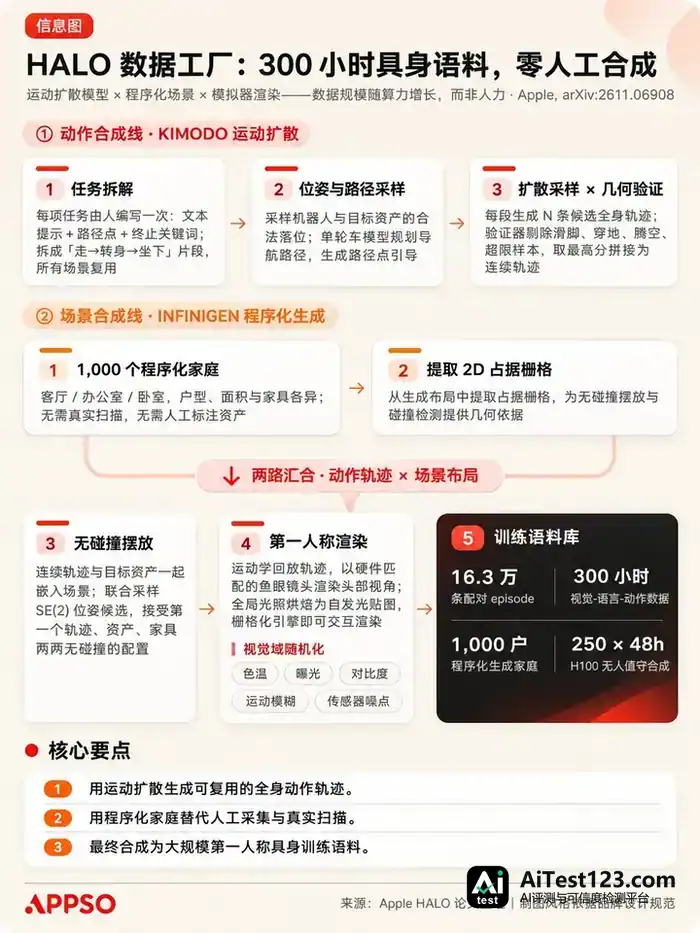
论文里还提到,仅生成 SIT(坐下)一个技能的 5 万条样本,就用了 250 张 H100 GPU 跑了 9 个小时;全部 1178 个房间的生成用了约 300 张 GPU、26 个小时。

房间的多样性本身也起了作用。研究团队保持动作数据量不变,只改训练场景的数量。在 100 个没见过的模拟房间里,坐椅子的成功率从只用 1 个房间训练时的 43%,升到用 100 个房间时的 81%;场景加到 1000 个,成绩又升到 84%。
苹果的机器人生态,跑在自己的芯片上
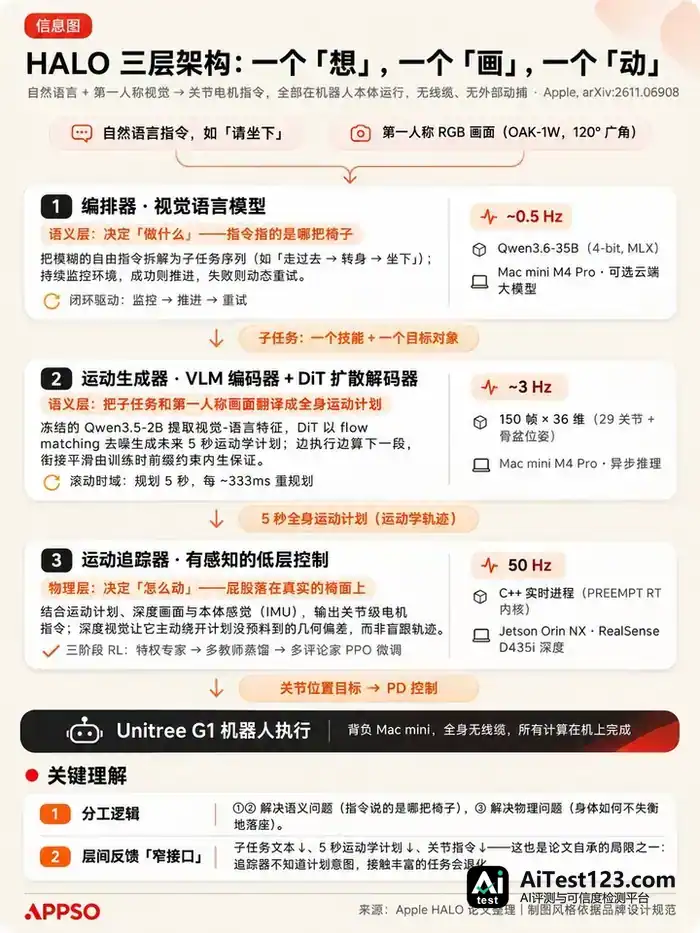
HALO 的自主性由三层结构协作完成,而且全部在机器人本体上运行,不联网、不遥控、不需要外置动捕。
- 编排器(约 0.5 Hz):一个视觉语言模型(默认是本地运行的 Qwen3.6-35B-A3B)每两秒看一次画面,能把「帮我把箱子推到桌子那边」这样的自由指令拆成子任务序列;
- 运动生成器(3 Hz):冻结的 Qwen3.5-2B VLM 编码器加上一个从零训练的扩散 Transformer 解码器,根据当前第一视角画面和子任务,生成未来 5 秒的全身运动计划,即机器人身上 29 个关节角度加骨盆位姿;
- 运动跟踪器跑在 50 Hz 上,融合深度视觉与本体感觉,把上层的运动计划翻译成实打实的关节指令。它的训练分三步走:先用特权专家训练,再做多教师蒸馏,最后用多 critic 强化学习微调。物理层面的问题,靠的就是这一层。
上面两层管的是“语义”,也就是指令指的是哪把椅子;最底下这层要解决的,是怎么让屁股稳稳落到椅面上,同时还不能摔。三层分工就这样拉开。
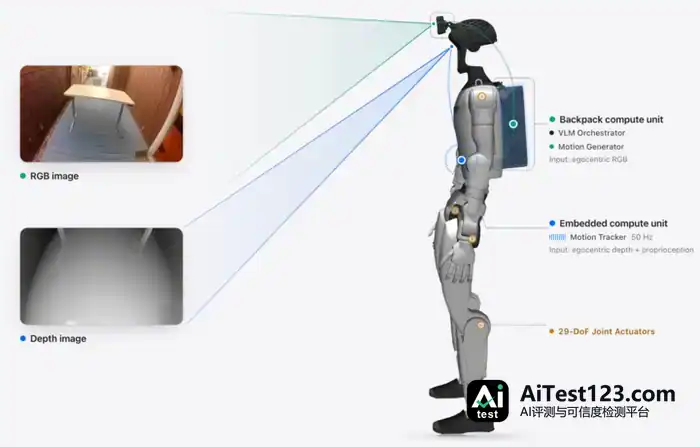
这套系统的看点在于软硬件的混搭:身体是宇树 Unitree G1,背上驮一台 Mac mini M4 Pro(64GB 统一内存)负责思考,机器人原厂的 Jetson Orin NX 管 50Hz 实时控制。头部装了一颗 120° 广角相机,全身无线、无缆绳,也不靠外接动捕。
背在苹果机器人身上的这颗“大脑”,也就是 Mac mini M4 Pro,跑的是阿里开源模型。编排器另留了调用云端前沿大模型的接口,一旦离线,就完全靠本地模型撑着。
供电方面,Mac mini 直接从宇树 G1 的内部电源总线取电,既没有独立电池,也没有单独的电源适配器。
真机跑起来时,背上的 Mac mini 先判断人指的是哪把椅子、当前该做哪一步。动作模型接住这一步,依据摄像头画面生成未来 5 秒的全身动作,每秒大约更新 3 次。
麻烦出在等待新计划的空档:机器人这时候可能已经抬起了一只脚。新计划要是上来就改掉落点,动作会猛地一顿。
HALO 的办法是异步推理加训练时的前缀约束。生成新计划时,旧计划里已经定下要做的半秒动作原样保留,只重算后面 4.5 秒。机器人能接着走,新计划也顺着已经起势的动作往下接。
再往下,G1 自带的 Jetson 芯片结合朝下的深度相机和身体状态,每秒给 29 个关节更新 50 次位置目标。上层计划里一句“坐下”,到这里才拆成膝盖弯多少、躯干怎么稳住的一连串动作。模拟坐椅子的测试里,拿掉这一层的深度输入,成功率从 84% 掉到 74%。
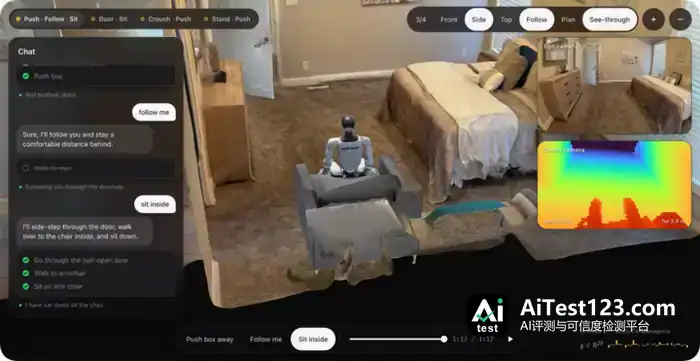
同类工作此前大多在提前扫描过的房间里做测试。HALO 的评测场却是 6 个训练中从未出现、也没扫描或建图过的真实家庭。
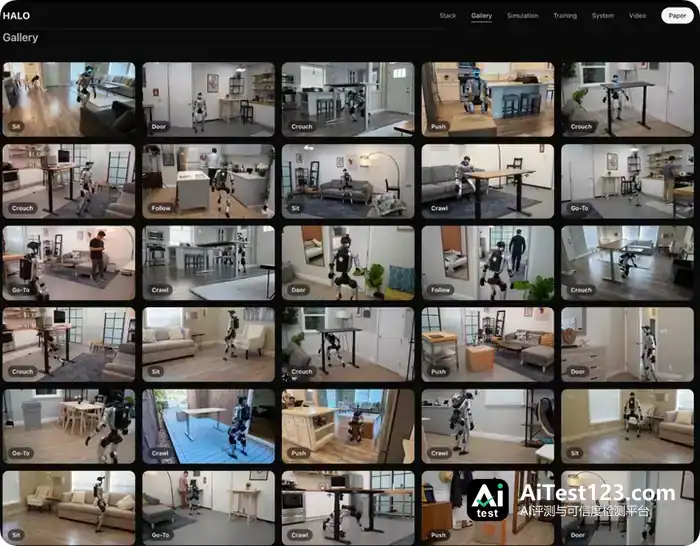
在这些环境里,机器人完成了坐下、走向指定物体、侧身穿过半开的门、蹲下或爬行钻过桌底、推箱子共 6 类任务,360 次物理试验平均成功率 91%,跟仿真里的 91% 分毫不差。
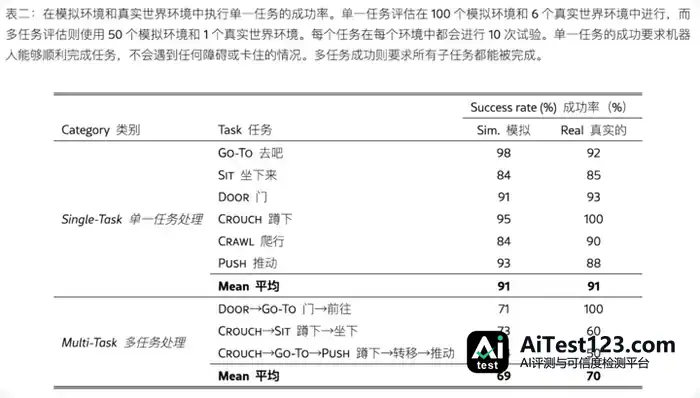
把技能串成组合任务,比如“钻过桌子→走向箱子→推箱子”,成功率就掉到约 70%。失败原因挺有意思:上一个动作收尾时机器人朝向不对,下一个目标压根不在视野里,被别的物体“带偏”了。论文里给的解法也简单,加一个“原地转圈找目标”的恢复行为就能缓解。
对照实验更能说明问题:训练场景从 1 个加到 100 个,成功率从 43% 蹿到 81%;再到 1000 个,升到 84%。
这不是苹果第一次出手
苹果 AI 虽然多次跳票,但翻翻过去两年的公开论文,它在具身智能上的路线已经逐渐清楚:
- 2024 年 11 月,ARMOR(与 CMU 合作):40 个低成本 ToF 雷达像皮肤一样铺满傅利叶 GR1 的双臂,专治人形机器人“看不见自己手臂”的遮挡难题,第一视角机载感知的路线就此立住;
- 2025 年 1 月,ELEGNT:那台刷屏的皮克斯台灯机器人,试的是“功能 + 表达”的运动设计,会点头、会凑近、会用灯光把人的注意力引过去,这也是苹果对消费级机器人形态的琢磨;
- 2025 年 5 月,EgoDex 与 PH2D:借 Vision Pro 采集了 829 小时第一视角灵巧操作数据,让人类教练戴着头显直接训练人形机器人。
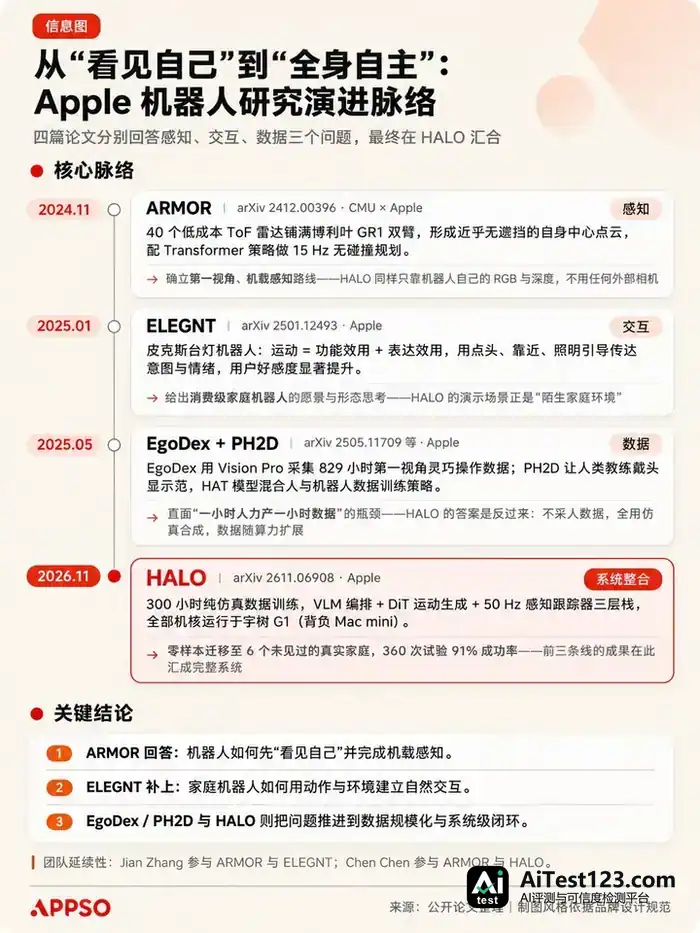
几条线到 HALO 这里像是短暂收拢:感知上延续第一视角的思路,场景上对准 ELEGNT 描绘的家庭,数据这个最关键的环节,苹果这次不靠人力采集,改押仿真。
当然,HALO 离真正走进千家万户的人形机器人还差得远。
眼下它会坐椅子、钻桌底、推箱子,可要它收拾一间乱糟糟的卧室,或者从冰箱里拿出一瓶饮料,要学的技能还一大堆。每加一项新技能,研究人员仍得手动设计动作提示和关键帧。
不过 HALO 至少说明了一件事:人形机器人学着跟真实世界打交道,可以有一条更容易规模化的路子。
过去想让机器人攒够 300 小时经验,得有人陪着练、跟着记。现在研究人员用几百张 GPU,一天多就能生成同样时长的训练数据,再把这些经验交给一个从没进过真实家庭的机器人。
更耐人寻味的是,苹果这回连自己的机器人身体都没有。宇树的 G1、阿里的千问、英伟达的 Jetson,再加一台 Mac mini,就凑成了这套能自主感知、自主行动的系统。
人形机器人的训练正越来越吃算力,往后这个行业的较量,可能不再只比谁的身体更灵巧,还要看谁能帮机器人把经验攒得更快、更省钱。