

TacitVLA:机器人边想边动,成功率不降反快3.4倍
现在的视觉-语言-动作模型喜欢先写一段文字再行动,虽然准但太慢。纽约大学和英伟达的研究发现,模型只要学过怎么写推理就行,不用真等写完。新提出的TacitVLA在保持高成功率的同时,把延迟降低了3.4倍,还在长程记忆任务上刷新了纪录。
机器人动手之前,为什么总要“三思而后行”?
看过最新具身智能机器人的人,大概都碰到过一个挺有意思的场面:还没伸手,它们先“唠叨”起来。桌上摆着个苹果,模型不是直接去抓,而是在内部先吐出一段话:“这是一个红色的苹果,位于桌子左侧,我需要伸出左臂……”
这套做法叫显式推理(Explicit Reasoning)。在视觉-语言-动作(VLA)模型里,它确实能把任务成功率往上抬——复杂的视觉场景被转成语言逻辑,模型理清思路更容易。可代价同样摆在明面上:慢。
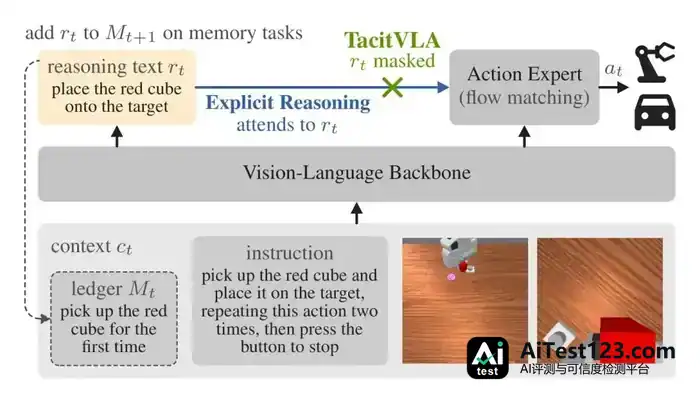
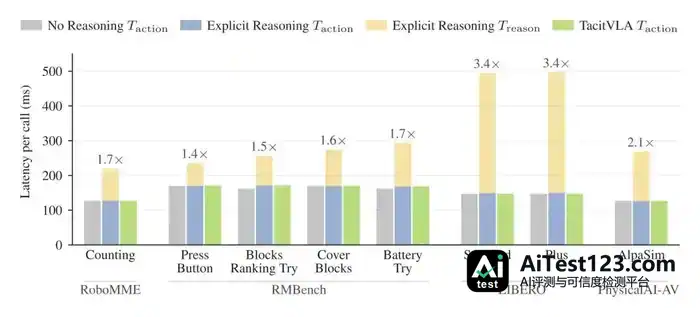
推理文本得一个token一个token自回归地往外蹦,字没写完,动作就只能干等。一项针对现有模型的测试显示,写推理文本这一步,占了单次模型调用时间的70%之多。放到自动驾驶或者精细操作机器人身上,几百毫秒的延迟足以酿成大问题。
于是疑问来了:推理带来的好处,到底是因为模型“读”了那段文字,还是因为模型“学”过怎么写那段文字?英伟达、纽约大学、UC伯克利等机构的研究团队盯上了这个点。他们的新论文《TacitVLA: Reasoning Vision-Language-Action Models Without Reasoning Latency》抛出一个反直觉的结论:模型只要学会推理的逻辑就行,运行时不必真把推理过程读出来。

顺着这个发现,团队做出了TacitVLA。训练阶段它和普通模型一样学着写推理,到了实际部署,动作模块对这些文本一概不理。结果有点出人意料:成功率没掉,速度快了3.4倍。
推理文本究竟起什么作用?
想弄懂TacitVLA新在哪,先得把推理文本在VLA模型中的三个角色拆开看。
其一,它是训练时的监督信号。模型被要求生成推理步骤,背后的视觉-语言主干网络(Backbone)就被逼着去学更深一层的场景理解。这种训练方式塑造了模型提取特征的路子,让它比只盯着像素看的模型更懂“语义”。
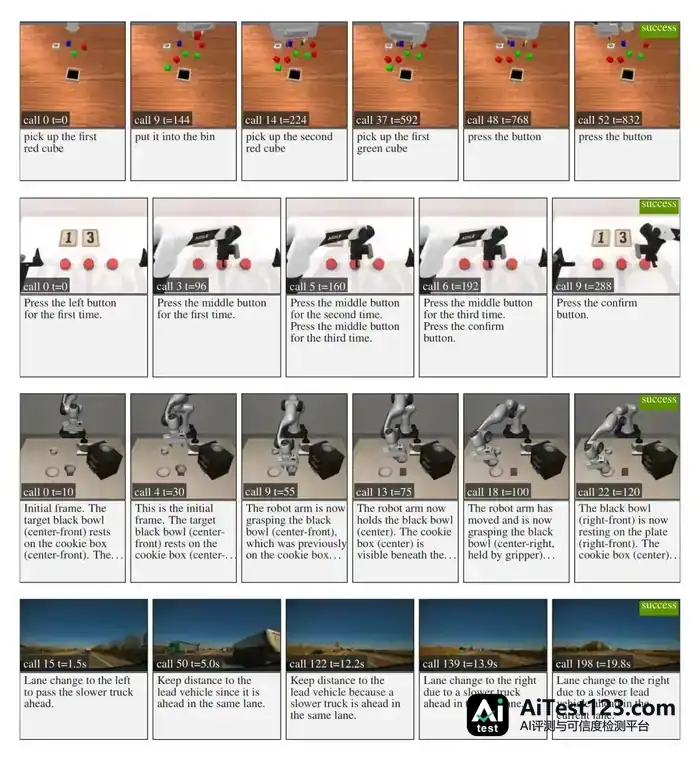
其二,它充当长程任务里的记忆载体。设想一个要连按三次按钮的任务,摄像头只看得见当前状态,之前按过几次它记不住。可模型要是能把“已按两次”写进日志,后面步骤就能把这个信息读出来。这个时候,文本就是外部记忆体。
其三,它是动作执行时的输入。传统显式推理模型里,动作专家模块(Action Expert)会读当前生成的推理文本,再据此定下一步动作。延迟正是从这儿来的:动作必须等字写完。
TacitVLA的核心洞察就落在这里:前两个作用缺不得,第三个作用却是多余的,甚至还拖后腿。团队给出的假设是,模型一旦通过训练掌握了推理逻辑,其内部表征已经装够了做决策的信息,用不着再靠读明文来“提醒”自己下一步干什么。
怎么证明“读了没用”?
为验证这个假设,研究人员搭了一组严谨的对照实验。他们选的是一种主流VLA架构:视觉-语言主干负责生成推理,基于流匹配(Flow Matching)的动作专家则通过注意力机制读取主干信息,再输出动作。
同一份数据集上,团队训练了三种策略不同的模型:
- 显式推理(Explicit Reasoning):标准做法,动作专家能读到刚生成的推理文本,对应现有的最先进方法。
- 无推理(No Reasoning):模型从没见过推理文本,直接在原始数据上训练,作为baseline,代表没有推理能力的情形。
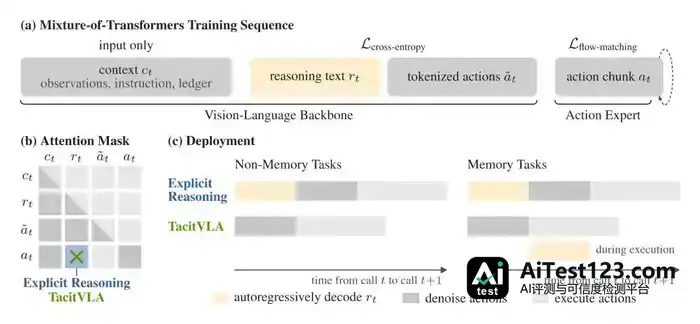
- TacitVLA:主角登场。训练时它用的序列、损失函数和提示词与显式推理一模一样,唯一动过手脚的是注意力掩码(Attention Mask)。掩码被改成这样:动作专家在生成动作时“看不到”推理部分的token。
这个设计把推理的两条潜在收益路径分得干干净净:一条是“学习写推理”对主干网络的优化,另一条是“读取推理”给动作模块补的上下文。显式推理两头都占,无推理两头皆空,TacitVLA只留前一条。
部署阶段,TacitVLA的处理逻辑也不复杂。任务不需要记忆,它就跳过文本生成,直接输出动作;任务需要记忆(比如记按钮次数),它先把动作算出来让机器人动起来,日志则放到后台异步写。日志写入是在动作执行期间并行干的,通常动作还没结束就写完了,所以不会多出等待时间。
实验结果:又快又准
实验横跨机器人操作与自动驾驶两大领域,任务里既有要长程记忆的,也有不需要记忆的。结论印证了团队的猜想:读取当前步骤的推理文本,除了拖慢速度,并不会把成功率抬上去。
机器人操作表现
在LIBERO-Plus基准测试中,模型要应付七种不同的环境扰动。TacitVLA拿到72.9%的成功率,跟显式推理的73.5%几乎打平,又把无推理模型的67.6%甩开一截。这两个推理模型的成绩,都超过了此前仅用LIBERO数据训练的已发表最佳结果。
标准LIBERO测试里,TacitVLA跑出98.6%的成功率,跟当前最高水平打平。
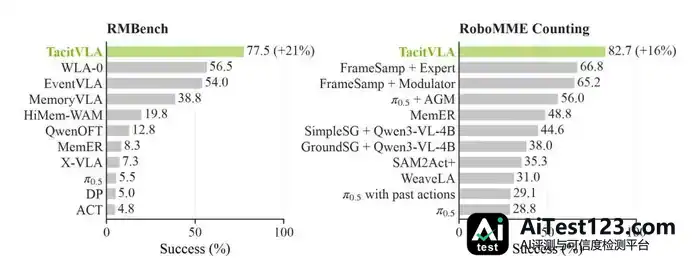
更值得看的是那些得靠记忆撑住的长程任务。RMBench基准上,它的平均成功率是77.5%,比显式推理的77.0%略高一点,把此前最好成绩56.5%甩开了一大截。以“Press Button”任务为例,按键次数只能靠日志记录,无推理模型在这里栽得很惨,成功率只有7.7%;TacitVLA靠异步日志机制把这个数字拉到74.3%。换句话说,只要记忆功能还在,拿掉实时推理读取并不会拖累性能。
RoboMME基准上它的表现同样不弱。用全部16个任务训练时,总体成功率48.1%,高于此前的44.5%。难度更高的计数任务里,TacitVLA拿到82.7%,此前是66.7%。如果只用计数任务做微调,成功率还能到89.5%,比人类参考成绩88.5%还高。这里说的人类参考,是由人挑选高层步骤、oracle planner执行具体动作的设定,而TacitVLA是端到端自己把动作全做完。
自动驾驶表现
AlpaSim封闭场景的闭环驾驶测试中,TacitVLA场景得分52.5%,和显式推理的52.3%几乎一样,明显高过无推理模型的46.4%。它的参数量不到对比模型Alpamayo-R1的一半,摄像头数量也只有一半,这个成绩算得上划算。
速度提升显著
速度才是TacitVLA最突出的地方。单张H100 GPU上处理LIBERO任务,它输出一个动作只要147毫秒,显式推理要495毫秒,慢了3.4倍。放到自动驾驶场景,TacitVLA耗时127毫秒,显式推理是269毫秒。
就算是需要写日志的记忆任务,TacitVLA也比显式推理快1.4到1.7倍。日志写入最多占掉动作执行时间的23%,而且完全并行,用户感觉不到延迟。
这意味着什么?
TacitVLA一出来,等于给眼下火热的“推理型VLA”浇了盆冷水,也指出了一条更务实的路。
前一阵业界普遍觉得,模型得学人那样把思考过程说出来,才能做出对的决策。这项研究给出的结论不一样:对机器来说,“内化”的推理可能比“外显”更高效。训练阶段生成推理文本时,模型已经学会了怎么结构化地看懂场景、规划步骤,这种能力沉在神经网络权重里,每次推理不必再生成文本、读一遍来反复确认。
落到实际部署上,这件事分量不轻。机器人和自动驾驶领域,延迟常常直接决定系统能不能用。3.4倍的速度提升,意味着同样的硬件能撑起更高频率的控制循环,或者把算力成本压得更低。
而且TacitVLA实现起来很简单,不用加额外的模型组件,也不用复杂的调度器。任何采用类似架构的VLA模型,训练时把注意力掩码调一下,让动作模块看不到推理token,就能立刻变成TacitVLA。成本这么低的改法,很可能很快被搬进现有的具身智能系统。
当然,推理文本也不是没价值。需要跟人交互、解释决策过程,或者处理特别复杂、得多步纠错的任务时,显式推理照样有用。但对大多数追求实时响应的常规任务来说,TacitVLA证明了一件事:完全可以做到“心中有数,手下不停”。
这项研究的第一作者是纽约大学计算机科学博士生Jack Lu,主要工作在英伟达实习期间完成。论文由英伟达资深研究科学家Yan Wang和斯坦福大学副教授、英伟达自动驾驶研究负责人Marco Pavone指导。具身智能正从实验室往工厂和家庭走,怎么在智能与效率之间找平衡,会是接下来几年的核心议题。TacitVLA给的答案很简洁:有时候,少说多做才是最好的策略。
















