无界前沿开源Fx-Bio-1031:生信盲测超GPT-6与Opus-5
无界前沿正式开源生物信息大模型Fx-Bio-1031。该模型采用125B参数MoE架构,支持本地私有化部署,确保数据不出域。在Anthropic发布的BioMysteryBench困难子集测试中,Fx-Bio-1031取得70.59%的Pass@5成绩,显著高于GPT-6-Astra和Claude Opus-5。模型具
硅谷在生命科学上砸得起劲,到了国内落地,却卡在“最后一公里”
这半年,全球顶尖AI实验室在生命科学方向的动作密到让人缓不过气。4月,OpenAI拿出专为生命科学打造的GPT-Rosalind,随后很快迭代到基于GPT-5.5的版本;5月,Google推出Gemini for Science;6月,Anthropic上线面向科研人员的Claude Science工作台。
从底层模型到评测基准,再到科研工作台,巨头们摆出的是全栈布局。可这股浪潮落到国内,研究者和开发者面前横着两个麻烦。
头一个是闭源和数据安全。 GPT-Rosalind这类海外模型大多不开放权重,还依赖云端API。医院、药企、高校课题组手里,核心临床数据和组学数据“绝不出境、绝不出域”是红线,直接调海外服务,合规风险摆在那儿。
再一个是通用模型的“纸上谈兵”。生物信息学任务动不动就是数百万行测序数据、标签缺失的实验样本,加上复杂的多步统计检验。通用大模型背医学术语没问题,可真进了Linux命令行环境,面对原始噪声数据,常常因为调不对工具、写不出脚本而报错崩溃。
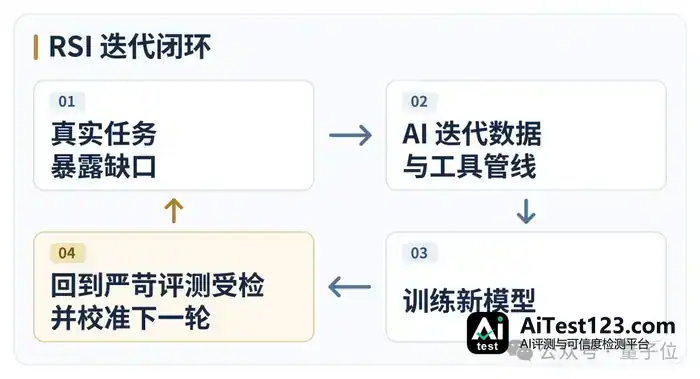
垂直领域的RSI(递归自我改进)模型想的就是这个事:让模型直接走进命令行,自己写脚本、调数据库、做交叉验证。今天,无界前沿把生物信息大模型Fx-Bio-1031开源出来,给这条赛道添了一个新的开源选项。
成绩单:在人类专家都头疼的深水区,差距拉开了
一个AI到底懂不懂生物信息学,不看它能不能背出教科书上的定义,要看它在真实沙盒环境里能不能把复杂分析做完。
Anthropic发布的BioMysteryBench基准测试就是冲这个来的。测试里,模型没法靠检索现成结论蒙混过关,而是被扔进真实的生物数据和Linux工具环境,做全基因组测序、单细胞转录组、染色质开放性分析这些任务。它得像真正的计算生物学家那样,翻原始文件、去NCBI和Ensembl捞注释、写多步统计脚本,走不通还得推翻重来。
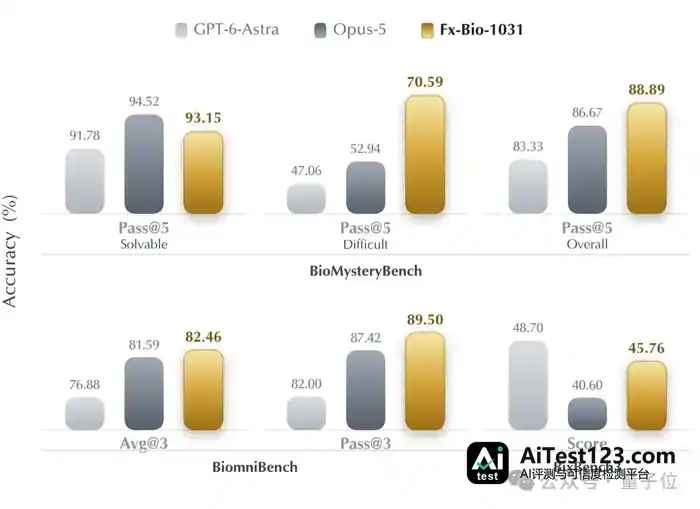
统一的智能体评测框架下,Fx-Bio-1031的表现值得看一眼。Difficult(困难子集)上,它拿到70.59%的Pass@5。同一框架里,GPT-6-Astra是47.06%, Claude Opus-5是52.94%。Fx-Bio-1031分别高出23.53和17.65个百分点。
到了考察复杂科学分析全流程能力的BiomniBench,Fx-Bio-1031的Pass@3达到89.50%。
所谓“困难子集”,指条件残缺、信噪比极低、要几十步长程推理的那类题。题目落在人类专家可解子集里时,顶尖模型都在90%以上,拉不开差距;一进深水区,通用模型的通过率常常卡在50左右,Fx-Bio-1031则稳得多。
五大场景:从药物研发到实验排障
跑赢基准只是头一步,真正值钱的是模型能不能进实际科研流程。靠着工具调用能力和本地沙盒运行环境,Fx-Bio-1031主要面向下面五类应用场景。
药物研发与临床肿瘤队列挖掘
在本地私有化部署的环境里,药企需要分析大批患者临床测序队列。基因共突变与互斥分析、耐药机制排查、患者亚群分型,以及生存关联复核,这几项都由 Fx-Bio-1031 承担。一旦有新一批临床样本入组,全套管线模型可一键重跑,十余项敏感性分析也会自动完成。过去生信团队要排期数周才能做的靶点立项调研,如今被压缩到小时级。
多组学联合分析与分子机制拆解
面向高校和科研院所,模型覆盖全基因组、常规转录组、单细胞转录组、表观遗传学及蛋白质组学数据。从启动子区域甲基化变化筛选,到基因表达关联分析与功能通路富集,原始矩阵清洗、统计检验、发表级图表与报告生成,整条证据链它能端到端跑通。
病原微生物溯源与宏基因组挖掘 碰上匿名的临床分离株或者海量环境宏基因组数据,模型能自动完成底层FASTQ/MAF脏数据质检与修复,准确鉴定病毒或细菌物种及血清型,并在复杂背景噪声里锁定抗性基因或新型防御系统信号。
实验异常排查与审稿补实验 湿实验出了样本标签混淆、批次效应干扰,或者期刊审稿人对统计口径提出严苛质询,研究员可以把问题和数据一起丢给模型。模型联动NCBI、Ensembl、COSMIC等公共数据库交叉验证,快速做完盲测溯源与补充实验。
生信自动化Agent底座开发 借助512K超长上下文和强化的工具调用能力,开发者能把Fx-Bio-1031接进科研智能体工作台或企业内部LIMS系统,搭出能自己写代码、装软件、诊断报错并交付可审计报告的自动化生信流水线。
三个现场:看懂它的“恐怖执行力”
要说Fx-Bio-1031怎么解决实际问题,看三个具体的运行现场就够了。
现场一:算出结果后,主动给自己做14项压力测试
药企研发抗癌药,最头疼的就是“假阳性”。两个癌症基因看着“水火不容”(互斥),可只要换一套筛选标准,结论立刻站不住脚。
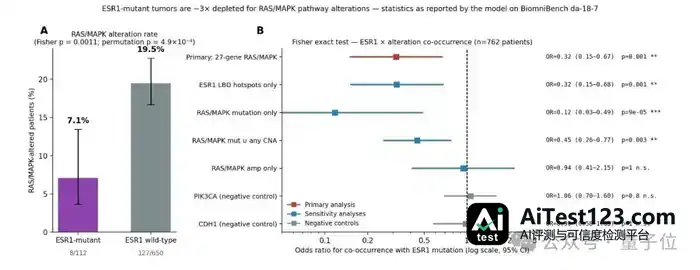
乳腺癌临床队列那道题,要查的是内分泌治疗后HR+/HER2−患者体内ESR1突变与RAS/MAPK通路变异的关系。Fx-Bio-1031先啃1,918份杂乱的样本记录,去重之后锁定762名独立患者,给出核心结论:ESR1突变患者的通路变异率只有7.1%,野生型患者则是19.5%。换一般模型,p值算完就交卷了。它没有,转头对自己的结论发起14项敏感性分析:把突变范围收紧到特定热点区域,剔除拷贝数变异只看点突变,还拉进PIK3CA和CDH1两个基因做阴性对照。最后交出的不只是显著性结论,还有一张“结论边界地图”——哪些严苛设定下结论依然成立,哪些情况下统计显著性会消失,写得明明白白。
现场二:9份撕掉标签的样本,靠跨库推理“盲测破案”
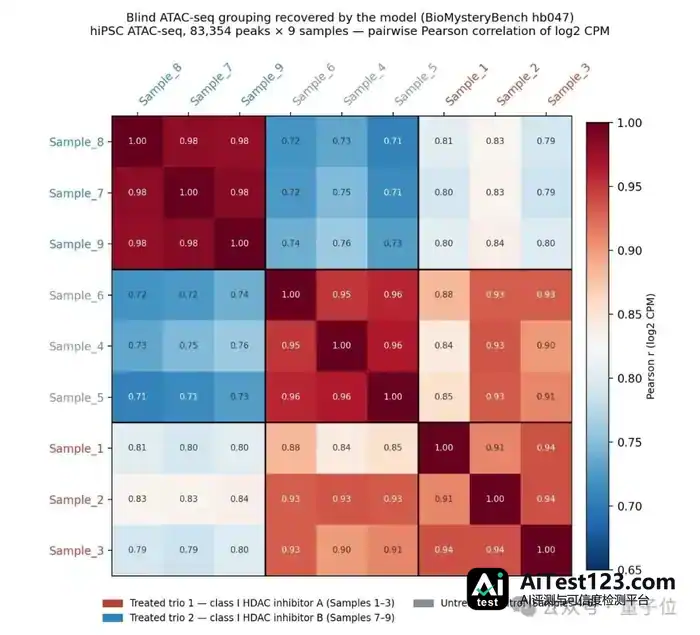
进入Anthropic BioMysteryBench的高难盲测题,模型拿到的是9份没有分组标签的人源诱导多能干细胞ATAC-seq测序样本。唯一线索:6份用过两种class I HDAC抑制剂处理,另3份是未处理的空白对照。没标签怎么认?Fx-Bio-1031先向内找结构,过滤低信号噪声,算出9份样本两两之间的相关性,干净利落地聚成三组。可真正的难题在后面——哪一堆才是没加药的对照组?
这一步,模型跳出当前文件,主动调取基因组注释和公开的HDAC抑制剂已知转录响应数据,把开放峰关联到基因,拿“外部已知的生物学响应方向”当标尺,再逐峰位移比较,最终还原出两组药物处理组与一组空白对照的身份。
现场三:206万个变异,连底层Bug都逃不过眼睛
Fx-Bio-1031还碰上过另一道硬题:输入直接甩来2,700个肿瘤样本、206万个单核苷酸变异,参考库不给,算法也不指定,要求找出乳腺癌队列合并统计下贡献最高的COSMIC SBS突变签名。
它在本地测试环境里解析突变矩阵,做非负最小二乘数学拟合,调起官方工具交叉验证,再跑200次Bootstrap抽样和跨版本复核,76步分析操作走完,答案精准锁定。
更有意思的是细菌测序分析那次。启动分析前的底层数据质检中,模型抓出一个极其隐蔽的工程Bug:R2测序文件最后一条记录里,碱基序列长度和质量值长度根本对不上。它自己写脚本剔除这条损坏记录,随后调用专业工具SeqSero2完成预测,全程连续跑完258步,交出的交付报告完全可追溯。
底层引擎:三层RSI进化飞轮
能在这么琐碎、硬核的专业领域里露出老练研究员般的直觉,靠的是背后的RSI(递归自我改进)机制。无界前沿把这套打通“评估—数据—环境”三层闭环的底层引擎叫作RSI-OS。
评估层由团队联合深势科技BioMaster团队搭建,围绕生物信息分析中的典型任务构建内部独立验证体系。在包含模型、工具与沙盒的完整系统里,114道内部自建复杂任务独立跑三轮,重点看模型在数据处理、工具调用、多步分析和结果复核中的表现。
数据层上,AI深度参与训练任务的生成、求解和审查。系统依据内部独立验证集暴露出的通用能力短板,在公开合规的科研文献与真实生信工作流上自主演化训练轨迹。所有外部公开基准一律作为零接触的最终盲测考卷,不参与任何训练。
环境层则让模型在迭代中不只学知识,还动手编写与修复生信分析脚本;配合持续演进的智能体运行框架,下一轮模型做任务时的“武器库”和执行环境也跟着变强。
生物信息学的文献杂、数据碎、推理链长,代码执行结果和统计检验又能复查重算,天然适合拿来演练RSI飞轮。
开源细节:125B参数MoE架构,支持本地部署
无界前沿今天正式开放Fx-Bio-1031的完整模型权重。该模型基于Qwen3.8-Flash-Next做深度RSI后训练,采用总参数量125B、每token仅激活6B参数的MoE架构。激活参数规模低,推理时所需计算量相对可控,推理成本也就压得下来。医院科室、高校课题组与药企不必上马天价算力集群,在本地机房就能私有化部署,从物理源头守住数据安全红线。
发布配置原生支持512K上下文窗口,超长工具调用轨迹、多篇完整文献、大规模组学统计输出都吞得下。模型权重、分词器、处理器配置与生成配置均已开源,协议为Qwen Community License 1.0。
无界前沿由中国 科学院院士发起,上海交通大学、上海算法创新研究院和深势科技联合孵化。创始团队汇集高校和产业的顶级研究者与工程师,核心成员曾带队研发科学基座大模型Innovator和通用科研智能体SciMaster。
对手握组学数据的课题组或研发团队来说,想复核关键生物学关联、排查诡异的实验分组,或者把高频使用的生信分析管线彻底自动化,如今多了一个可本地部署、可审计的开源选择。