联想万全混合词元工厂落地张家口:15000P集群,年产2000万亿Token
年产2000万亿Token,成本狂降70%
杰西卡 发自 凹非寺
卡买得起,AI却用不起。这话听着有点离谱,可AI大规模进企业之后,不少公司确实卡在这种尴尬里。
AI产业这两年的增长,几乎只能用狂飙来形容。国家数据局数据显示,我国日均词元调用量从2024年初的1000亿增至2025年底的100万亿,2026年3月突破140万亿,两年增长千倍;中国信通院披露,到2026年6月,相关指标已突破500万亿。
需求暴涨很快传到了算力供给端。模型不断进化,Agent逐渐接手复杂任务,Token需求激增,算力基础设施也随之加速扩张。IDC预计,2026年全球服务器市场收入将达到约6851亿美元,AI基础设施投资是主要增长动力。
不过,算力供给一直在加,企业对“烧Token”这件事反倒越来越谨慎了。
图片由AI生成
《经济观察报》的报道提到,一家中型银行上半年花在Token上的钱接近900万元,占其上年度IT预算的8%。年初,Token消耗量上涨还被当成AI真正渗入业务的利好信号;可到了6月底,管理层却提出要重新算一算这笔投入的成本收益。
麦肯锡的一项调查也显示,约五分之一的受访者表示,所在组织因AI运营成本而限制了AI使用。
企业开始算AI的成本与实际产出了。原因也不难理解:Agent执行复杂任务可能持续数小时,反复推理、模型调用和任务重试都会累积成本;自建算力就得为业务高峰预留设备,平时闲置,折旧、电费和运维开支也照付不误。
更麻烦的是,钱未必花在了刀刃上。简单任务用上昂贵模型,敏感业务又必须留在私有环境,算力很难各归其位。
所以,企业真正把AI用好、用得起,还是个亟待解决的问题。
河北张家口是塞北的风口,谁也没料到,这里要立起一座混合词元工厂。按规划,它是一座15000P超节点集群,年产2000万亿Token。11月10日,联想集团在张家口正式发布“联想万全混合词元工厂”品牌。
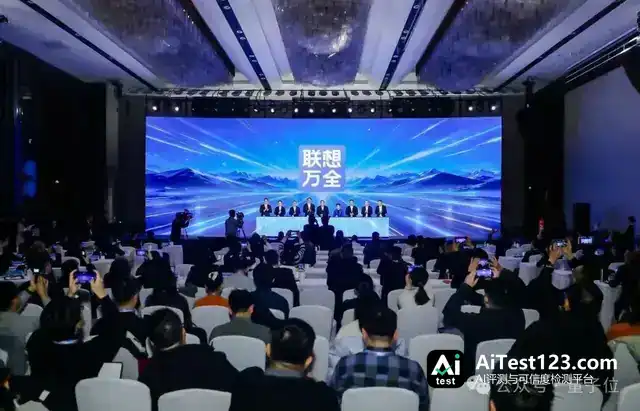
和单纯交付服务器或销售计算资源不同,该工厂计划把不同来源的算力与模型组织起来,持续生产更经济、更高效的Token服务。生产逻辑甚至称得上直接粗暴:绿电进,词元出。
自此,粗放堆芯片的时代,开始转向工业化量产高性价比Token的时代。算力基础设施的底层规则,恐怕要一夜变天了。
绿电进,词元出
当天,联想集团和河北张家口市政府签署合作协议,将推进首座混合词元母本工厂在张家口落地。按照最新披露的方案,项目首期规划建设15000P异构算力集群、约100MW智算中心,建成后Token年产能力预计达到2000万亿,峰值产出能力达到每秒2亿Token。
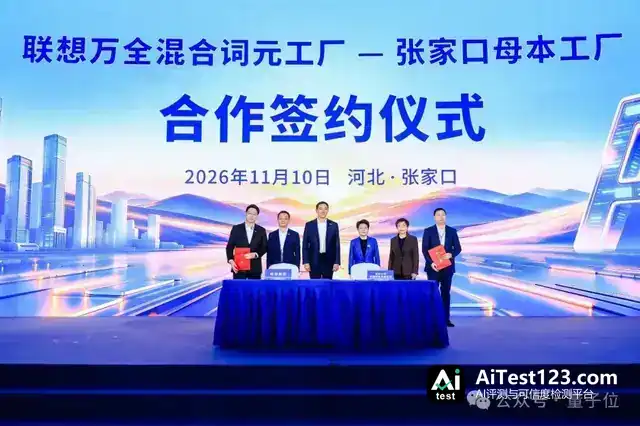
联想集团高级副总裁、中国方案服务业务群总经理戴炜在现场说,首期建设时间表定在2027年;到2030年,相关规模计划再扩大10倍及以上。
2000万亿的年产能,到底是个什么量级?
折算下来,一天大约能产出5.5万亿Token。这还只是粗略换算,规模之大已经可见一斑。
规模之外,工厂的名字更引人琢磨。
词元工厂算不上新提法,此前已有不少产业尝试:有的从芯片和服务器能效入手,有的做模型平台运营,还有的专攻智算中心。路线各有侧重,可企业真正用起AI来,碰到的常常是多种计算需求叠在一起。
联想的词元工厂,特殊之处就在“混合”这两个字。所谓混合,要害是让算力供给随业务需求而动。
企业一方面要稳定、可控的私有算力,另一方面又会遇到突发的公共调用;任务不同,对模型能力、响应速度、成本的要求也相差很远。
只把算力规模做大,或者只优化Token生产的某一环,都撑不起全部问题。
联想拿出的混合供给,扮演的是枢纽角色:把原先散着的资源重新归拢,私有Token与公共Token服务并用、以私有为主,端侧、边缘、云端协同运转,不同模型按任务需要灵活挑选。
这样一来,算力供给跟着业务需求走,不再由硬件配置一锤定音。
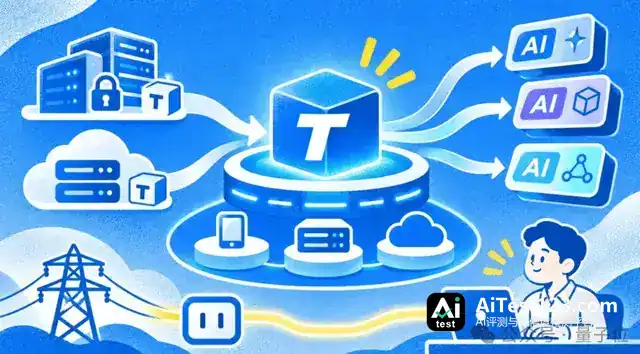
图片由AI生成
理想的Token供给应当像用电一样。企业按需接入,拿到稳定、经济的服务;背后跑的是什么设备、调的是哪种模型、资源怎么调度,都归统一的供给体系管。
不过,要让不同资源在同一套体系里配合运转,光有模型和服务器不够。计算设备、机房运营、能源供给、模型调度,都得一起算进去。
靠什么保障?
联想选中的是离北京最近的一个“风口”——河北张家口。
叫它“风口”,首先是因为当地难得的能源条件。
张家口是全国风光绿电第一大城市,也是国家六张网(算力网+新型电网)的标杆型双节点;截至2025年底,当地可再生能源装机规模突破4500万千瓦,占电力总装机的比重接近九成。
其次,这里的算力底子也相当厚。
张家口是国家“东数西算”工程京津冀枢纽的重要承载地,当地政府还在积极给政策、做产业引导。目前当地已建成50多座数据中心,投运标准机架超过107万架。
塞北的风光资源丰富,气候冷凉,电价更有优势,又紧挨北京(距京一百多公里)、时延更短,正好压降算力运营成本,接住京津冀的AI推理需求。
图片由AI生成
政策层面其实也在推着算力产业往高效供给转。
《“十五五”规划纲要》今年发布,其中明确:算力要朝规模化、集约化、绿色化、普惠化方向推进,绿电与算力要协同起来,中小企业用算的成本也得降下去。
于是联想与张家口当地合作,摸索出一种更“端到端”的产业模式:绿电进,词元出。
听着像工业流水线。可跟传统工厂不同,Token生产线不光要稳定的能源和设备,还得随千差万别的任务需求,随时调整生产方式。
那么,处在不同位置的算力、具备不同能力的模型,要怎么才能真正配合起来,为企业所用?
让每一分算力都花在该花的地方
可以设想这样一个场景:一家制造企业大规模用上了AI,日常可能会碰上这种情况:
生产系统得稳定运行,敏感数据不能离开私有环境;可办公助手、客服智能体这类应用,又可能在业务高峰时突然涌来大量请求。
要是全部自建算力,就得为短暂的峰值长期养着设备,开销很大;如果完全购买公共服务,数据边界、持续支出和模型适配这几关又绕不过去。
再说,整理简单文档和做复杂专业推理,本来也不该用同样昂贵的配置。不同任务,显然需要不同的算力供给方式。
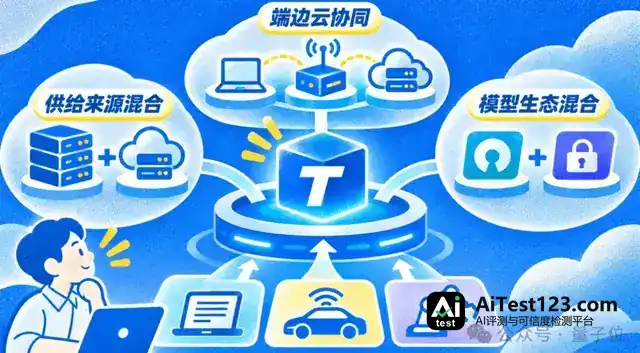
沿着这个思路,联想拿出的方案是混合供给模式,分为三个维度:
- 供给来源上混合,让私有自产的Token与获得授权的公共服务互相补充;
- 端边云协同,轻量任务留在端侧,时延敏感的任务就近运行,弹性需求则匹配到云端;
- 模型生态上混合,按质量与成本要求,在开源权重和专有闭源模型之间做选择。
图片由AI生成
可选的路子多了,真正调度起来反而更复杂。
比如任务涉不涉及敏感数据、要多强的模型、能等多久、公私资源怎么配比,这些都得综合权衡。公私资源分配尤其如此,两类负载的性质正好相反:常驻企业内部的要稳,数据不能越界;随外部调用起落的要省,能跟着峰值伸缩。
为此,联想做了Token Engine(词元引擎),靠模算动态混部、任务级资源池调配和智能模型路由,把资源匹配的效率提上去。
而要让调度真正覆盖私有与公共资源,还得有一套统一的管理体系。
联想此前布局的xCloud联想智能云正好能担这个角色。私有云和公有云资源,它都能统一纳管、调度,并做智能运维,让分散在不同环境里的计算资源协同起来。
在此之上,xCloud里还配了Token Hub(词元中枢)。它进一步面向AI推理场景,通过模型路由和推理资源池的动态调配,把任务需求、模型质量、数据边界、响应时延与成本放在一起考虑,为不同请求找到合适的模型与算力。
这样一来,原本分散的资源就能按业务需求灵活组合。调度的精细程度,甚至能深入到芯片和计算节点。
联想集团副总裁、全球基础架构和智能云总经理姚振宇举例说,轻量模型可以跑在较小的计算节点或边侧资源上,不必占用大型集群。
换句话说,调度不只是找一台空闲机器,还能让任务用上合适的模型和芯片;计算资源被充分利用,每一分算力都花在了刀刃上。
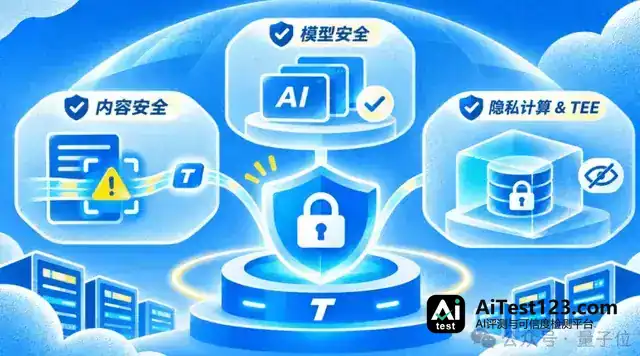
另外,考虑到数据安全合规,联想还设了三个维度的屏障:
第一是模型安全,所有模型都要通过安全测试认证、进入白名单,才能在词元中枢上供企业使用。
第二是内容安全,联想设置了Token Trust词元安全能力,在传输路径上主动拦截敏感信息,把数据安全和使用权限定为资源调度必须遵守的边界。
第三是隐私计算与TEE(可信执行环境),联想支持企业把隐私、敏感数据放到隔离的可信环境中处理,平台侧读不到内容,只有获授权的用户才能使用,也就是业内常说的“可用不可见”。
图片由AI生成
调度做得再细,设备和机房本身的成本也压不下去。联想为此又提了三级优化思路。
头一级,是把算力设备的效率提上来。
问天异构智算方案里,超节点、多芯多模训推引擎,加上集群通信与算子优化被联想捏到了一块儿,目的就是让异构计算资源配合得更顺。
联想披露的数据是,这套方案能带来30%以上的算力效率提升。集群规模一大,少一些等待和闲置,能多榨出来的算力就相当可观。
第二级落在智算中心的全生命周期成本上。
服务器只是其中一块,供电、制冷、建设、运维哪样都不便宜。联想把模块化预制、一体化全液冷、绿电直流智控这些手段用上,让机房建设和日常运营放在一起做优化。
联想还打算在张家口建一条算力设备回收与再利用产线,把存量设备的价值用得更久;配套智算中心给出的目标则是PUE低于1.1。
第三级针对业务场景做Token效能优化。模型路由加上资源池动态调配,简单任务不用去占高成本模型,突发需求也能配上合适的计算资源。
硬件、机房、词元中枢各管一段,各段省下的资源和成本加在一起,最后落到企业用AI时的效率上。联想给出的核心主张就是“释放算力的每一分效能”。
对企业客户负责之前,联想先拿自己的业务试了一遍。姚振宇透露,靠内部AI实践,公司已经做到约70%的综合成本优化。
混合词元工厂的整体目标也已摆出:百万Token综合成本优化70%,每秒Token产出量提升5倍,Token良品率超过99.9%。
不过,词元工厂的效率不能只拿成本和吞吐量来说事。
产能再高、成本再低,响应速度和模型质量也得守住。企业内部的敏感数据尤其如此,安全不能在降本时被牺牲掉。大型智算中心的能耗,同样是左右长期运营成本的大头。
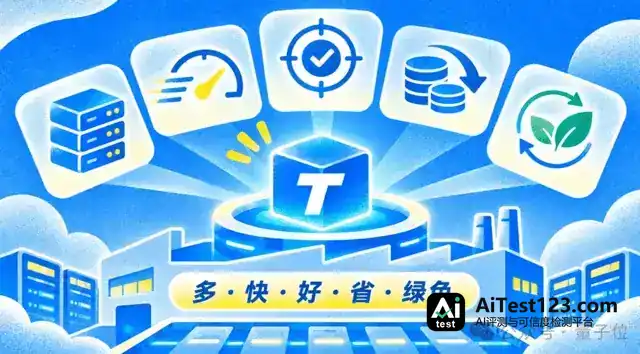
所以除了综合成本和Token吞吐,联想把任务完成精准、绿色可持续、全链路安全也算进考核,合成词元工厂的五大核心竞争力。
图片由AI生成
按联想的说法,这五个字是“多、快、好、省、绿色”。
“好”这一项更值得琢磨。同样让Agent干活,一套系统一次就交出合格结果,另一套要反复改、反复推理,后者就算烧掉更多Token,也谈不上创造了更多价值。
联想给这种情况起了个直观的名字——有效Token。
对一家企业而言,Token产量和百万Token单价当然要看,可抛开实际任务的完成质量,性能指标再好看,也难讲清AI到底带来了多少实打实的价值。
把一座工厂,变成一套方法
“各自都没错,整体却出了问题”,姚振宇说他见过不少这种场面:
企业IT系统一出故障,硬件、数据库、平台供应商都能自证清白,可根源就是查不出来。
AI系统牵扯的环节越多,这类麻烦只会越明显。
分散的能力怎么重新拧成一股绳,正是词元工厂要过的坎。
联想从动手做词元工厂第一天起,看中的就是这个机会。
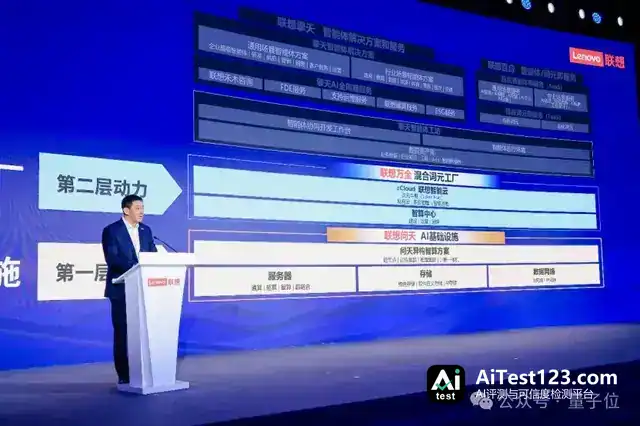
这家在多个技术环节都有积累的硬件老大哥,把自家企业AI业务装进了一个叫“三层混合动力”的框架:
- 最底下是问天AI基础设施,服务器、存储、网络和异构智算平台都在里头;中间一层是这次发布的万全混合词元工厂,干的是把计算资源变成能持续供应的Token服务;最上面摆着擎天、百应等智能体方案和服务,直接对接企业的实际应用。
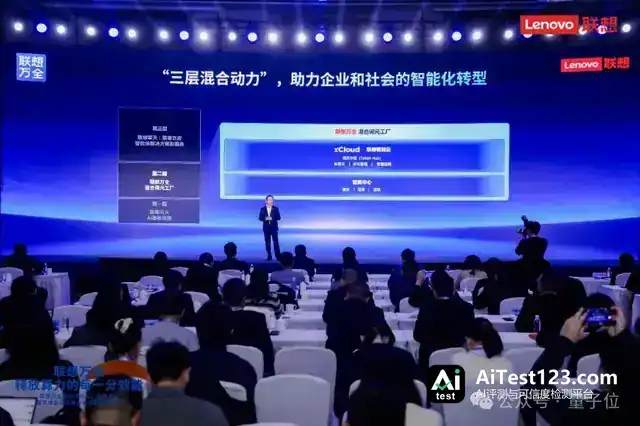
三层能力串起算力生产、Token供给和业务使用,最后落在一个枢纽角色上——帮更多企业从“+AI”走向“AI+”。
所谓“+AI”,是在原有业务流程里塞进AI工具,解决某个局部环节的问题;“AI+”不一样,它要让AI进入研发、生产、供应链这些核心业务,把生产流程和组织方式重新做一遍。
AI接的任务越复杂、扎进业务越深,企业对底层算力的稳定性、经济性和灵活性就越是离不开。
联想的优势就在这里:业务能力横跨基础设施与应用两头,既能参与设备、能源和算力效率的优化,也能靠模型服务和智能体应用拿到真实业务的反馈。
一头连着算力生产,一头接着真实业务,联想在AI基础设施价值链上站到了离最终产出更近的地方。
能力齐全是一回事,让协同自然发生是另一回事。要把跨环节优化变成能复制的方法,还得有块成熟的试验田。
张家口就是这块田。它既是联想万全混合词元工厂的第一个落点,也担起了验证任务。联想管它叫“首座混合词元母本工厂”。
按计划,联想会拿自己真实的AI业务负载去检验不同算力和模型之间的协同效率,一边跑一边优化资源调度、成本控制和安全运营机制,等技术和运营经验成熟了,再往不同产业推。
联想集团执行副总裁兼中国区总裁刘军提到,公司内部已经有上百个智能体应用,正好能提供持续变化的使用场景。
母本不是要造一个能1:1复制的机房,目的是归纳出一套让不同资源协同工作的办法。
湖南广电的AI短剧项目可以拿来当例子。
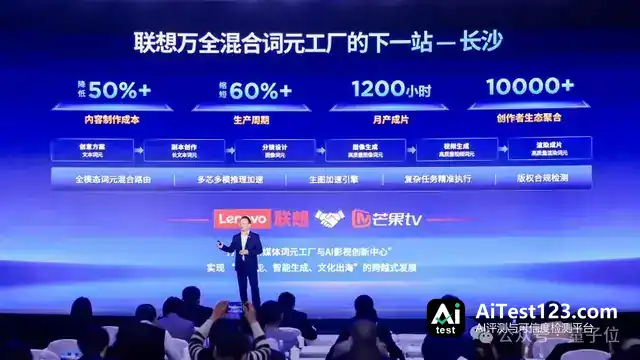
戴炜透露,湖南广电最开始要的其实是内容生成Agent。后来AI创作进入常规生产,Token成本慢慢成了新的压力,双方的合作就延伸到了基础设施层面,计划在长沙建一座专门服务影视和短剧产业的混合词元工厂。
这得从短剧的生产流程讲起。
AI影视制作要过剧本、分镜、图像、视频、渲染好几道环节,不同模型的开销差得很远,项目档期又带来明显的算力波峰波谷。自有IP和版权素材还牵扯数据安全,不能随便交给外部服务。
芒果传媒战略投资部投资总监肖文强也在现场给了判断:算力的供给方式,得服从内容的生产方式。
所以湖南这个项目打算用全模态词元混合路由、多芯多模推理加速等技术,给不同制作环节配上对应的计算资源。
按照规划,项目希望把制作成本降50%、生产周期缩短60%,月产成片超过1200小时,并聚合超过1万名OPC内容创作者。
1200小时摊下来平均每天约40小时成片,背后得靠大量并行任务撑着。这种规模的并行创作,对Token持续供给的要求,比零散调用高出一大截。
这种矛盾不只出现在影视圈。教育场景同样如此。联想披露的上海健生普教项目覆盖600余所中小学,平时教学、集中备课、考试批改对算力的需求各不相同,寒暑假一到,负载又降了下来。
教育系统与影视制作还有一点不同:涉及大量未成年人信息,数据安全和服务连续性的要求更严。算力不能常年按峰值配,也不能为省钱就把敏感业务随手挪到公共环境。
所以混合供给难的地方,不光是资源调多调少,还得在业务规律和数据边界之间找准那个平衡点。
需求匹配得合不合理,最终要看长期运营的成绩单。联想公布的甘肃庆阳燧弘华创智算中心就是一个运营侧样本——它被列为联想首个混合词元运营案例,综合使用成本省下约30%,单一模型日均处理超过200万次调用、20亿Token,把衡量标准落到了日常调用和实际成本上。
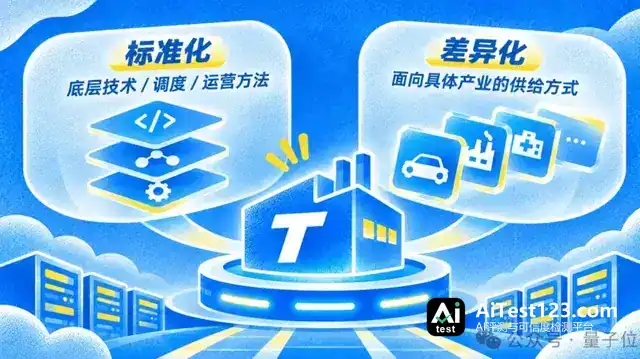
这几个案例的业务节奏不一样,资源约束也各有各的难处。词元工厂要想真正走进千行百业,靠一套固定硬件配置包打天下并不现实。该标准化的是底层技术、调度和运营方法,面向具体产业的供给方式则要差异化。
图片由AI生成
联想打造母本工厂,出发点正在这里:张家口先把方法验证出来,其他地区再按能源条件和产业需求做组合。方法一旦跑通,联想就有机会把自身业务能力变成可规模化复制的词元供给体系,做跨区域、跨产业的词元供给组织者。
坐上组织者的位置,责任就不止于交付。卖服务器的时候,性能和价格都有明确标尺;词元服务进入生产流程后,却要经受业务波动、模型适配、数据安全和成本控制的长期考验。
AI基础设施的价值,正从交付计算能力延伸到交付实际生产力。对企业来说,生产任务能不能稳定交付、长期成本能不能控住,才是衡量AI基础设施价值的最终尺度。
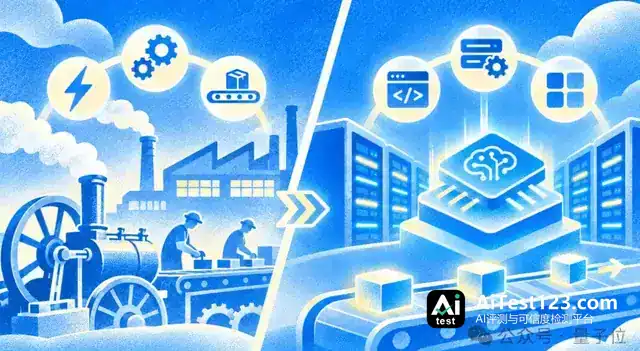
类似的变化,两百多年前的工业革命时期就能看到。蒸汽机带来持续而强劲的机械动力,工厂慢慢不再受水流和地理条件束缚,更多机器和工人得以集中生产。
工业生产从中得到的启示,除了动力更强,还在于能源、机器和生产流程被组织成一套高效运转的体系。AI眼下也在跨过相似的门槛。
图片由AI生成
芯片性能一路往上,模型能力日新月异,可机房里的算力要变成生产现场的效率提升,中间还隔着模型部署、资源调度和业务适配等不少环节。下一轮AI基础设施竞争的关键,就是把庞大的计算能力转成持续的生产力。
技术越复杂,用技术的人越不该被困在复杂里。繁重的模型部署、资源调度和长期运营,应该交给成熟的基础设施去接,企业把更多精力留给产品、生产和服务。
到这一步,AI 的价值才算落回解决问题这个原点上。
千行百业手里的 AI 生产力,也才有可能在日复一日的运转中真正用起来、用透。