MiniMax开源H3-Image:4K生图进10秒,游戏美术管线要变
近些日子以来,网上各种AI游戏效果演示层出不穷。前脚有人晒出光凭键盘WASD就能实时推演画面的射击小样,转眼就有创作者做出阴雨天霓虹灯反射拉满的赛博街区,可谓是接连让人“震惊瘫坐”了。 圈外人看多了这些片段,难免产生一种错觉,觉得做游戏已经快进到“敲几行字跑出大作”的阶段了。 但真去项目组里转一圈,情况却没这么潇洒。前
最近这段时间,网上的AI游戏效果演示一个接一个。这边刚有人晒出只靠键盘WASD就能实时推演画面的射击小样,那边就有创作者做出阴雨天霓虹灯反射拉满的赛博街区,不少人看了直呼坐不住。
圈外人刷多了这类片段,容易生出一种错觉:做游戏好像已经快进到“敲几行字跑出大作”的阶段了。
不过走进项目组一打听,实际情况远没这么轻松。此前和几位一线美术、策划聊日常工作时,他们提到最让人犯难的,还是上游设定图这项打底子的活。
关卡灰盒刚搭好,想借AI铺一层光影看看氛围,画面是好看了,可原本留出的掩体和通路也被擅自改了。
费劲挑出一张看着还行的概念图,正要往下一环节交,一放大,材质接缝全是模糊的。按主美的意思只改某个局部,AI倒好,直接把整张图的建筑结构推翻重画。
游戏管线一环扣一环,下游接再多三维或视频工具,静态二维图至今仍卡在视觉制作的最上游。这块稍微出点偏差,后面的建模和动画就得多花不少工时去填坑。
这或许也能解释,为什么全能多模态的口号喊得震天响,头部大厂却还在图像生成赛道上重兵投入。
就在近日, MiniMax正式发布并同步开源了图像生成与编辑模型H3-Image,支持多图参考输入,并把4K高清生图带进了十秒级的速度区间。再加上持续迭代的Google Nano Banana 2.1与同样开放权重的Qwen-Image-2.1,牌桌上的选手显然都想摘掉“抽卡玩具”的旧帽子。
赶上H3-Image刚开源,我们顺手挑了几个游戏研发里常见的环节做了轮实测,想看看现在的AI视觉工具到底能替游戏人分担多少活,又会冒出哪些新麻烦。
不偏科后,AI的审美也开窍了
过去很长一段时间,游戏人用AI辅助视觉工作,总得忍受它们“偏科”的老毛病。
拿Claude这类文本模型来说,逻辑捋得顺,用来整理可视化方案的条理很清楚,可产出的画面效果总显得干瘪僵硬。Midjourney这类老牌视觉模型美学味道是够,但一碰到严谨的结构逻辑或者复杂的文本信息呈现,马上就撑不住。
游戏美术的要求偏偏最苛刻:空间和零件之间怎么咬合得说得通,画面调性也不能掉链子。靠着此前多模态技术的积累和针对性打磨,H3-Image一个比较明显的变化,是把逻辑理解和视觉美感同时照顾到了。
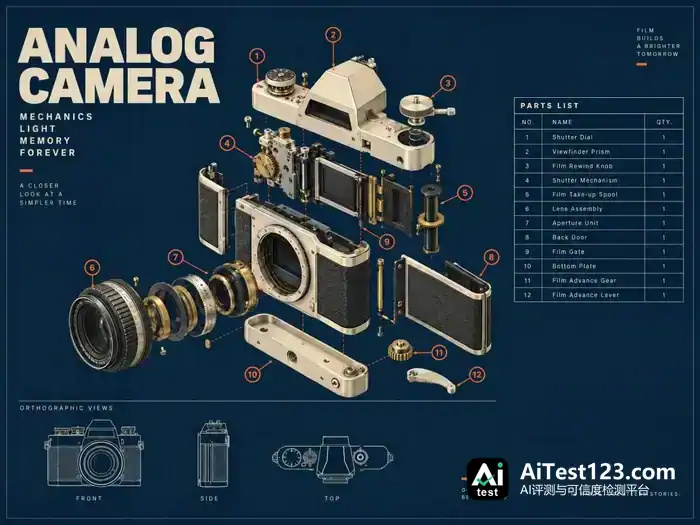
先看逻辑理解方面。实际项目提给原画的需求,很少只是单画一把武器或者一只怪物,通常还会附带一套拆解与说明要求。
拿这张“天穹裂解者”武器拆解图来说,H3-Image在同一张画布上把立体爆炸结构、侧视CAD线稿和枪口截面图一并摆了出来。枪管线圈、弹匣和缓冲枪托怎么组装,交代得比较明白,中文部件标注也排得整齐。

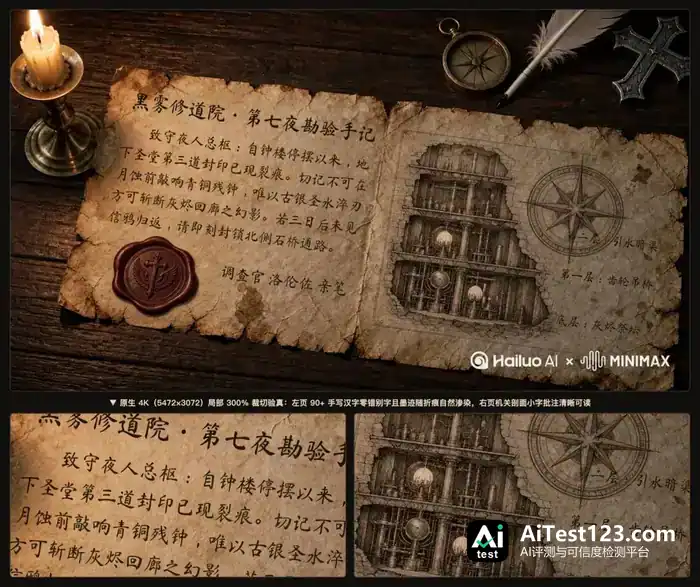
换到悬疑题材里常见的局内书信道具,它的文字还原和材质融合也站得住。左页那一大段手写汉字没冒出乱码错字,墨迹沿着羊皮纸折痕自然散开;右页配的修道院机关剖面图,放大之后里面的细小标注照样看得清。
当然,光是能把结构画对,在游戏工作流中还远远不够。更让我在意的一点在于,现阶段AI在视觉审美上也有了肉眼可见的变化。
早年的AI图之所以一眼就假,多半是画得太满,总喜欢在角落塞满繁复花纹和高光。要判断一个模型懂不懂游戏画面,看它能不能处理好“留白”和“重心”这两点其实就够了。
成熟的游戏画面得先会留白,把背景噪点压住,给角色剪影、战斗特效和UI腾出喘气的地方。同时还得抓得住视觉重心,在开放世界或者箱庭关卡里,用奇观建筑把玩家的目光勾过去。
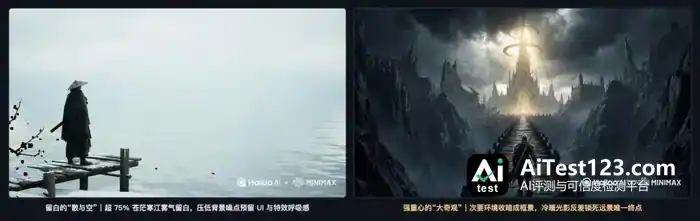
从我们实测的情况看,H3-Image对这种分寸已经拿捏得不错。左图那幅寒江孤舟留出大片干净的水雾江面,显得克制又空灵;右图把两侧山体压暗,借助石桥和冷暖光影的对比,把视线自然带到尽头的圣殿,玩家不看小地图也知道该往哪走。
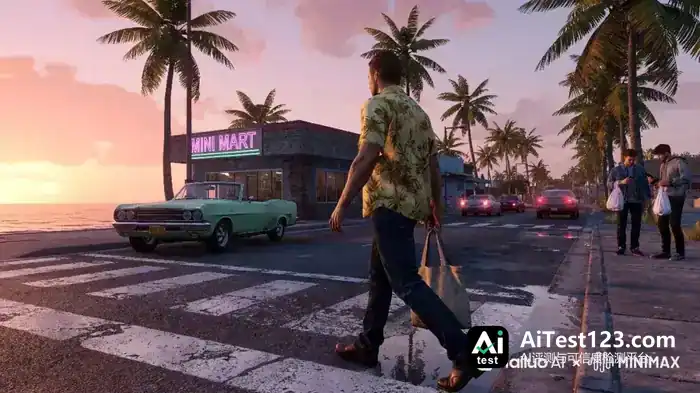
在日常生活松弛感和多元画风上试下来,H3-Image的表现也挺自然。比如生成《GTA》风格的开放世界街景,落日下的斑马线、拎着袋子过马路的行人还有地面积水,很像玩家跑图时随手截下的一帧实机画面,摆拍的宣传画味道淡了不少。
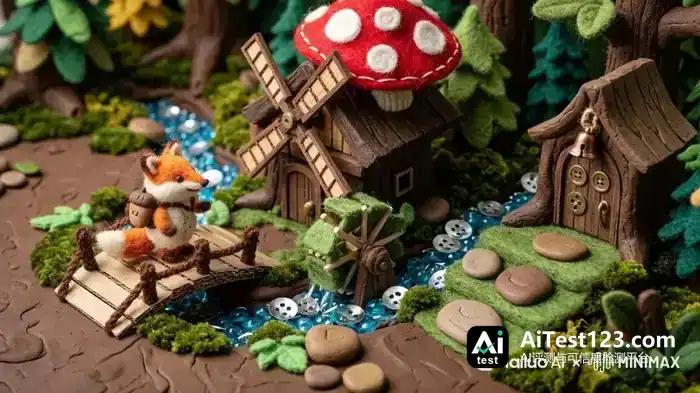
换成毛毡定格动画、水彩或者剪纸这些风格,小狐狸身上的毛毡肌理和纽扣溪流的细节也很讨喜,中小团队在立项早期拿来试不同画风挺合适。
场景、3D与CG的落地新解
从今年GDC的行业调查到国内大厂披露的研发动态来看,AI辅助2D美术生产在业内已经相当普遍。
工作室早就不在尝鲜阶段了,如今算的是工时账:新工具能不能顺利接进上下游、少返几次工,才是大家真正关心的。围绕游戏场景、3D资产与CG预演三个常用环节,我们用几组实测来看H3-Image的实际成色。
先说场景探索里的“空间规矩”。现代关卡流程一般先搭灰盒,把尺度和掩体动线定下来。过去用生图模型改场景概念图,最怕的就是天气光影一换,原本设计好的路线跟着乱掉。
我们拿一张白昼关卡底图做了定向改稿测试,要求保留左侧集装箱掩体、中间主路与右侧走廊的布局,把画面切成暴雨深夜,并点亮远处崖顶的信标灯。对照对象是主打连续编辑的即梦Seedream 5.5。
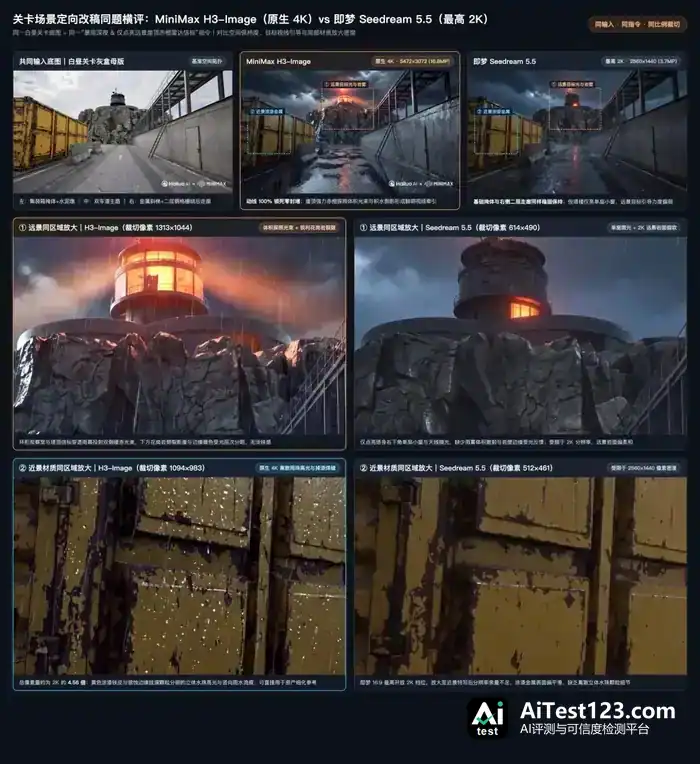
两款模型都保住了基础道路结构。差别在细节:H3-Image对崖顶探照灯和路面积水反光的处理更明确,视线引导比只点亮一扇小窗的Seedream 5.5到位不少。
放大局部看,原生4K规格的优势也显出来了:近处铁皮集装箱上的水珠锈迹、远处岩壁裂隙都还清楚,美术拿去拆材质参考省心,中小团队想低成本试“同一场景多状态变化”也容易了不少。顺着管线往下游走,就到3D资产的交接环节。二维渲染图立体感再好,跟能直接进引擎的三维网格仍是两码事,减面拓扑、UV拆分与材质调整一样都省不掉。上游换上更聪明的图像模型,主要是让接手的建模师和混元生3D这类网格工具,最后能“少猜几次结构”。
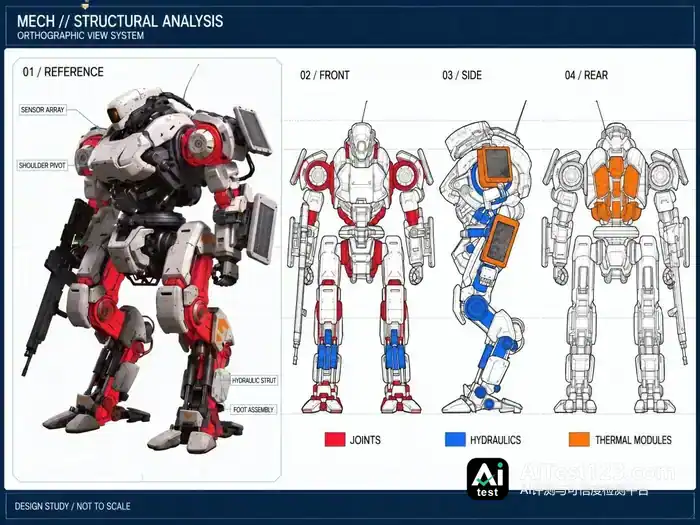
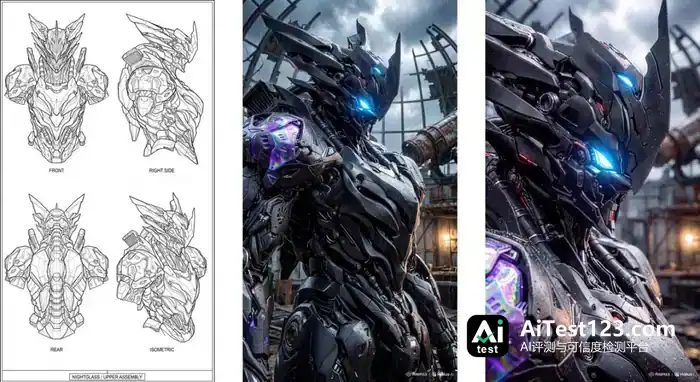
海外创作者cyber翻新旧机甲设计时,就用H3-Image做出了正、侧、背与等轴测四视图线稿,再据此生成机甲的雨夜渲染图。装甲衔接和表面水珠质感都比较规整,4K出图的速度也让他满意。
为了进一步观察H3-Image改部件时的跨视角稳定性,我们输入了一张“气压抓钩发射器”四视图母版,要求在四个视角下同步把顶部琥珀色蒸汽罐换成蓝色冰晶舱,并在握把底部加装破窗锤。同台参照的是同属开源阵营的Qwen-Image-2.1。

对比下来,Qwen-Image-2.1只改对了等轴测视角,其余正交视图出现漏改旧罐或漏装尾锤的情况;H3-Image在四个视角里同步完成了两处部件替换,原有齿轮与前端抓钩也没有变形。
再往下是CG前期预演。过去劝退中小项目的是前期准备成本:立项初期只想试几套角色配色,或者探探过场镜头的气氛,专门收集素材去训练定制模型未免太耗时间。
日本创作者Mankyu(@manaimovie)近日在X上晒出一组免训练测试:他只给了一张…发少女原画,H3-Image便接连做出粉色穿搭、双马尾和水手服几种差分,再把这些图放进黄昏废墟的背景中。成图里鞋扣的繁杂结构、呆毛这些细节都没丢,夕阳暖光落在发丝和衣褶上也显得自然。
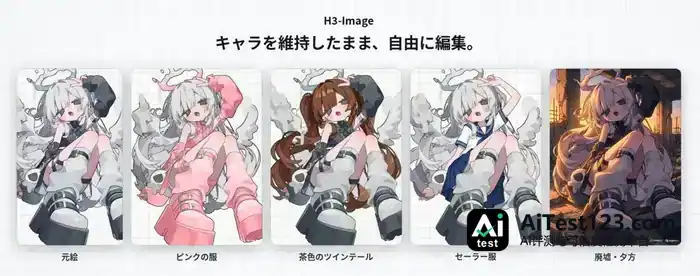
原推文里,Mankyu也客观提到了现阶段的边界:纯二维插画场景下,如果大幅改变人物角度或姿势,想死死锁住原有的笔触画风依然有些吃力。
跨机位、多元素的复杂镜头,正好对上H3-Image单次最多可塞16张参考图的能力,后半程的需求它接得住。角色、服装、场景结构连同色调参考一起喂进去,连续的CG关键帧就能直接合成出来,团队还试过换机位去看复杂空间里的关系。
前面跑出来的抓钩枪、暴雨夜关卡,加上一张3D特工设定图,被我们一并交给H3-Image,没有做任何额外训练,两组不同机位的CG预演画面就直接生成了。
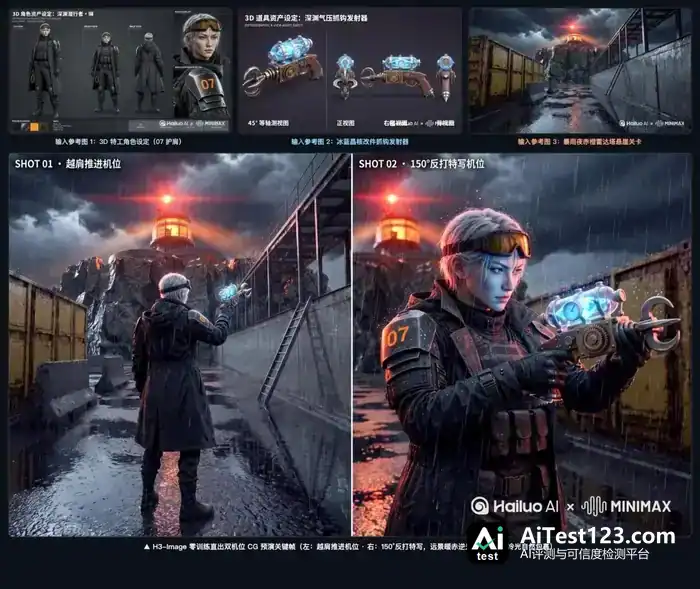
镜头从背后的越肩视角切到正面反打特写,特工肩甲上的编号、手里那把冰晶抓钩枪,还有身后集装箱和灯塔的方位,全都对得上,雨夜冷暖受光也保持统一。导演和分镜师在正式绑定渲染之前,完全能靠这种方式先把机位方案大致定下来。
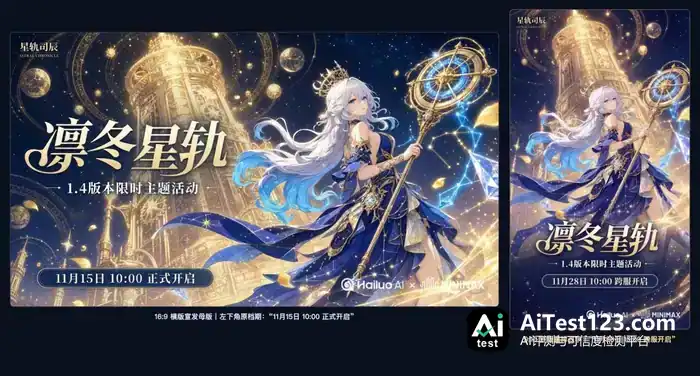
日常运营宣发里,这套构图重组加文字修改的本事同样好使。拿横版活动海报改成竖版、顺带调整上线档期来说,模型会把背景和角色的位置重新排得自然,画面上的开服时间也能准确改掉。
让这些用法真正在项目里跑起来的,还有速度和价格。官方测试数据显示,同类模型做一张4K多图编辑常常要等上一分钟;H3-Image在海螺网页端跑常规高清图,十来秒就够,就算拉满4K带参考图编辑,大多也能压在十几到二十秒上下。
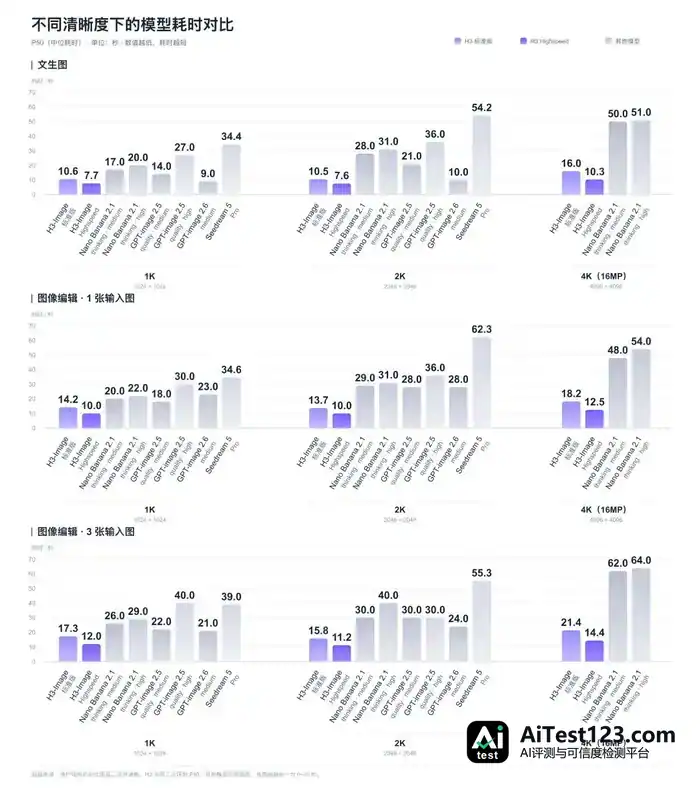
定价方面,它大约是同档主流工具的五到七折,单张生图或改图也就是几毛钱的开销,目前还有限时折扣。
这么算,主美在评审会上连改十版,花掉的不过一瓶水钱,小团队试废案也不必再抠预算;换到大厂高频产出运营和买量素材的场合,长期省下来的成本还要更可观。
敞开权重,让工具真正作用于项目
画质、工序、成本之外,数据安全和工程衔接也是不少商业游戏团队接大模型时放不下的顾虑。没曝光的新游立绘、核心关卡灰盒,都不能碰外部黑盒,这是研发团队守着的保密红线。再说改图若每次都靠人在网页、修图软件和引擎之间来回倒文件,生图省下的时间又全搭进搬运里;万一外部云端哪天换了底座,跑了半年的画风还可能断档。
而如今,这最后十米的落地顾虑,H3-Image给出的使用链路与开源策略也都有能力解决。
除了在海螺网页端直接生图,开发者还能用API把H3-Image接进MCode、Claude Code、Codex、WorkBuddy、Workbuddy这些Agent环境。碰上成套世界观设定或复杂拆解任务,Agent先在前端搜集资料、管理上下文、梳理修改指令,模型在这种环境里的指令遵循表现比网页直出更稳;策划与程序也能更早拿出视觉草稿跨部门沟通,省下时间。另一手关键动作,是发布当天就把模型权重放开。今年夏天MiniMax开源视频模型H3后,社区很快衍生出不少新模型和ComfyUI工作流玩法。这回H3-Image接棒敞开权重,等于把管线的改造权交回游戏公司自己手里。
有技术美术储备的中大型团队,可以拉取权重进内网,结合自家沉淀的美术规范开发贴身工具;没有本地运维包袱的独游小团队,在开放平台、MCode或海螺上按需调用服务,照样能轻装上阵。
(ComfyUI官方界面)
市场那头,今年游戏业内外对AI视觉工具的心态,比前两年沉稳多了。放到局内玩法与日常活动上,国内玩家对有趣的AI交互接受度其实不低。《超自然行动组》里混入队伍语音交流的“假人”挑战,《和平精英》的AI队友,《星布谷地》日常活动里能自由对话辩论的NPC,参与度都相当高。
不过视角从局内的“AI活动”切到“AI做的游戏”,玩家侧与业内侧的标准完全分成两套。前阵子Steam新品节上,粗糙的生成式AI作品普遍遭到抵触,反AI主题的《Probably Stolen》试玩版反而登顶单人热门榜;同一时期,AI深度参与制作、明显压缩了研发成本的《不问凡尘》,上线后口碑与销量都不错。
其实游戏行业对AI技术本身没那么排斥。玩家抵触的,始终是敷衍粗糙的半成品。最终端上桌的产品足够扎实,省下来的研发成本真能变成游戏里的好体验,市场自然会给正向反馈。
顺着这层逻辑再往深处想,过去几年游戏行业容易陷进题材与玩法的同质化,一定程度上是被高昂的视觉试错成本束缚了手脚。回顾游戏业过去十来年的演进,每一次玩法层面的集中爆发,背后几乎都伴随着底层技术门槛的抹平。当年通用商业引擎普及了成熟的渲染与物理管线,把开发者从重复造车轮的循环里解放出来,才换来随后几年独立游戏与新兴品类的兴盛。
探路这件事,H3-Image 这类开源视觉模型现在也在做,而且已经站到了第一梯队。光靠美术资源越堆越多就能形成壁垒,那样的阶段正一点点过去。
到那时,真正决定游戏作品上限的,是那些在低门槛土壤上生长出来、百花齐放的创意玩法。站在人的创作角度看,这未尝不是一件好事。