Kimi K3跑在40核无显卡老服务器:傲腾内存扛住2.8万亿参数

资讯 AI 产业速递 全文 891 字 · 约 3 分钟读完 配图 1 张 分类大模型存储

无需显卡也能跑! 40 核老旧服务器硬刚 2.8 万亿参数大模型,傲腾内存成破局利器

所属频道 模型发布算力与芯片

2.8万亿参数的巨型大模型,通常得靠昂贵的高端显卡集群才带得动。不过最近有人在社区晒出了一次颇具极客味道的极限测试:一台没插显卡、装着40核处理器的老旧服务器,愣是把月之暗面的Kimi K3跑了起来。

一台老机器,怎么扛住这么大的模型

Kimi K3是混合专家模型,总参数量2.8万亿,每个 token 只激活约1040亿参数,官方标称上下文高达104万 token。

这么庞大的数据体量,就算压到极限的1bit 量化,也得数百 GB 内存才装得下,普通家用主板显然承载不了。为了绕开这个瓶颈,该玩家用了另一条路:一颗40核的第三代至强可扩展处理器,配上英伟达已经停产的傲腾持久内存200系列,单条最高支持512GB 容量。
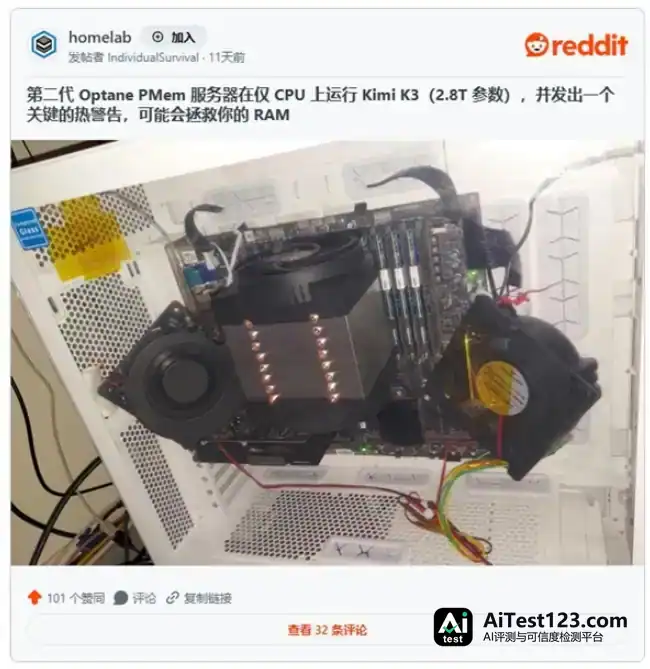
image.png

软件这边,靠停产的傲腾当主存

软硬件怎么配合?该玩家用 llama.cpp,把傲腾持久内存设成 App Direct 模式,让程序直接把它当内存读写,而不是交给系统当硬盘缓存去调度。

代价落在速度上。

生成效率方面,1bit 量化下实测只有每秒0.85个 token;关掉直接访问(DAX)模式,最高也才每秒1.5个 token。

耗时更直观:换到3bit 量化,速度约每秒0.75个 token。写几百字要等好几分钟,输出5万个 token 则要18.5小时。

发热也不能忽略。英伟达的数据表显示,这代产品单条功耗上限18瓦,介质温度到83摄氏度就开始降频,冲到85摄氏度会触发保护性关机。

英伟达其实早在2022年第二季度就着手收缩傲腾内存业务,当季计入5.59亿美元的库存减值,这条产品线也就没有下一代了。这次硬核运行,更像是一次冲着极限边缘去的极客致敬,也是一次可行性验证。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. ShellElastic一次训练出五个模型:弹性训练的三个坑怎么填

    你有没有想过,一家做手机应用的公司,为什么总是要同时准备好几个版本的AI模型。旗舰手机用大模型,跑得动也效果好。入门手机用小模型,省电省内存。平板用中等模型,刚好够用。问题是,这些模型通常是分开训练出来的。训练一个十几亿参数的大模型要花多少钱,业内人都清楚。现在要五个不同大小的模型,难道要花五倍的钱,...

    来源 腾讯网
  2. 存储涨价未止,中科曙光押注Token时代存储新价值

    IT时报记者 贾天荣“至少目前还没有看到这两个诱因的衰减。”谈及这一轮存储涨价何时结束,中科曙光集中式存储产品部总经理郭照斌给出了这样的判断。他所说的两个诱因,一是AI基础设施建设带动从HBM、内存到闪存的需求增长,二是AI应用正在产生越来越多的新型数据,包括大模型推理过程中的KV Cache。这意味着,即便AI算力建

    来源 腾讯网
  3. 百度词元所上线满月:日均调用超5000万次,要做中立模型交易入口

    11月12日的百度世界大会上,李彦宏谈起了大模型市场里的一门常见的生意——中转站的商业痛点。“这些中转站它们把各种模型提供方聚合起来,提供给开发者来调用,但它们并不对模型的效果、服务的稳定性、响应速度等负责,甚至有时候这个模型的真实性都无从考证,它如果说用一个flash来代替,或者它生成一个Pro版本基本上也不...

    来源 腾讯网
  4. AI 时代,公司的「新厂房」长什么样?

    十年前的百度世界 2016 大会上,李彦宏曾站在台上提出「AI is the New Electricity」(人工智能是新电能),提前预判了人工智能浪潮。那时,很少有人能想到,走进写字楼,程序员用 Agent 写代码,运营用 AI 跑报表,连行政都在用大模型搭报销流程。不过,索洛悖论也再次产生。你去问企业管理者,十有

    来源 腾讯网
  5. 算力租赁改按Token分成:周咏降固定租金,头部客户试点

    自2026年一季度起,保底+Token超额分成的算力计价方案开始在国内头部算力租赁服务商与头部大模型、Agent应用厂商之间试点落地,目前仍属于小范围探索,集中在推理业务占比高、调用量具备增长预期的战略客户,尚未向中小客户、训练类订单铺开。

    来源 凤凰科技
  6. 谷歌上线Gemini 4 Hydrogen:3.8 Flash退役,发布节奏变了

    谷歌正式发布Gemini 4 Hydrogen,一改Carbon与Argon缓慢谨慎的安全发布节奏,以更快速度推向市场,并取代服役已久的3.8 Flash。本文梳理此次发布的策略转变、模型定位与行业影响,分析谷歌在模型迭代速度与安全治理之间如何重新取舍,以及这一动作对整个大模型竞争格局可能带来的连锁反应。

    来源 AI 科技快讯
  7. UCIe 4.0规范发布:新增片上存储链路,数据效率93.75%

    IT之家 11 月 13 日消息,UCIe 联盟当地时间 12 日发布了该芯粒互连规范的 4.0 版本。最新的迭代将 UCIe 架构从芯片级接口设计扩展到满足将多个芯片集成到统一的封装系统的关键要求。 UCIe 4.0 引入了标准的片上存储器链路,UCIe.mem 协议简化了 SoC 与存储器逻辑裸片间的集成,实现了高

    来源 AI 行业观察
  8. 陈林再创业项目银河智学亮相,邓澍军详解小鹿爱学技术架构

    11月9日晚,字节跳动原高级副总裁、今日头条及大力教育原CEO陈林以一篇《我为什么还要做教育?》正式公开再创业项目 “银河智学”,引发行业广泛关注:在大模型能力日趋通用的今天,重返教育深水区的陈林团队,究竟打算做出一款什么样的 AI 教育产品? 两天后,这一问题在技术与课堂层面得到系统拆解。11月11日,在江苏无锡举行

    来源 AI 行业观察
  9. ID. ERA 5X上市:9.99万元起,四款配置怎么选?

    近日,上汽大众ID. ERA 5X正式上市,新车共推出Pro、Pro+、Max、Ultra四款车型。限时权益价为9.99万元—13.99万元。作为一款面向年轻人与家庭用户的都市纯电SUV,ID. ERA 5X是大众CMP+CEA+ADAS全球首款量产车,全系标配4纳米MTK8676车规级芯片与豆包大模型2.0,并搭载行

    来源 AI 行业观察
  10. 谷歌Gemini眼镜395美元起:隐私优先能否避开Glass老路?

    谷歌正式发布首款搭载Gemini AI的智能眼镜,起售价395美元。产品由谷歌联合三星、Gentle Monster和Warby Parker共同打造,主打隐私保护,试图避免Google Glass当年的覆辙。在Meta Ray-Ban智能眼镜打开市场后,谷歌携大模型能力重返可穿戴赛道,智能眼镜的AI助手之战正式打响。

    来源 AI 科技快讯
  11. OPPO成立AI新硬件实验室:姜昱辰挂帅,心力球后再扩终端版图

    OPPO近期正式成立AI新硬件实验室,由原ColorOS智慧产品研发总监姜昱辰担任负责人,推动个性化主动智能从手机向更多硬件形态延伸,加快构建AI原生终端体系。 姜昱辰曾于2023年创办大模型创业公司波形智能,主要探索大模型在长文本生成等领域的应用。2024年10月,波形智能被OPPO收购,姜昱辰随后加入OPPO,参与

    来源 AI 开发者社区
  12. 月之暗面徐天天:AI能力上限远未到,三条曲线驱动加速

    在人工智能发展速度引发广泛讨论的当下,大模型的能力边界究竟在哪里?在11月12日举行的第十七届财新峰会上,月之暗面金融行业与生态负责人徐天天发表了专业观点,明确指出当前 AI 的能力边界与智能上限还远远没有达到极限,行业整体依然处在加速进化的快车道中。 三条叠加的增长曲线:驱动大模型持续进化的底层逻辑 在主题发言中,徐

    来源 AI 开发者社区
  13. 百度世界大会2026:李彦宏推“词元所”,大模型交易平台上线

    在今日举行的百度世界大会2026上,百度创始人李彦宏正式推出了一款全新的大模型服务平台——“词元所”。针对当前企业和开发者在面对海量大模型时普遍面临的“选择困难”与“信任缺失”痛点,该平台创新性地引入了证券交易所的运作理念,旨在为行业提供一个中立且可信的模型交易与分发阵地。 类比证券交易所:汇聚优质资源与模型提供商 在

    来源 AI 开发者社区
向下滚动自动加载更多






