硅心科技开源aiXcompact-4B:4B上下文压缩模型,单次API费用降97%
支持单张显卡私有化部署。

11月11日,由北京大学软件工程研究所孵化而来的AI编程创企硅心科技(aiXcoder)开源了一款专用于上下文压缩的模型aiXcompact-4B。该模型瞄准编程Agent的长程复杂研发任务,参数量只有4B,支持在单张A100-40GB显卡上做私有化部署。
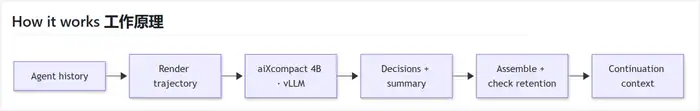
做上下文压缩时,aiXcompact-4B会对编程Agent的历史轨迹做结构化处理:关键原始信息予以保留,文件读取、代码搜索、测试运行等工具返回的结果做精简,重复或已失去参考价值的中间记录删除,同时生成结构化的任务摘要。这样一来,后续重复输入带来的Token开销就能以较低成本降下来。
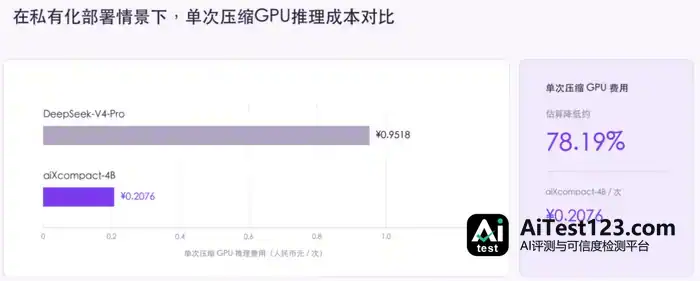
据aiXcoder公布的数据,在Terminal-Bench基准测试中,把aiXcompact-4B接入OpenCode做上下文压缩测试,整体任务完成准确率与DeepSeek-V4-Pro持平。私有化部署场景下,针对特定任务的单次GPU推理成本比DeepSeek-V4-Pro低78%。
走API调用这条路时,按公开API费用估算,aiXcompact-4B单次上下文压缩请求的Token费用约0.019元。与DeepSeek-V4-Pro、GLM-5.3、Qwen3.8-Max的参考费用相比,分别低97.30%、97.08%和97.98%。单次API调用费用降97%,让高频上下文压缩多了一个轻量又省钱的选择。
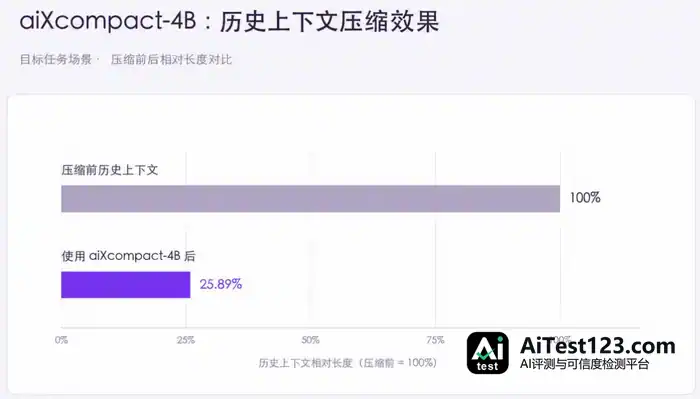
上下文压下去之后,Agent需要反复读取的历史上下文也跟着变少。在目标任务场景下,aiXcompact-4B能把历史上下文平均压到原长度的25.89%,为下一轮Agent调用留出足够的上下文空间。
智能体编程任务平均Token消耗417万,上下文压缩是成本控制关键

开源地址:
https://github.com/aixcoder-plugin/aiXcompact-4B
Claude Code、Codex这类AI编程工具开始承接更复杂的研发任务,Agent要不断读代码、调工具、跑测试,Token开销随之上去了。
一项基于OpenHands框架、覆盖8个前沿模型的研究发现,在SWE-bench Verified实验中,一个完整的智能体编程任务平均消耗约417万Token,相当于单轮代码推理的3500倍、多轮代码对话的1200倍,其中输入Token占了绝大部分。
这跟Agent的干活方式有关。比如给企业现有系统加一个用户注册功能,Agent得先摸清项目结构,找到用户管理和鉴权逻辑,再改文件、跑测试,照着报错接着调。这当中,代码、检索结果和执行日志不断进入上下文,成为后续工作的依据。同一批历史信息可能在多轮推理里被反复输入,执行步骤越多,重复输入累积的Token开销越大。
成本之外还有个问题:早期需求、关键约束和已确认的技术决策混在大量中间记录里,Agent可能漏掉重要信息,也可能丢掉调试线索。
于是上下文压缩成了控制Agent运行成本、支撑长任务持续执行的重要工程环节。核心做法是从不断增长的Agent运行轨迹里保住关键信息、精简冗余内容,减少重复输入的Token消耗,把更多上下文空间留给当前代码、最新反馈和后续决策。
依靠结构化判别机制,信息筛选后形成摘要
编程Agent的工作流程是:开发者先提需求,Agent分析问题、调用工具,工具再返回文件内容或执行结果。对需要持续执行任务的Agent来说,上下文压缩得在省Token和保关键信息之间找平衡:压得太少,上下文开销降不下来;压得太多,历史关键步骤可能丢失,代码信息和工具调用之间的结构关系也会被破坏。
aiXcoder的看法是,有效的压缩既要看懂信息内容,也要保住上下文之间的关系。aiXcompact-4B用结构化判别机制,对历史轨迹给出三类处理决策。
第一类,保留关键原始信息。开发者的核心需求、关键约束、重要决策等可能影响后续代码修改方向的信息,aiXcompact-4B会完整保留原始消息,降低关键限定条件在改写中被弱化的风险。
第二类,精简工具返回结果。文件读取、代码搜索、测试运行往往返回大量内容,但下一步工作可能只用得上一部分。aiXcompact-4B保留工具调用,用精简文本替换冗长的原始输出,既减少输入Token,也留下继续定位问题、修改代码所需的线索。
第三类,删除失去参考价值的记录。重复内容或不再需要的中间输出,aiXcompact-4B会删掉,并配套校验动作,检查其中的关键业务信息和调试信息是否已经写进任务摘要。
信息筛选完成后,模型还会生成结构化任务摘要,记录用户意图、关键技术信息、错误与修复过程,以及当前工作和待办事项。最终输出的是一套可供Agent继续执行的消息序列,工具调用与返回结果的配对关系保持不变。
从工作原理看,aiXcompact-4B能判断信息价值,分得清哪些不能丢、哪些可以精简、哪些已经没必要,在减少重复Token消耗的同时,保住后续Agent完成任务所需的必要上下文与结构。
基于真实研发轨迹训练,4B模型上下文压缩评测接近DeepSeek-V4-Pro
aiXcompact-4B的判断能力,来自教师大模型蒸馏、4B学生模型LoRA微调与结构化压缩决策相结合的训练技术路径。
据aiXcoder介绍,训练数据全部取自真实研发场景下的Agent运行轨迹。团队先对轨迹做归一化处理、过滤筛选和压缩触发点采样,再由教师模型生成参考压缩决策。
这些参考结果经过样本校验与筛选后,用于学生模型的专项训练,让它学会结合研发进度处理历史上下文,也学会在任务摘要中保留后续工作的依据。
目前,该模型已开源。
技术分工上,蒸馏把教师大模型在该任务上的处理能力迁到专用学生模型,LoRA微调则针对压缩场景做适配。模型输出形式再被结构化决策收紧,从而能对接Agent的消息与执行流程。
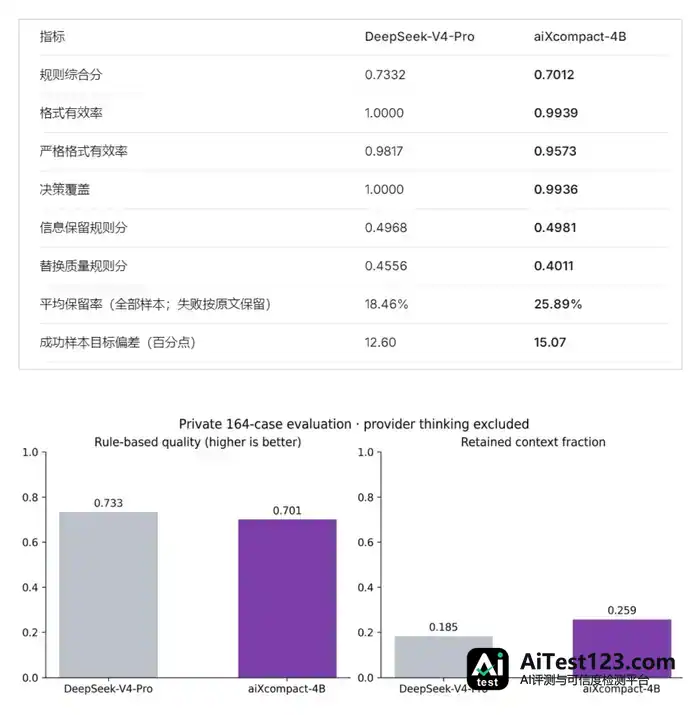
在aiXcoder公布的上下文压缩专项评测里,aiXcompact-4B的规则综合分为0.7012,DeepSeek-V4-Pro为0.7332,两者接近;信息保留规则分上,aiXcompact-4B拿到0.4981,DeepSeek-V4-Pro是0.4968,基本相当。平均保留率方面,aiXcompact-4B为25.89%,高于DeepSeek-V4-Pro的18.46%。
四、大小模型分工细化,适配企业级私有部署和工程落地
AI往企业软件研发流程里走得越深,各研发环节对模型能力的要求就越不一样,模型分工也因此有了继续细化的余地。怎么让不同模型去干更合适的活,既保住任务完成质量,又把Token消耗压下来、把算力利用效率提上去,是企业落地AI研发绕不开的问题。
针对这一点,aiXcoder给出“大模型+小模型”协同方案:需求拆解、复杂逻辑推演和架构设计交给大模型,边界相对清晰、调用频次较高的专项工作则分给专用小模型,以此压降企业的算力使用成本。
除aiXcompact-4B外,aiXcoder手上已有多款参数规模较小的模型。软件研发方向上,面向代码生成与补全的有aiXcoder-7B,面向代码变更应用的有aiXapply-4B,面向Token消耗优化的有aiXpruner-4B。另有一款面向Agent决策环节的aiXdecision模型即将推出,专注智能体执行过程中的判断与决策支持。
结语:上下文压缩模型拓宽复杂Agent任务边界
具体做法是保留关键原始信息、精简工具返回结果、删掉无参考价值的记录,把持续累积的历史上下文压下来,再生成结构化任务摘要,从而降低上下文压缩的成本。
Agent要跑更长链路、更复杂的研发任务,上下文管理会直接牵连Token成本和执行连续性。只要上下文压缩模型在砍掉冗余信息的同时,还能留住需求、决策和调试线索,就有机会帮Agent挣脱上下文开销的束缚,接下更多复杂场景的任务。