

MiniMax开源H3 Image:4K生图10到20秒,权重API同步开放
MiniMax发布开源4K生图SOTA H3 Image
OpenAI 的 Images 2.6 在11月4日才刚上线,没过几天就有人放话:
GPT is cooked.
意思很直白:GPT-6 已经没戏了。
让这帮人上头的,是 MiniMax推出的新模型 H3 Image。
内测用户 Emily 列出过几项硬指标:
参考图最多能塞 16 张,提示词最长写到 7500 个字符,输出最高 4K。
她还顺带下了个判断:按她对MiniMax的了解,这个模型早晚要开源。
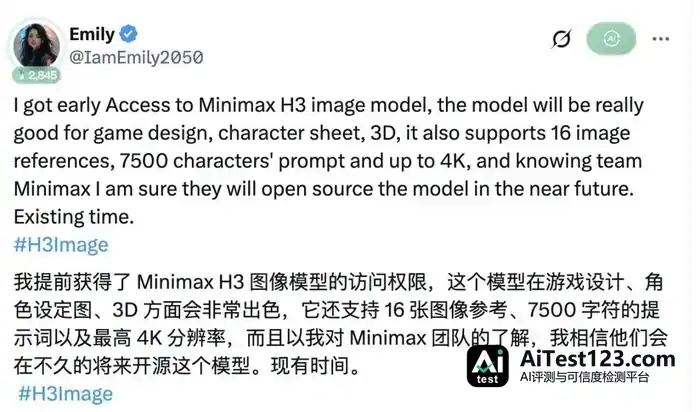

结果她猜中了,而且来得比预想更快。就在今天,MiniMax正式发布 H3 Image,权重当天开源,API 同步开放,在自家的MiniMaxCode、开放平台以及海螺 AI 中都能直接调用。
三个月前,这家公司开源的视频模型 H3,已经被英伟达研究团队、Pika、fal 拿去再训练出衍生模型。
这一回轮到生图。官方把 H3 Image 定位于开源图像模型的 SOTA,整体效果处在全球第一梯队。名次这类说法听得多了,它身上另一点更值得关注:指令遵循能力。
这次的关键词是开源、高清、速度快。
H3 Image 能直接产出 4K(4096×4096)图像。
对创作者而言,分辨率高意味着细节更多,裁切空间更大,图像可用的场景也更宽——同一张图能适配不同尺寸的海报和网页,还能截取局部,把某个人物或产品拎出来。
市面上的主流模型大多停在一百万到四百万像素,速度通常是分钟级,最快的也得 50 秒上下;H3 Image 出一张 4K 图只要 10 到 20 秒,试错的时间成本被压了下来。构图、配色或光线要调,创作者很快就能看到结果,接着改。
换句话说,4K 级别的日常创作,第一次变得现实。
AI生图,不止于美
昨天有一批博主拿到内测资格,图已经晒出来了。
博主 Muhammad Ayan 第一句就是「🚨中国又扔出来一个狠的」,接着放图:输入一张照片,出来一整套 4K 角色设定图,正面全身、背面全身、脸部特写齐全,毛孔、雀斑、细绒毛都看得见。
一句话概括:AI 人像那层「塑料皮」没有了。
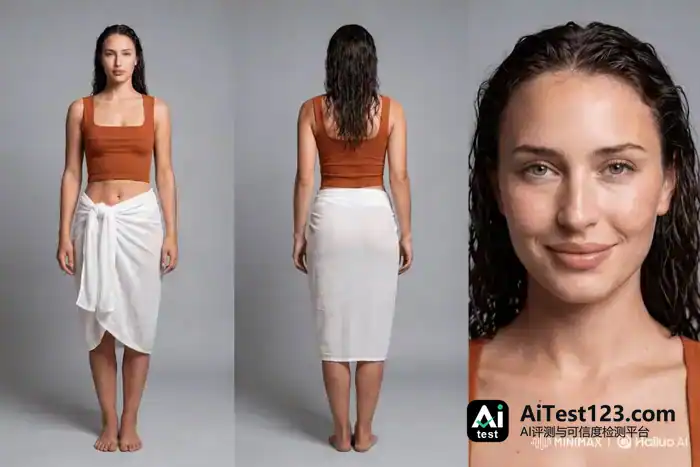
说实话,看到这里我没太在意。「更真实的写真模型」这种说法,每个月都有人讲。
继续往下翻,味道就不一样了。
Papillon 找出一张《GTA:圣安地列斯》的老截图,让它按次世代 3A 大作重画,配文写的是:CJ 等了 20 年的画质升级,到货了。
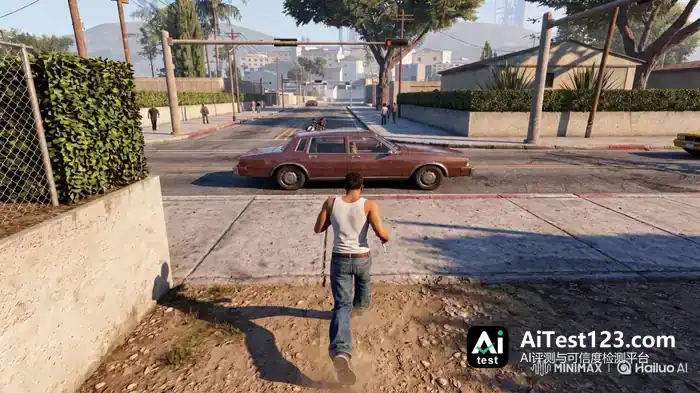
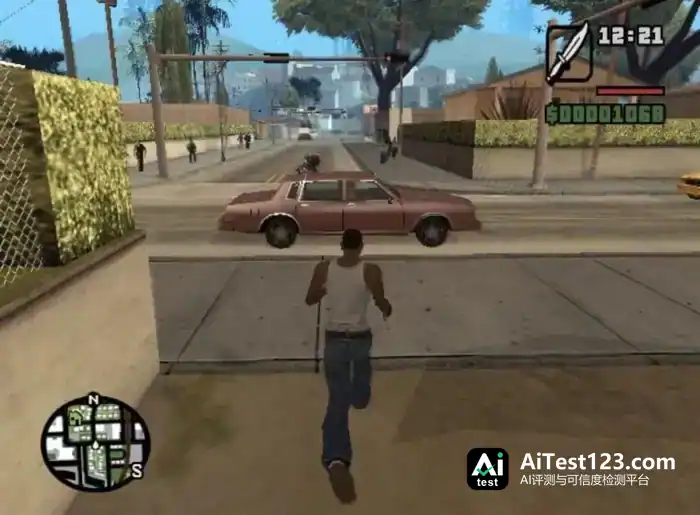
DrSadek 连跑了纪实摄影、赛博朋克动画等四种画风,交给网友投票。
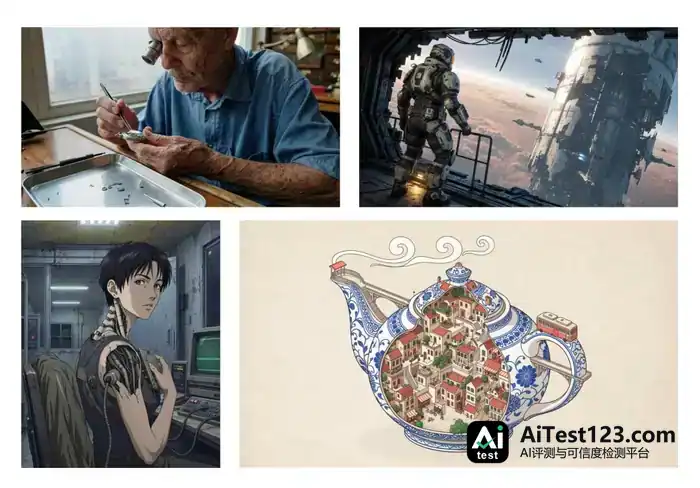
Israa Ali 直接喊出「GPT is cooked」,她测的是 3A 游戏资产和 3D 场景。话说得有点满,但那股兴奋劲不像装的。
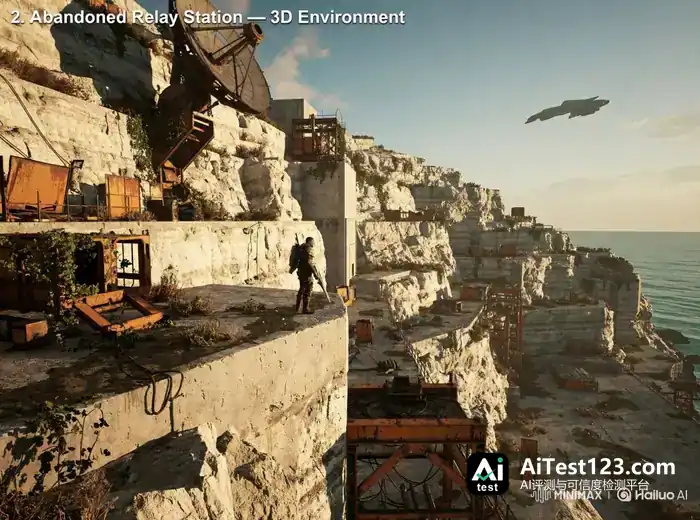
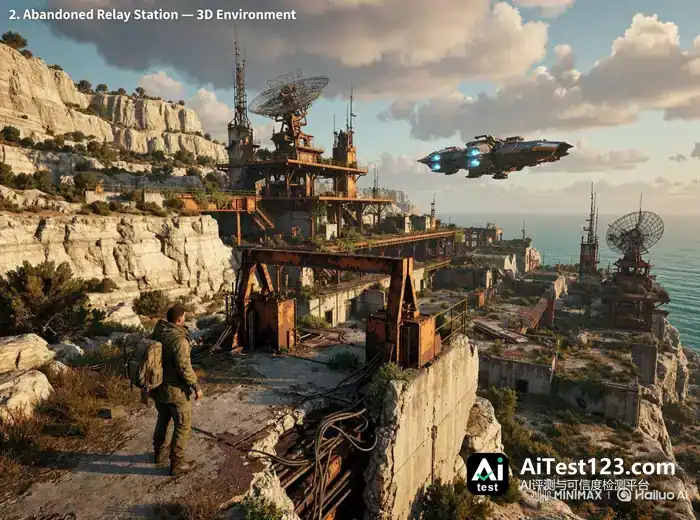
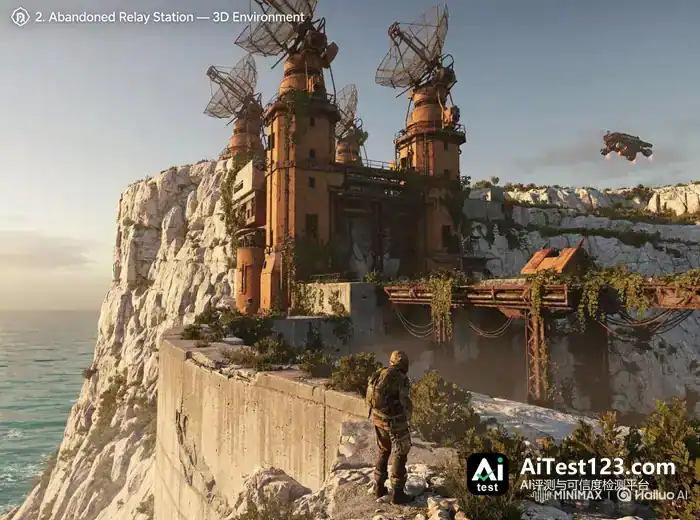
再往后面看,已经不只是「美图」的事了。
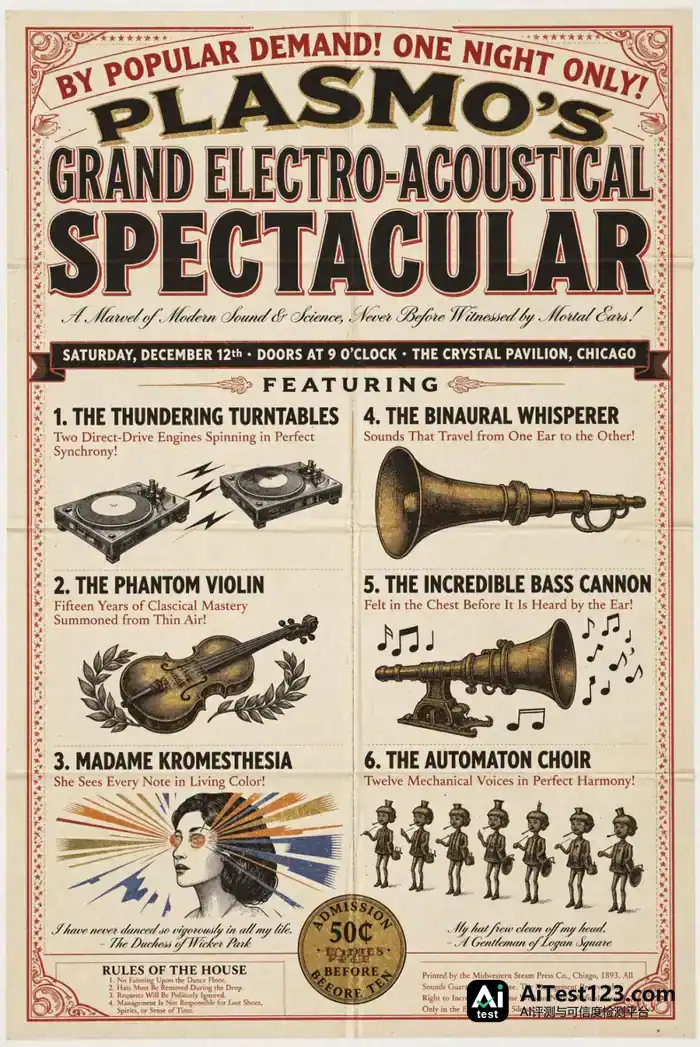
plasm0 用它排大字海报,按他的说法,大字很稳,小字偶尔会错,不过大体上是对的;
美国手语的手势他也测了,评价是「挺不错,比Moss 好多了。」
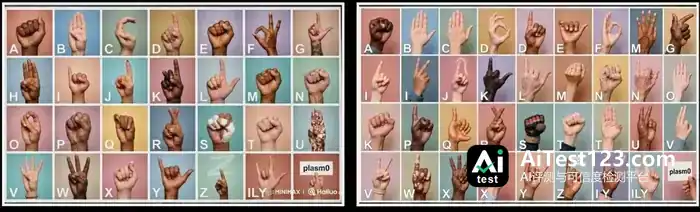
左边是 H3 Image,右边是 Moss。
手语属于极难的场景,AI 模型基本都会出错。ChatGPT-6.1 Sol 统计过,Moss 的正确率只有20.0%,比如 U、V 两个手势互换,一个标着 X 的格子实际是 W。H3 image 同样会错,但正确率已经做到48.1%,「比 Moss 好多了」这句评价完全撑得住。
Ankit Patel 和 studio_oneroom 玩得更野,让它生成 CAD 风格图和机械爆炸图,也就是零件一颗颗拆开、悬在半空那种。
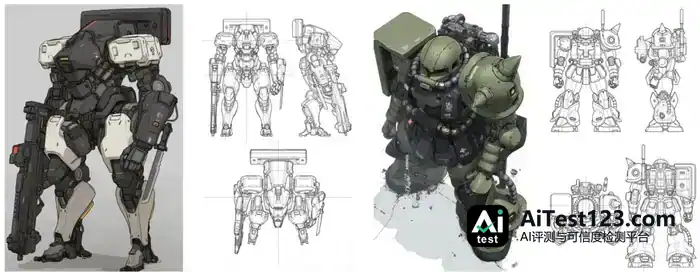
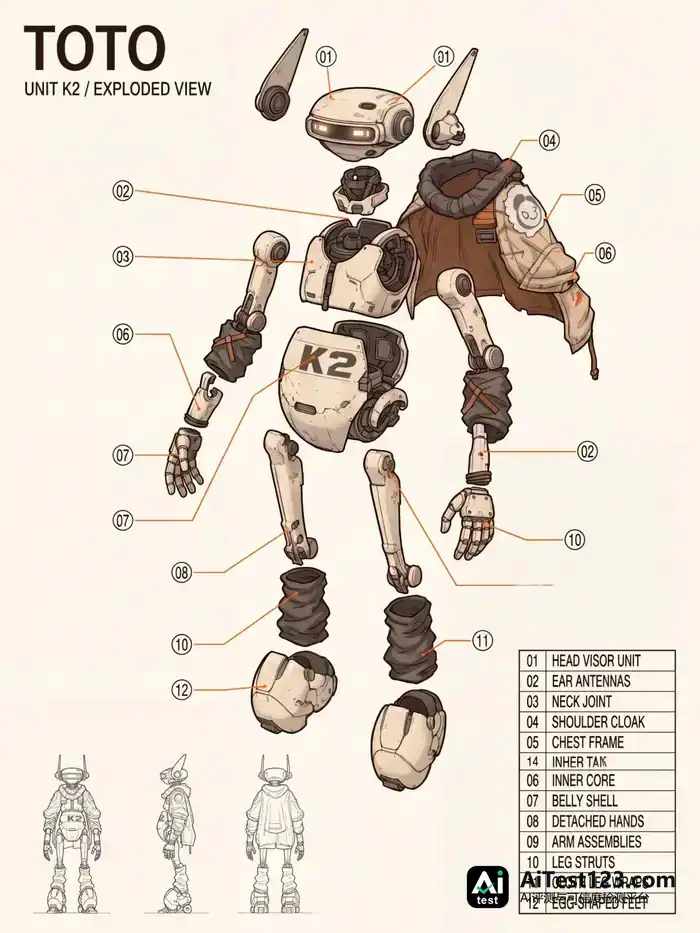
看出来了吗?这几项恰恰是生图模型常年翻车的地方。画面好看不算难,难的是字不能错、手势不能混、零件不能装反。拼的不是画功,是脑子。
这个生图模型不偏科
Midjourney 这类模型像艺术生,光影、质感挑不出毛病,可一遇到长文字、空间关系就犯迷糊。
Claude 这类语言模型像理科生,逻辑清楚,让它写代码、画张图表也有条有理,但它本来就不做生图,画面质感跟专业视觉模型比不了。
指令遵循强、生成速度快、像素高,看上去三者难以兼得。MiniMax这回要做的,就是不偏科。
空口无凭。拿到内测权限之后,我们既没测人像写真,也没测风景壁纸,直接出了三道专挑软肋的题。
第一题:考考生图模型理解能力
有海外创作者提前拿到了MiniMaxH3 Image的试用资格,海外创作者一上手就被安排了一道硬题。
题目是把巴黎埃菲尔铁塔改造成赛博朋克世界里的未来星际通信中继站,而且必须按专业建筑CAD蓝图的样子画出来。
超精细矢量线条、严格对称的建筑结构、复杂剖面设计,密密麻麻的工程细节,一样都不能缺。
测试者看完结果都愣住了。
这么绕的提示词摆在面前,MiniMaxH3 Image的细节表现力出乎意料,指令遵循能力从这张图里就能看出来。

换成应县木塔同样能画,出来的还是能直接用于施工的蓝图:
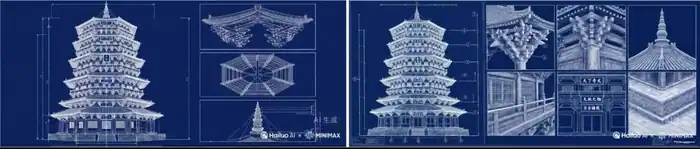
接着难度再加,这回考的是空间感:
题目给的是四足巡检机器狗在震后废墟里的第一视角感知界面(HUD)。前景要露出机械足部的边缘透视,中景是坍塌建筑的残骸。画面上得叠一层三维点云测距网格,远处某根水泥梁柱障碍物周围还要画出贴合边缘的红色 3D 边界追踪框(Bounding Box)。界面两侧各配一个对称的机体倾角姿态仪。
这种图最容易被做成「科幻贴纸」:框归框,楼归楼,彼此不挨着。这张不一样。红色边界框跟着透视走,紧贴远处那根倒塌梁柱的边缘;两侧姿态仪的刻度,也和机器狗前倾的姿态对得上。它像是先在脑子里搭好三维空间,再往里摆东西。
工业辅助设计、具身智能的合成数据,这些靠空间感和真实细节吃饭的活,有戏了。
第二题:脑子好使了,手会不会僵?
理科生最怕被人说「画得像工程制图」。第二题于是换成纯美术:
次世代暗黑奇幻动作游戏的实机界面截图。
背景是一名身披残破重甲的骑士,站在巨大骨骸堆成的废墟悬崖边,远处是正在崩解的黑色太阳,体积雾厚重,带光追反射。前景要放进完整的游戏 UI:左下角是巴洛克金属雕花环绕的暗红色血球和蓝色法力槽;屏幕底端排着五个带倒计时冷却效果的石雕符文技能图标;右上角是一张蒙着半透明迷雾的羊皮纸风格小地图。
整体色调冷峻沉郁。
「游戏场景加整套 UI」这种题,常见两种翻车方式:要么 UI 化进背景里,要么 UI 保住了、主角崩了。
这张稳住了。画面是极高精度的暗黑奇幻 3D CG 质感。天空被一个巨大而压迫感十足的「黑日」占满,黑日边缘碎裂,无数黑色陨石、碎片向外漂浮散落。地面是荒芜嶙峋的灰褐色岩石与枯骨,浓重的冷灰色雾气漫在深渊之上。整体充满史诗感与苍凉感。
再换手工路线。毛毡定格动画里两只穿粗毛线衣的小羊,逆光下绒毛透着亮,黏土底座上的指纹、纸板切口的毛边都清晰可见,这些细节让图片更显真实,也把图像模型能用的范围撑大了。
钢笔淡彩也试了,下笔的轻重、水彩沉在粗纹纸上的水痕都在,没有 AI 图那种油腻的数码味。
第三题:一口气喂它 16 张图
前两题考的是单张图的本事。第三题考的是干活的人最头疼的事:一致性。
干过游戏资产、电商图、连环漫画的人都有体会,参考图一多,模型就开始“串味”:A 的脸跑到 B 身上,盔甲的颜色渗进背景,折腾半天只能反复抽卡。
H3 Image 单次最多能收 16 张参考图,我们干脆喂满:8 张原创 3D 角色的多角度面部特写和表情,4 张机械义肢、动力装甲的局部结构与材质图,另外 4 张是赛车维修车间的光影和色板。
提示词只有一句:“该角色身穿这套动力装甲,坐在赛车维修车间的工作台上调试机械臂,神情专注。”
成品里,脸还是那张脸,五官轮廓、发色都对得上;装甲的关节卡扣和液压管路,是按拆解图的结构长出来的;整张图的色温和反光,也落在车间那套色板里。
它没有把 16 张图硬拼在一起,更像是先分清谁是人、谁是装备、谁是环境,再照新指令重新搭一场戏。三视图、服装库、道具、场景一起丢进去,批量出分镜、出电商图,抽卡次数能少一些。对靠这行吃饭的人来说,这比“再好看 10%”实在。
三道题做下来,我的感受是:生图模型上半场拼谁画得美,下半场拼谁听得懂人话。
老外晒过的那种爆炸图,我们也在 Harness 里试了。输入只有一页 ORB-7 结构参考:一张正面图、一张中心剖面、一份零件清单,全是平面的工程语言。
要求是把这盏微型探照灯沿光轴拆成七件,顺序不能错,螺钉只许三枚。
结果图里,七个零件从前盖到外壳一字排开,01 到 07 的引线一根都没指错,螺钉和孔位同样是三个。
拉丝铝、玻璃、橙色硅胶、绿色电路板、黑色阳极氧化金属,质感各归各的。电路板上那枚方形金色芯片、散热块外缘的散热槽,这些藏在清单小字里的细节也被它找了出来。右下角还照要求放了一张装好的成品小图。
它的路数是先读懂剖面图,搞清楚要拆的是什么物体,再动手拆。
看懂图纸这件事,过去的生图模型很难做到。
接着我们直接给 H3 Image 16 张参考图,故意出成一道“连线题”:4 个机器人的头、4 套衣服、4 件乐器,再加拱门、地板、月面、灯光各一张,谁配谁一点不能乱。出来的结果,一个都没连错。
这“脑子”是哪来的
这份“脑子”是分两步攒出来的。
第一步落在 H3 上。H3 从一开始就不只是视频模型,它要把文字、图片、视频、声音当作同一份上下文来读,再生成画面或视频。
所以预训练阶段,它就把图像这门基本功练得比较扎实。
第二步才是 H3 Image。底子有了,MiniMax这回把力气花在“后训练”这条链路上。
训练上用了强化学习,模型会反复调整,往更好的结果靠。出图要走的步数因此被压了下来。外面还套了一层提示词增强(PE):你随口丢一句,它会先把这句话补全,再开始画。
最后是部署优化,让它跑得更省、更快。
这条路 MiniMax 早有预告。
8 月 7 日的社区问答里,H3 团队就提过要做一个生成和编辑统一的图像模型。
「源神」这个称呼背后的账怎么算
H3 之所以被人抢着改,关键在于它开得够大方。
国内开发者管这种厂商叫「源神」,MiniMax这个名号是 H3 挣来的:开源不到一个月,下载量破 2400 万次,公开的衍生模型 300 多个。
fal 拿它做出了 H3 Max,海外开发者又用其搭了 24 小时不停播的「AI 电视台」。英伟达和 MIT 的研究者 10 月 28 日基于它开源了视频增强项目 Open-H3-Regenerate-2K,11 月 9 日还更新了一版。Pika 也发了自己的改款。
可开源了,钱从哪来? MiniMax的办法,翻译成人话就是:小店随便用,做大了再来谈。
按照 H3 的社区许可,年收入不超过 2000 万美元、且位于协议覆盖的地区,即可免费用于商业用途;一旦越过这条线,或者计划在美国、欧盟、英国、韩国部署,则需另行联系授权方。MiniMax 拿授权。
比如,ComfyUI 背后的 Comfy 已经在代理这类授权,专业版每月 5000 美元起;英伟达研究团队走的也是单独授权。
让全球工程师先在自己的显卡上把它跑起来,信任由代码本身积累,生意随后再谈。这三个月下来,H3 至少证明了一点:开源与赚钱并不冲突。
而图像的需求比视频密得多,游戏原画、电商图、工业设计,天天都在用。同样的打法搬过来,想象空间只会更大。
H3 开源公告的最后一行,是MiniMax那句老口号:Intelligence with Everyone。
把能力锁在订阅墙后面是一种活法,把钥匙发到每个人手里是另一种。
H3 Image 的权重、API 和在 Mcode 等平台的入口都已经开了。














