

40核老服务器无显卡跑通2.8万亿参数Kimi K3,傲腾内存成关键
在人工智能参数规模不断膨胀的今天,动辄数万亿参数的巨型大模型往往需要依靠昂贵的高端显卡集群才能驱动。然而,近日有玩家在社区分享了一次极具极客精神的极限测试:他仅凭一台没有插显卡、搭载40核处理器的老旧服务器,竟然成功让月之暗面的2.8万亿参数大模型 Kimi K3运行了起来。 挑战硬件极限:巨型大模型遇上老旧服务器 作
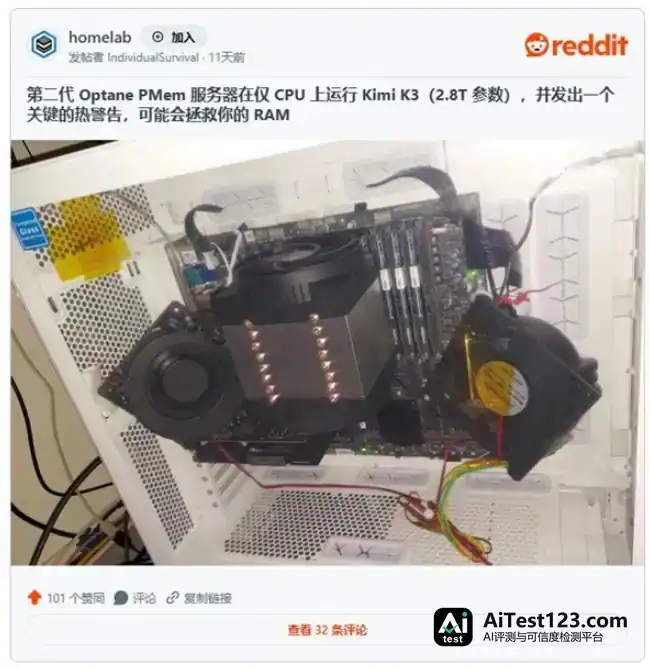
人工智能的参数规模越滚越大,动辄数万亿参数的巨型模型,通常都得靠价格不菲的高端显卡集群才带得动。不过近日有人在社区晒出了一次极客味十足的极限试验:一台没插显卡、装着40核处理器的老旧服务器,居然把月之暗面那个2.8万亿参数的Kimi K3给跑了起来。
巨型大模型撞上老旧服务器,硬件极限被摆上台面
Kimi K3是一款体量庞大的混合专家模型,总参数量2.8万亿,每个 token 只激活约1040亿参数,官方标称上下文高达104万 token。
这么大的数据量,即便压到极限的1bit 量化,也得数百 GB 内存才装得下,普通家用主板的承载能力显然不够看。该玩家于是剑走偏锋:用一颗40核的第三代至强可扩展处理器,配上英伟达已经停产的傲腾持久内存200系列,单条最高可支持512GB 容量。
停产傲腾内存被盘活,软件调配另有巧妙之处
软硬件怎么配合?该玩家用 llama.cpp,把傲腾持久内存设成 App Direct 模式,让程序直接把它当内存读写,而不是交给系统当硬盘缓存自行调度。
当然,这种非主流的平民方案,运行速度上的代价也躲不掉:
生成效率方面:1bit 量化下实测只有每秒0.85个 token;关掉直接访问(DAX)模式,最高也就每秒1.5个 token。
实际耗时方面:换到3bit 量化,速度约每秒0.75个 token。写几百字要等好几分钟,输出5万个 token 则要18.5小时。
温控也是道坎。傲腾硬件自身的功耗和发热不能忽视,英伟达数据表显示,该代产品单条功耗上限18瓦,介质温度到83摄氏度就开始降频,冲到85摄氏度会触发保护性关机。
英伟达其实早在2022年第二季度就着手收缩傲腾内存业务,当季计入5.59亿美元库存减值,这条产品线也就没有下一代了。这回的硬核运行,更像一次面向极限边缘的极客致敬与可行性验证。














