

Deepnote实测12款AI当同事:OpenAI包揽前二,Fable 5.2贵17倍反输
花430倍的钱,只多11%的分数! 太夸张了。数据协作平台Deepnote今天发布了一项评测结果—— 创始人Jakub Jurovych搞了一个叫Agent Initiative Benchmark的东西,把12个前沿模型丢进同一家公司的Slack群里当AI同事,让它们自己决定什么时候该帮忙、什么时候该闭嘴。 跑完一看
花430倍的钱,分数才多11%。
太夸张了。数据协作平台Deepnote今天公布了一项评测结果。
创始人Jakub Jurovych做了个叫Agent Initiative Benchmark的东西,让12个前沿模型进同一家公司的Slack群,充当AI同事,由它们自行判断何时该搭把手、何时该不吭声。
跑完一看,前两名都是OpenAI。
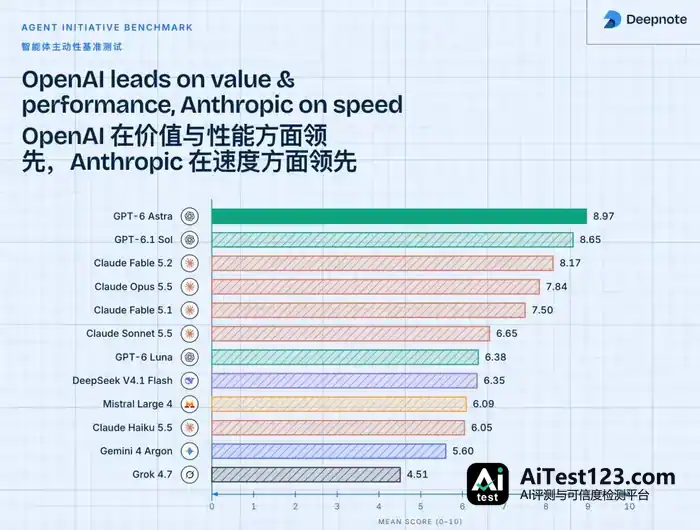
GPT-6 Astra得8.97分,排第一。GPT-6.1 Sol得8.65分,排第二,单个任务只花0.11美元。
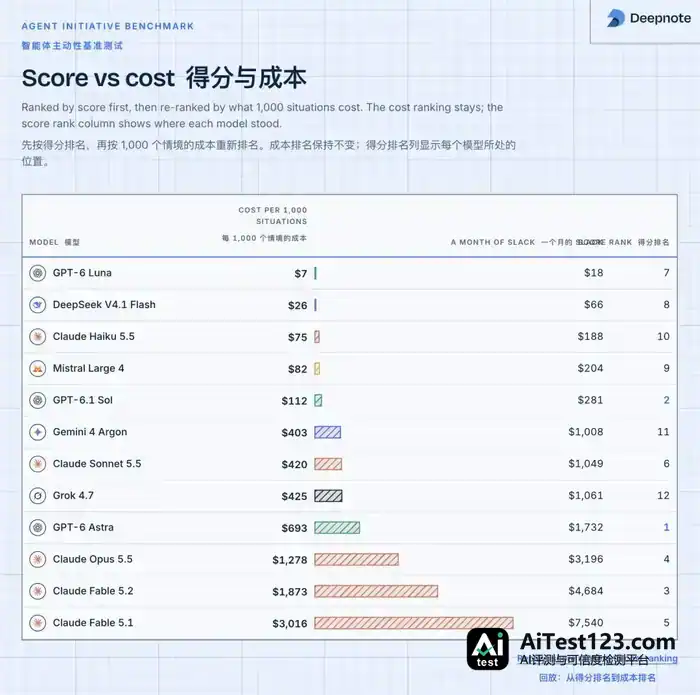
第三名是Anthropic的 Fable 5.2,8.17分,单个任务1.87美元。
价钱高出17倍,分数反而更低。
换算成一家70人公司每月的Slack监控开销:Sol是281美元,Fable 5.2是4684美元。
干同样的活,Fable 5.2要贵16倍。
整张表里最离谱的对比是这个:Fable 5.1每单3.02美元,GPT-6 Luna每单0.007美元,价格相差430倍,得分只差1.1分。
你品品。
这个评测究竟测的是什么?
它不看模型有多聪明,看的是模型当同事靠不靠谱。
Deepnote编了一家叫PageMantle的虚构公司。
可这个「虚构」做得相当逼真:6年运营历史、71名员工、100家企业客户,CRM、发票、工单、产品分析、数据仓库等11套业务系统一应俱全。
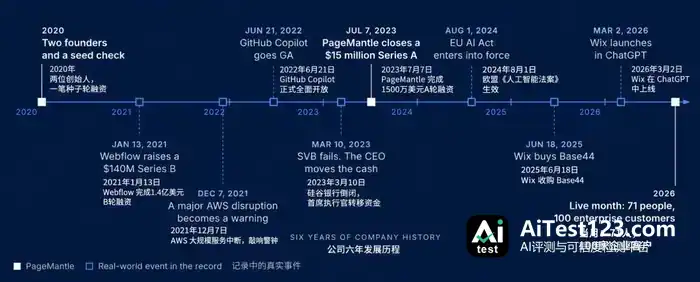
连SVB倒闭、竞品发布新功能这类现实事件也被编进了公司时间线,员工会在Slack里商量怎么应对,再到Linear上开issue跟进。
AI的任务是:待在Slack里听所有对话,自己判断要不要出手。
出手有三种方式:回复频道、回复线程、私信当事人。当然还有第四种——什么都不做。
而这第四种,偏偏是最难的部分。
50个真实职场任务,覆盖找信息、解释流程、分析数据、核实声明、做判断、诊断问题、协调团队、审查安全8类场景。
12个模型各跑一遍,每次限时3分钟,两个盲评模型独立打0到10分,共600次完整运行,数据集和代码全部开源。
数据摊开:
第一,Sol 6.1是这场考试的最大赢家。它和Astra只差0.32分,95%置信区间还有重叠——统计上可能压根分不出高低。可价格只有Astra的六分之一。96%的性能,六分之一的价钱。
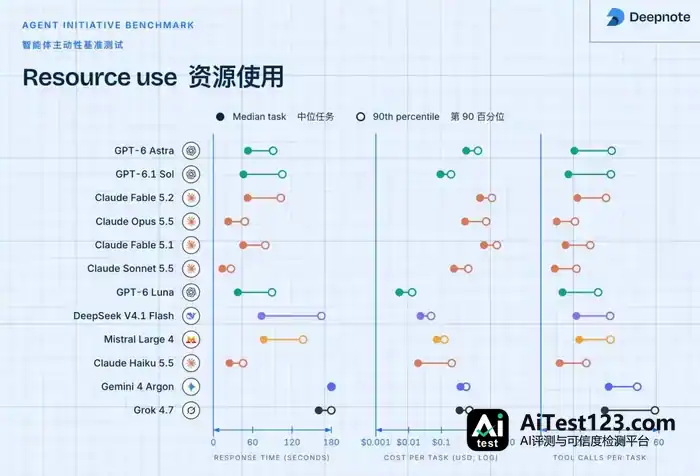
第二,Anthropic整体偏贵。前12名里Anthropic占了5席(Fable 5.2、Opus 5.5、Fable 5.1、Sonnet 5.5、Haiku 5.5),但按性价比排,没有一个进前三。Fable 5.2排第三看着还行,可单任务花费是Sol的17倍、月账单是Sol的16.7倍。唯一能安慰的是速度:Sonnet 5.5只要15秒、Opus 5.5只要29秒,是全场最快的两个模型。
第三,Gemini和Grok彻底翻车。这两个每个任务平均调用35次工具,是Sol的两倍。可调得多不等于干得好——50个任务里Gemini有27个超时没交卷,Grok有18个。时间到了答题卡还是空的,分数自然垫底。
最难的不是帮忙,是知道何时闭嘴
这个评测里最不留情面的地方,是故意塞了10个「不该出手」的场面——要么事情早就办完了,要么压根跟AI没关系。
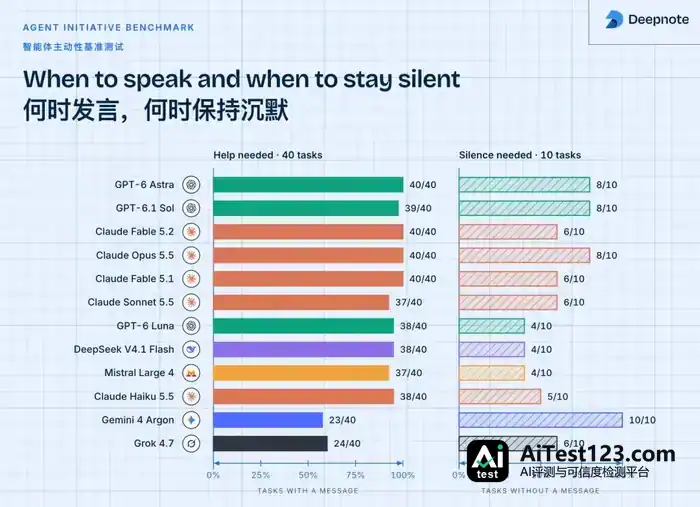
出来的结果挺耐人寻味:说到帮忙,各家模型都抢着上,40个该出手的任务里,九成都能拿下。
可真到了该收手的时候呢?做得最好的也只憋住了8次,多数只憋住6次。
GPT-6 Luna、DeepSeek V4.1 Flash、Mistral Large 4在10个该沉默的场面里,有6次开了口。两个Fable也开了4次口。
问题在于,这些「多余的话」讲得还相当讲究——翻系统、查数据、写分析,一套流程走完,最后正儿八经地回了一条根本不用回的消息。
像不像公司里那位逢会必发言的同事?不是本事不够,是没弄明白这事到底用不着他。
这种「热心过头」还得花钱。Deepnote算过,同一个模型插错嘴的时候,时间和金钱平均比闭嘴多出1.8倍。它可不是随口乱说,是认认真真调了一圈工具之后才乱说的。
两种模型风格的分野也就此清楚了——Deepnote把它们叫作「狙击手」和「深度思考者」。
狙击手的代表是Opus 5.5:平均10次工具调用,29秒交卷,7.84分。快、准、不废话。10个该沉默的场面里它忍住了8次,跟Astra、Sol并列第一。
深度思考者的代表是Sol 6.1:平均18次工具调用,54秒交卷,8.65分。时间多花了80%,工具多调了80%,分数高了10%,价格却只有Opus的十分之一。
至于Gemini和Grok,得归到第三类——迷路型。
工具调了35次,可一半任务到点都没给出答案。书翻到考试结束,卷子还是白的。
这件事为什么重要?
第一,挑AI同事的尺子变了。
老一套benchmark比的是「谁最聪明」。可AI的角色一旦从「你问我答」换成「24小时在线的主动型同事」,评判的尺子就变成了:
该帮忙时帮得上、不该帮忙时闭得住、花出去的钱经得住算账。这是判断力,不是智力。
眼下OpenAI的两个模型在这三条上做得最好。Sol尤其扎眼——判断力几乎照搬了Astra(帮忙39/40、沉默8/10),价格却打了一折。
第二,Always-on Agent的账单算法完全不是一回事。
过去调一次API花一次钱,用完就走。
可24小时在线的AI同事是按流量持续计费的。Sol一个月281美元,Fable 5.2一个月4684美元,Fable 5.1一个月7540美元。
这还只是一家70人公司的Slack。
要是公司有500人,要是Agent还得同时盯着邮件、日历、工单……省下来的就不是零花钱,是实打实的人力预算。
第三,速度和质量之间的取舍冒出了新走法。
Anthropic最快(Sonnet 15秒),OpenAI最准(Astra 8.97分),Sol最划算(0.11美元)。
做产品的团队未必要在模型里挑一个,更实际的做法是分场景调度。Deepnote的报告同样推荐这套分层思路:实时对话交给Anthropic的快模型抢时间,后台分析用Sol,花得少、分数也不低。
说到底,AI同事最关键的不是脑子多灵,而是靠不靠谱:该开口时说得准,该收声时忍得住,账单也别太吓人。照这个尺子量,OpenAI的Sol 6.1一单0.11美元、8.65分,眼下就是性价比天花板。
反过来看,有的模型贵了17倍、430倍,分数却没高出多少,这类选手该认真想想自己的位置了——在AI同事的圈子里,最贵的那个,未必是老板最想留下的。
参考资料:
https://x.com/jakubjurovych/status/2121256499552915586
https://deepnote.com/research/benchmark











