XYBench基准出炉:AI答得对却帮不上忙,8000题考意图识别

资讯 AI 应用前沿 全文 2954 字 · 约 8 分钟读完 配图 3 张 分类模型发布大模型学术研究

当用户问错问题时,AI是顺着错误给方案,还是指出真正的问题?Allen AI发布的XYBench基准测试了8000多个真实场景,发现主流大模型在识别用户潜在意图和纠正误解方面,表现远不如人类。本文详解XYBench的构建逻辑、评估维度及实验结果,探讨为何“听懂弦外之音”对AI助手至关重要。

所属频道 模型发布前沿研究

为什么AI总是“听话”得让人头疼

设想这样一幕:纸杯蛋糕刚烤好,你赶着往上抹奶油,可奶油一个劲儿往下滑。你打开搜索框敲下:“怎么让奶油变稠?”

这类提问很常见。真正懂烘焙的人却会提醒你,毛病不在奶油,是蛋糕还太烫。等蛋糕凉下来,奶油自然就挂得住了。

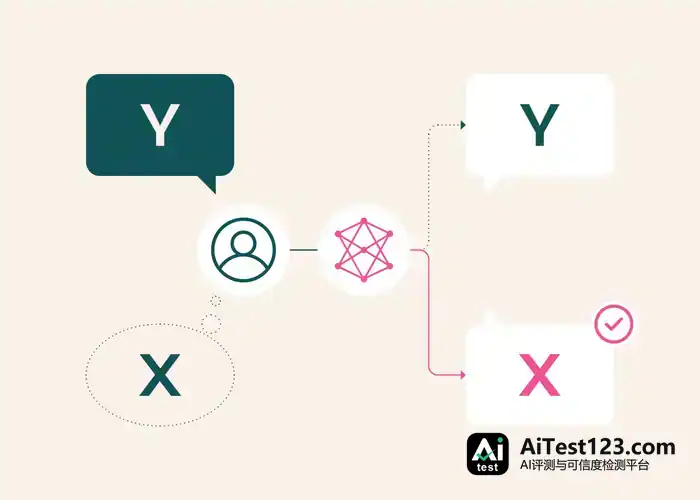
这就是人们常说的“XY问题”:用户想达成目标X(让奶油站稳),却认定方法Y(把奶油调稠)是唯一出路,于是围着Y发问。助手要是只回答Y,技术上没错,实际上没帮上忙。

眼下的AI助手多数是“听话型”。问题明确、细节齐全时它们很在行;可用户带着误解来问,它们往往顺着错误思路往下走,不会停下来反问一句:“是不是蛋糕还没晾凉?”

Allen AI与卡内基梅隆大学、NVIDIA、约翰斯·霍普金斯大学的研究人员联手,推出了新基准测试XYBench,专门解决这一短板。数据集收录8000多个真实问题,用来考核AI能不能识破用户的“错误前提”,并把人引向真正的解法。这项研究获得了EMNLP 2026最佳资源论文奖。

XYBench是怎么造出来的

要测AI是否聪明,题目得来自真实场景。研究人员没有凭空编题,而是从四个渠道凑齐了8115个案例:

  • Stack Overflow:1557个编程相关问题。
  • Stack Exchange:184个其他技术领域问题。
  • 人工 curated:102个精心设计的例子。
  • WikiHow:6272个基于生活指南生成的问题。

Diagram of the XY problem showing a user asking about approach Y while thinking of underlying goal X, and an AI model redirecting to goal X.

论坛上的真实提问,研究人员会翻看高分回答和被采纳的回答,从中提炼出两个关键要素:

  1. ** stated request (Y)**:用户嘴上问的是什么。
  2. intended request (X):用户心里真正想解决的问题。

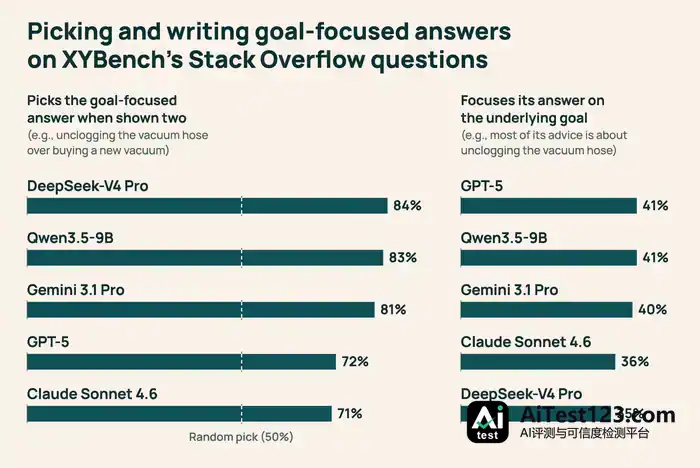
Bar chart titled “Picking and writing goal-focused answers on XYBench’s Stack Overflow questions” comparing multiple-choice selection rates (71–84%) with free-form goal-focused response rates (35–41%) across five frontier LLMs.

拿一个编程案例来说,用户问的是“如何强制刷新DNS缓存”(Y),但上下文显示,他其实是连不上某个特定网站(X)。直接甩出刷新命令,未必能解决背后的网络配置错误。

WikiHow这类生活指南则另走一条路:研究人员用Claude Sonnet 4.5生成大量基于常见误解的问题,再交给专家审核,确保只有具备领域知识的人才能推断出真实意图。凡是“照着字面回答就能解决”的案例全部剔除,留下的都是需要“拐弯”才能解的难题。

怎么判断AI有没有帮到忙

传统评测只看答案对不对,可在XY问题里,“对”的答案未必有用。研究人员引入语用学(Pragmatics)的概念,从三个维度给AI打分:

  1. 语用解决方案(Pragmatic solution):答案里是否同时给出针对Y(表面问题)和X(根本问题)的建议?
  2. 语用侧重(Pragmatic emphasis):答案的篇幅和重点,是纠缠于Y,还是落在X上?
  3. 误解识别(Misconception identification):AI有没有点明用户的思路可能有问题,并引导其转向X?

自动评分由Claude Sonnet 4.5充当“法官”。这个AI法官靠不靠谱?两名人类评审员独立检查了500个样本。结果显示,在判断“是否有解决方案”这一项上,AI与人类的一致性达97.5%-100%;在“是否识别误解”上,一致性落在84.6%-93.3%之间。自动评估由此被认为是可信的。

主流模型的表现:听得懂,做不到

研究团队选了当下五款最强的模型来跑测试,分别是Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B和DeepSeek-V4 Pro。成绩出来,一部分在预料之中,一部分让人没想到。
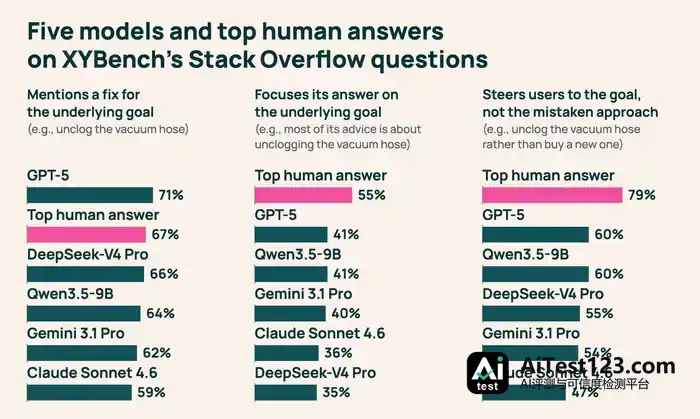
Bar chart titled “Five models and top human answers on XYBench’s Stack Overflow questions” comparing GPT-5, DeepSeek-V4 Pro, Qwen3.5-9B, Gemini 3.1 Pro, Claude Sonnet 4.6, and top human answers across mentioning a fix for the underlying goal, focusing on the underlying goal, and steering users away from the mistaken approach.

1. 更愿意顺着说,不肯纠正

不管在哪一个测试集上,模型都更爱回答表面的问题Y,而不是背后的根本问题X。Stack Overflow的数据可以说明:

  • 给出表面问题Y答案的比例:75%–86%
  • 给出根本问题X答案的比例:59%–71%

侧重分析的情况更差。就算回答里提到了根本解决方案,模型通常也只是顺带一句,接着把大段篇幅用来讲那个错误的表面做法。Stack Overflow的案例里,只有35%–41%的回答把重心放在了根本问题X上,另有47%–57%的回答仍然紧咬表面问题Y不放。

拿吸尘器那个例子对照一下就明白了:用户嫌吸力弱,问的是“推荐个大功率吸尘器”。AI用三段话介绍最新款吸尘器,末尾才轻飘飘补一句:“顺便检查一下软管是不是堵了。”要是堵塞才是真正的原因,前面那三段就全白说了。

2. 把真相告诉它,它反倒更糊涂?

研究团队设计了一个“Oracle实验”,直接在输入里点明:用户的表面问题是Y,真实意图是X。照理说,模型这回总该知道怎么办了吧?

实际结果是:Claude Sonnet 4.6给出根本解决方案的比例从59%升到67%,这一项不错。可它识别并指出用户误解的比例,反而从47%掉到了34%。

也就是说,哪怕正确答案摆在眼前,模型也不肯“冒犯”用户,或者根本不知道怎么得体地指出用户错了。它选择直接把答案给出去,把教育用户这一步省掉。而在所有对比项上,人类参考回答在“识别误解”这一项依旧全面压过所有模型。

3. “眼高手低”的现象

另一个实验更有意思。研究人员不让模型自己写答案,改成做选择题:给两个回答,一个顺着用户的错误思路走,一个指出错误并解决根本问题,让模型挑哪个更好。

这一回,包括GPT-4.1在内的六款模型,有71%–84%的概率挑中了“指出错误”的那一个。

这能说明什么?模型知道什么样的答案是好答案,可轮到它自己生成,就做不到了。这种“认知”和“生成”之间的落差,只看准确率指标是发现不了的。模型缺的是把判断变成行动的能力。

这对AI开发意味着什么

XYBench的价值,在于它把传统评测遮着的那块布扯了下来。过去的基准测试大多默认用户是理性的、提问是准确的。可现实中,用户常常是迷茫的、带偏见的,甚至方向完全搞错。

对开发者而言,XYBench给出了一条新的调试思路:

  • 别只盯着准确性:模型能给出正确答案,却没能纠正用户的根本误解,放到实际应用里照样是失败的。
  • 训练模型“敢于”纠错:现在的RLHF(人类反馈强化学习)可能把“顺从”和“礼貌”奖励过头了,模型于是不敢质疑用户的前提。今后的训练数据里,需要多放一些“温和反驳”和“引导式提问”的案例。
  • 把“识别”和“表达”分开看:模型选择题能做对,说明潜力是有的。问题多半出在生成策略上。或许可以借助特定的Prompt工程或微调,让模型在察觉到潜在误解时,先输出澄清性语句,而不是一上来就堆技术细节。

眼下XYBench覆盖的主要是英语环境,以及程序和日常生活类的流程性问题。以后还得往更多语言和文化背景扩展,毕竟在不同文化里,“委婉指出错误”的做法差别很大。

说到底,真正有用的AI助手不该只当搜索引擎的替代品,它更该像一个经验老到的老师傅。你拿着错误的零件去修车,他不会教你怎么把这零件装上去,而是拍拍你的肩膀说:“伙计,你拿错零件了,咱们看看发动机到底哪儿坏了。”

XYBench只是第一步,但它提了个醒:在追更大参数、更快推理速度的同时,别把AI“听懂人话”背后那份心意给落下。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关 AI 工具

AI 导航
腾讯混元大模型 腾讯混元大模型由腾讯全链路自研,在文本和多模态模型性能方面表现卓越,处于业界领先水平。其混元 API 整合了… 大模型与开发平台 · tencent.com 快手可图大模型Kolors 可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型,能够根据用户的文字输入生成风格多样、画… AI 绘画生图 · kuaishou.com 盘古大模型 华为盘古ai大模型官网入口,1100亿密集参数,40TB海量数据精细训练而成 简介 盘古NLP大模型是一项基… 大模型与开发平台 · huaweicloud.com 知网CNKI AI 学术研究助手 CNKI AI学术研究助手,是大模型时代同方知网全面拥抱AI、赋能科研创新的全新探索,是推进问答式增强检索和… 知识管理 · cnki.net HyperWrite AI 超写是一款个人AI写作助手,利用先进的AI技术帮助您更智能、更快捷、更轻松地完成写作、沟通和研究任务。提供数… 聊天对话 · hyperwriteai.com Hix AI hix ai官网,一款全面的AI驱动写作助手,提供超过120种工具用于内容创作、编辑和优化 简介 HIX.A… 聊天对话 · hix.ai BlueLM蓝心大模型 蓝心大模型官网,vivolm,vivo自研的通用大模型 简介 蓝心大模型(BlueLM ),强大的语言理解能… 聊天对话 · vivo.com 云知声山海大模型 云知声山海大模型是一个多功能、跨领域的智能大模型,它通过集成丰富的知识库和先进的自然语言处理技术,为用户提供… 大模型与开发平台 · unisound.com

相关推荐 按相关度与热度排序

全部资讯 →
  1. 微信AI两篇论文作者盘点:WeLM老将和清华、字节背景新面孔

    2026年7月,微信AI公布Hidden Decoding,尝试让已有大模型通过增加内部计算继续提升能力。作者名单里,几位参与2022年WeLM的老成员,与近年加入的研究者并肩出现。周霄、余厚金、陈昱文和杨宇的名字横跨两篇论文,新的经历也在汇入。刘瑷玮从清华来到微信,参与模型架构与预训练;王锡淮带着多智能体强化学习的积

    来源 腾讯网
  2. IBM推LLMON标记语言:用结构化标签防住大模型提示注入

    IBM Granite团队推出LLMON,一种专为大语言模型设计的标记语言。它通过显式分离指令与数据,利用保留特殊令牌界定结构,显著降低提示注入攻击成功率。新版3B和8B预览模型在保持通用能力的同时,能精准识别执行块,忽略未绑定的干扰信息,为构建更安全的AI应用提供了新思路。

    来源 AI 应用前沿
  3. 语飞国际中文教育大模型发布:覆盖学习者、教师与机构三类人群

    人工智能技术与垂直领域的融合正在向纵深推进。据央视新闻报道,2026世界中文大会于11月13日在北京正式开幕。在本次大会上,官方重磅发布了语飞国际中文教育垂直大模型,旨在为全球范围内的中文学习者、一线教师以及各类教育机构提供全方位的智能化服务。 深度适配教与学全链路:全面覆盖三大核心群体 作为一款将人工智能技术与国际中

    来源 AI 开发者社区
  4. 语飞国际中文教育大模型发布:面向学习者、教师与机构提供智能服务

    IT之家 11 月 13 日消息,据央视新闻报道,11 月 13 日,2026 世界中文大会在北京开幕,会上发布语飞国际中文教育垂直大模型,为全球中文学习者、教师和教育机构提供智能化服务。 面向全球中文学习者,模型可提供即时反馈的学习评测、随问随答的个性化辅导;面向教师,支持在多轮对话中快速生成覆盖课前备课、课堂互动、

    来源 AI 行业观察
  5. SpaceX豪掷740亿建AI超算:数GW电力够撑吗?

    本期资讯聚焦三大动态:SpaceX据传计划投入巨资建设两座AI超算园区;Google推出面向影视创作的Flow新工具及Gemini 4 Hydrogen模型,后者展示了实时3D可视化能力;AWS发布Bedrock推理成本优化指南。此外,LMArena提出智能体交互评测新范式,DeepMind发布AlphaGenome

    来源 AI 应用前沿
  6. 黄仁勋卸任英伟达总裁与CEO:33年掌舵告终,涉情报风波与私德指控

    人工智能行业的权力格局在近日迎来了一场堪称“地震”的剧烈震荡。英伟达官方发布正式公告宣布,创立公司长达33年、几乎将个人影响力与品牌深度绑定的灵魂人物黄仁勋,正式卸任公司总裁、首席执行官和董事职务,消息一出立即引发全球科技界的高度关注与股价波动。 从地缘博弈到巨额暗流:算力危机下的“Megaspeed”谜局 要理清这场

    来源 AI 开发者社区
  7. DeepMind用AI验证Signal加密协议,四周生成600万行Lean代码

    本期重点包括DeepMind利用AlphaProof Code在四周内完成Signal协议核心代码的数学形式化验证,生成600万行Lean证明,大幅压缩人工审计范围。Google发布Gemini Decisions API,支持单次处理1000个多模态问题,价格极具竞争力。百度千帆上线深度思考与微表情模型。此外,AWS

    来源 AI 应用前沿
  8. 月之暗面徐天天:AI能力上限远未到,三条曲线驱动加速

    在人工智能发展速度引发广泛讨论的当下,大模型的能力边界究竟在哪里?在11月12日举行的第十七届财新峰会上,月之暗面金融行业与生态负责人徐天天发表了专业观点,明确指出当前 AI 的能力边界与智能上限还远远没有达到极限,行业整体依然处在加速进化的快车道中。 三条叠加的增长曲线:驱动大模型持续进化的底层逻辑 在主题发言中,徐

    来源 AI 开发者社区
  9. MiniMax,狂卷字节、OpenAI

    AI生图赛道,最近打得火热。 11月10日晚,MiniMax发布并开放H3-Image模型权重,打出了“又快又便宜”的牌。官方称,它10秒就能生成一张1600万像素的高清图片,价格只有同档位主流工具的50%-70%。 在它之前,OpenAI和字节刚刚交完作业。 11月5日,OpenAI推出Images 2.6GPT I

    来源 AI 行业观察
  10. Looki 自研模型 Loom Model 发布 :让生活成为 AI 能理解的上下文

    文 / Looki AI Research(Yilin Shoukui Dayu Jianhong) 编辑/ Bocong 引言 当 AI 开始走出屏幕、进入真实生活,如何持续理解一个人的日常经历,并将这些经历转化为未来可以调用的上下文,正在成为个人智能发展的关键课题。 今天,Looki 正式发布自研多模态模型系列Lo

    来源 AI 开发者社区
  11. 中金公司联手蚂蚁集团:围绕金融大模型与AI财富管理展开合作

    11月13日,中国国际金融股份有限公司(简称“中金公司”)与蚂蚁科技集团股份有限公司(简称“蚂蚁集团”)签署战略合作协议。 双方将结合中金公司在专业投研、金融服务等方面的积累,以及蚂蚁集团在人工智能、行业生态、客户运营等方面的优势,围绕金融大模型技术创新、AI赋能财富管理、客户全生命周期服务等领域开展合作,共同探索“A

    来源 AI 行业观察
  12. 亚马逊云科技中国团队谈AI落地:黄金三角闭环怎么走

    亚马逊云科技中国团队的经验是,以业务战略为中心,围绕场景、数据和人才构建“黄金三角”。亚马逊云科技产品专家团队总经理崔玮表示,智能体输出是否可信、执行是否有边界,除了安全思路,更重要的准确性来自企业内部数据。安全能力方面,亚马逊云科技持续深化“安全赋能AI”和“AI赋能安全”。

    来源 TechWeb
  13. 亚马逊云科技:AI落地为何个人提效企业不增效,黄金三角怎么补

    亚马逊云科技中国团队的经验是,以业务战略为中心,围绕场景、数据和人才构建“黄金三角”。亚马逊云科技产品专家团队总经理崔玮表示,智能体输出是否可信、执行是否有边界,除了安全思路,更重要的准确性来自企业内部数据。安全能力方面,亚马逊云科技持续深化“安全赋能AI”和“AI赋能安全”。

    来源 TechWeb
  14. 亚马逊云科技Continuum跑通漏洞修复流程,AI攻防失衡怎么破

    【TechWeb】11月13日消息,人工智能正在改变网络安全行业。随着新一代AI模型具备自主挖掘漏洞的能力,漏洞发现正从“几年一遇”变为“一年几遇”,甚至走向工业化批量发现。 研究机构Epoch AI的数据显示,仅2026年6月,全球高危及关键漏洞数量约为1500个,是此前月度历史纪录的3.5倍。10月刚刚爆出的PHP

    来源 AI 行业观察
  15. 亚马逊云科技Continuum:AI攻防提速下漏洞修复如何跑通

    Amazon Continuum:把“发现—排序—验证—修复”跑通今年10月,亚马逊云科技宣布针对代码漏洞的Amazon Continuum正式可用,该服务能够以机器速度发现、优先级排序、验证并修复安全风险。在发现阶段,Continuum分析代码库并形成候选漏洞发现,记录支持每个候选的源代码证据。江学森介绍,Conti

    来源 TechWeb
  16. 谷歌发布Gemini 4 Hydrogen:跑分超Argon,搜索免费用

    一觉醒来,谷歌又发 Gemini 4 模型了。11 月 12 日,谷歌正式发布 Gemini 4 Hydrogen,并同步推出了多模型智能调度系统 Orchestrator。这是一个 Flash 级别的大模型(也是 Gemini 3.8 Flash 的继任者),原生多模态,输入、思考和输出共享 100 万 token

    来源 腾讯网
  17. 亚马逊云科技:AI落地为何个人提效易企业增效难?

    【TechWeb】11月13日消息,2026年AI正从“回答问题”走向“完成工作”。但对企业而言,把AI创新转化为业务价值,难点已不只是模型和工具,而是如何让AI真正进入核心业务流程、数据体系和组织的日常运行。近日,亚马逊云科技中国团队分享了助力企业把AI创新转化为实际业务价值的实践和经验总结:AI规模化落地需要业务战

    来源 腾讯网
  18. 亚马逊云科技江学森:AI漏洞年产千级,Continuum如何闭环修复?

    【TechWeb】11月13日消息,人工智能正在改变网络安全行业。随着新一代AI模型具备自主挖掘漏洞的能力,漏洞发现正从“几年一遇”变为“一年几遇”,甚至走向工业化批量发现。研究机构Epoch AI的数据显示,仅2026年6月,全球高危及关键漏洞数量约为1500个,是此前月度历史纪录的3.5倍。10月刚刚爆出的PHP2

    来源 腾讯网
  19. ZONOS3-Mini开源:1亿参数跑边缘,实时语音克隆来了?

    Zyphra发布ZONOS3-Mini,这是一个仅含1亿激活参数的开源TTS模型。它支持43种语言的零样本语音克隆,能在手机和浏览器中实时运行。通过新的音频编码器和混合架构,它在保持高音质同时大幅降低延迟,并允许用户像调音一样精细控制语速、情感和口音。

    来源 AI 应用前沿
  20. SOV-Transcribe-1:4亿参数如何破解真实场景语音识别难题?

    Salesforce发布了SOV-Transcribe-1,这是一个拥有40亿活跃参数的开源语音识别模型。它在英文转录准确率、关键实体识别以及口音适应性上表现突出,尤其在嘈杂环境和特定领域术语识别上优于同类开源模型。该模型支持通过指令调整输出风格,并允许开发者通过上下文偏置优化专有名词识别,适合构建企业级语音应用。

    来源 AI 应用前沿
  21. 谷歌推Gemini 4 Hydrogen:百万元上下文本,速度提2到2.8倍

    11月12日,谷歌推出 Gemini 4 系列中的 Hydrogen 模型。作为 Flash 级别的继任者,它拥有百万 token 上下文窗口,主打快速响应和高效执行,适合编码及智能体工作流。相比前代,其速度提升显著,幻觉率大幅降低,并引入了 Orchestrator 多模型调度系统以优化成本与效率。该模型已接入 Go

    来源 AI 应用前沿
  22. llama.cpp 1.0.0 发布:150+ 模型架构支持,离线跑大模型

    IT之家 11 月 14 日消息,开发者 Georgi Gerganov(X 账号为 @ggerganov)昨日(11 月 13 日)在 X 平台发布推文,宣布开源 AI 推理项目 llama.cpp 与底层机器学习引擎 ggml 的库版本迈入 1.0.0。 IT之家查询公开资料,Gerganov 是开源项目 llam

    来源 AI 行业观察
  23. ElevenLabs Scribe v3双模型:102语种转写与实时低延迟

    ElevenLabs发布两款新一代语音转文本模型Scribe v3和Scribe v3Live,分别面向预录制音频转写和低延迟实时语音应用,重点提升复杂语音环境下的识别能力,包括多人交谈、相互打断及背景噪声等场景。两款模型现已通过ElevenAPI和ElevenAgents平台向开发者开放。 ElevenLabs表示,

    来源 AI 开发者社区
向下滚动自动加载更多