GitHub被AI代码挤爆:9月提交73.8亿次,一次宕机7小时
一场宕机撕开AI编程的隐藏瓶颈
8月17日,全球程序员碰上了一场集体宕机。
代码写完点推送,进度条卡在原地;自动测试不动了,合并请求合不进去,AI编程助手Copilot也断了线。
这一停就是7个多小时。那天,全世界的开发者都在等它缓过来。
三天之后,GitHub首席技术官Vlad Fedorov发文致歉:
他说,如果你那天正准备发布软件,是我们让你失望了。

他解释,流量冲到了新高,美国中部数据中心有个关键组件没跟着扩容,压力一路蔓延,多项服务接连垮掉。
GitHub把这起事故定性为「容量失败」。这已是他们8月里第二起大事故。
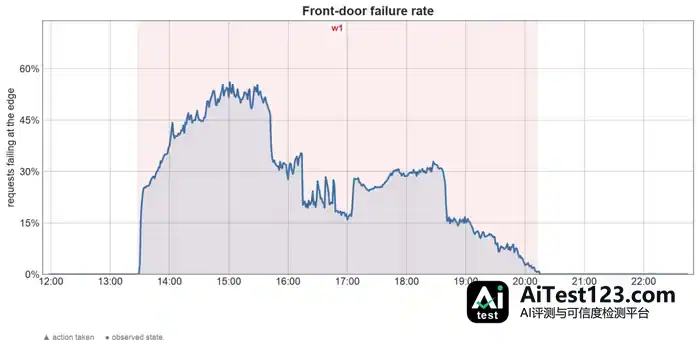
GitHub官方图表显示:8月17日故障期间,入口处的请求失败率一度超过50%。
其实3月和4月,Fedorov就发文讲过提升GitHub可靠性的举措。他在推文里说,这些工作到现在还在做。
GitHub上的流量究竟涨到了什么程度?
今年9月,开发者和AI智能体在GitHub上提交了73.8亿次代码,是一年前的五倍多。
人们还在惊叹AI写代码的速度,GitHub宕机却把一个问题摆上了台面:写出来的代码,往哪儿放?
答案就在GitHub这半年遇到的麻烦里:AI写代码的瓶颈,已经从「写得出」挪到了「存得进、合得上」。
到底是谁把GitHub挤爆了?
先分清程序员写代码的两个动作:
提交(commit),是给代码在本地存个档;
推送(push),是把存档传到GitHub上。
人类程序员通常是写完一段才存一次档。AI智能体不一样,它是个「保存狂魔」。
GitHub工程师在官方博客里写道:智能体几乎每做一步,就要存一次档。推送次数也跟着猛涨,达到原来的4.9倍,从每月6.9亿次冲到33.5亿次。
8月的时候,Hacker News上就有网友挑刺:提交次数再多,GitHub真正要处理的还是推送,这个指标有水分。
随即有人反驳:「一次推送带100次提交,比只带1次提交更耗资源。」
这话的意思是,提交得推送了才到GitHub,可一次推送里装的提交越多,GitHub要干的活就越重。
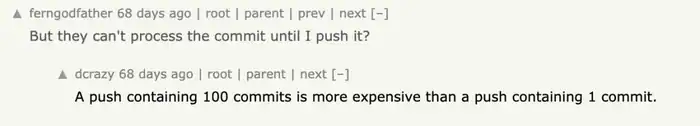
Hacker News网友围绕「提交次数算不算数」吵了起来。
这句反驳正好戳中GitHub的痛处:智能体偏偏最爱「碎碎存」。存得越碎,次数越多,压力就越大。
更要命的是,每次推送后头还拖着一长串「连环Call」:代码刚传上去,自动测试和代码扫描就一拥而上,同一份代码被反复拉取。繁忙仓库里,一分钟能拉上千次。这情形就像你刚交完卷子,几千个机器人同时扑上来批改。
9月,GitHub自动化流水线(Actions)跑了32.6亿次,比一年前多了4倍还不止。
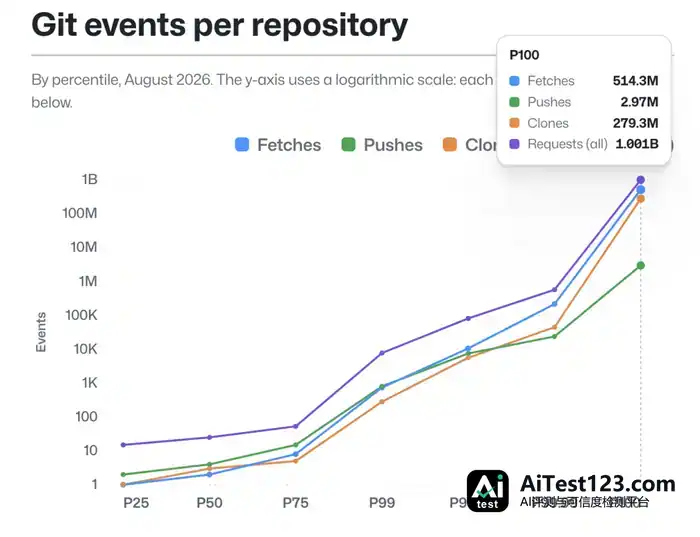
GitHub各仓库的忙碌程度差得离谱:2026年8月,最忙的那一个仓库就扛了约10亿次请求。纵轴每往上一格,数量翻10倍。
据The New Stack报道,GitHub把这一波增长主要算在「智能体需求」头上:一批从没见过的新用户来了,不睡觉,24小时在线,最爱干的事就是按保存键。
为什么备份越多
存得越慢?
看明白智能体的疯狂劲儿,就更能体会GitHub老架构的难处。为了防丢,也为了给读代码的人分流,GitHub默认给每个仓库存5份完整备份,摊在5台服务器上。
人类时代,这套设计稳得很:丢一份不慌,读的人多了也能分流。GitHub也正是靠这套老架构,撑住了10亿个代码仓库。
可到了智能体时代,死穴露出来了。头一个堵点在「存档」。
老规矩是,每存一次新代码,5份备份全都得参与,最后速度看最慢的那台服务器。这好比公司请了5个会计合记一本账,每笔新账都得5个人签完字才算入账,最慢的那个签完才算数。
一次还只能记一笔,前一笔没签完,后一笔就得排队。查账的人一多,公司就得多请会计,可会计越多,签字流程拖得越长。
在老架构里,读和写互相拖后腿。GitHub越想加备份来分担读的压力,存档就越慢。智能体偏偏每分钟都在存档,每一次都得等会计们签完字。
更危险的是,备份坏得太多,存档会直接停摆。就像会计病倒一大片,这本账就没法再记下去。
第二个堵点在「合并」。所有代码改动,最后都要汇入同一个主分支。
一年间,GitHub上的合并量涨到原来的近4倍。这好比上千辆车挤向同一个收费站。
排队到底有多慢?GitHub工程师在博客里算过一笔账:一个仓库的备份分在两地时,GitHub自家机房离微软云约1600公里,来回一趟约25毫秒,存一次档要来回好几趟。
更棘手的是,一个仓库同一时间里只允许一笔写入通过。上一笔还没存完,下一笔就得原地等着。25毫秒对人类程序员来说连眨眼都不够,可放到智能体身上,这就成了效率的硬顶——智能体干得多快,得看一次推送多久能完。
多年来GitHub最拿得出手的就是稳,结果到了智能体时代,这份稳反倒成了堵。
先砸硬件
电,先不够用了
流量冲上来,GitHub头一个想到的是添机器。到8月为止,他们已经多装了300多万个CPU核心和120PB存储。
可尴尬的是,机房没电了。Fedorov在复盘里写得很直白:老机房的电力能带多少硬件,他们就装了多少。
不光是机房的电见底,连机房所在那片地区的供电都到了上限。插座全插满,再想加机器,只剩下搬家一条路。
于是GitHub加快往微软云(Azure)搬:5月时微软云只扛了12%的工作量,8月这个数字已经到约58%。
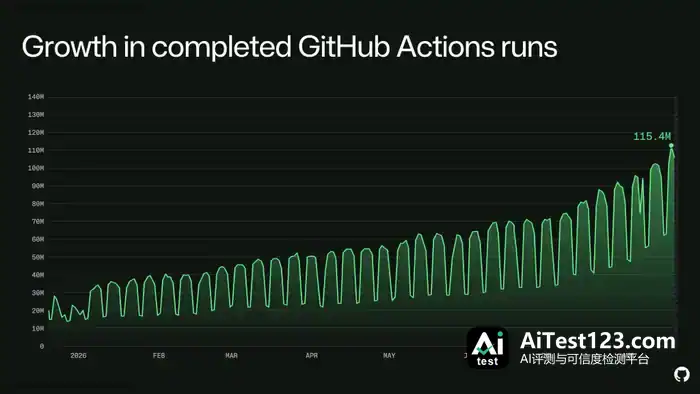
2026年初到8月,GitHub Actions每天完成的运行量从大约1500万—3000万涨到了约1.15亿。
10月28日的GitHub年度大会上,基建数字又翻了一轮:今年累计新增400万个CPU核心、160PB存储(约合1.6亿GB),网络带宽多了每秒50Tb。
但微软高管Jay Parikh当天在博文里还是交了底:只加容量不够,架构也得动。砸钱堆硬件买来的只是喘口气的时间,底层架构的老毛病治不好。
换底座
账本和柜台,分开
架构这刀怎么下?还是拿前面那5个会计的比喻说。
老做法是每个会计守一个柜台,怀里揣着一整本账,既得招呼客人查账,又得低头记数。
新做法是把账本收进总库,柜台只负责接待。代码统一存到微软云的大仓库里,防丢和备份交给仓库兜着,前面的服务器卸了包袱,专心接请求。
拆开之后有三样好处。头一样,读写分开。
来读代码的人再多,也拖不慢存代码的速度。前台柜台能随开随关,流量来了多开几台,流量走了就关掉,哪台坏了换一台立刻补上。
第二样,多余的确认环节也砍了。一次推送里真正需要所有人点头的,只剩下「更新分支指针」这一步。往仓库里搬货、查完整性、扫泄露的密钥,各干各的,不用排着队干等。
第三件事,是把后台的活儿挪走。
过去清旧数据,直接在接客的机器上动刀,等于跟正常访问抢算力。如今这类活儿交给了专职的「清洁工」机器,在后台对着仓库一点点收拾。
内部测试的数字是:新架构每秒能吃下的写入次数,峰值提升到原来的35倍。
难的地方在于,这场大手术得在GitHub照常开门的情况下做完。
打个比方,这就像是飞机正在万米高空飞着,得顺手把发动机换掉。
GitHub一断
你的智能体也得歇
有人可能想,GitHub扩不扩容,跟普通写代码的人有啥关系?
关系大了。
无论你使的是哪家大模型、外面套的是哪个智能体框架,它写出来的代码,大量仍要推到GitHub上去。
8月17日GitHub宕机那天,Cursor恰好发布了自己的代码托管平台Origin,外界把它看成GitHub的替代选项。
可就在同一天,Cursor的状态页也贴出了公告:
GitHub这次故障牵连了Cursor的部分服务,自动化和云端智能体都在其中,前后持续6小时6分钟。
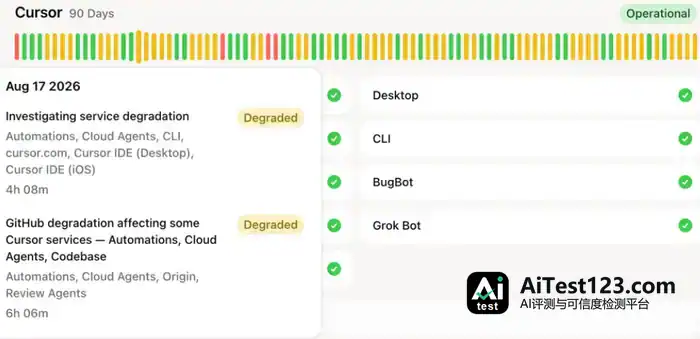
Cursor状态页的说明是:8月17日GitHub故障波及部分服务,持续6小时6分钟。
托管代码这件事有了备选,智能体的工作流却仍旧绕不开GitHub。
当天下午,Hacker News上一个问「GitHub替代品有哪些」的帖子被顶到649分。代码大本营也会出岔子,程序员们开始认真琢磨备胎。
更耐人寻味的是,GitHub一面被智能体塞满,一面还在造更多智能体。
10月28日的大会上,GitHub又拿出一批新工具,让智能体能并行干活。
AI把写代码的成本压得越低,瓶颈就越不会消失,只是往后挪。
头一关是「写得出」,大模型已经解决了。眼下这一关是「存得进」,GitHub正在拆账本、换底座。
再往下是「合得上」。
GitHub的工程师自己也不讳言:下一道坎仍在写入能力上。当年把GitHub带到10亿个仓库的那套办法,撑不起下一个10亿。
更往后,是「谁来签字」。
GitHub在博客里立了一条规矩:智能体干的活越多,代码的主人就越得能审、能懂、能拍板,没过审的改动,不许进主分支。
通往ASI的路上,这一步很关键。
AI写代码这件事已经成了,但真要让它把软件交付出来,整套按人类敲键盘速度搭起来的底子,都得推倒重来。
被逼到墙角的,GitHub 不会是最后一个。
微软高管 Jay Parikh 此前给出过一个很大胆的判断:
人类到今天为止写下的全部软件,加起来恐怕还占不到未来五年软件总量的 1%。
他这话哪怕只对了一半,等代码多到根本审不完的那天,比 CPU 更紧俏的东西,会是一个始终点得下去的提交按钮,外加一个敢拍板合并的人。