斯蒂格利茨发问AI版权案:十年后谁还写被白嫖的真话
当法学争侵权、DOJ谈竞争,诺奖得主斯蒂格利茨却问:信息生态会否因“合理使用”而崩塌?
眼下这桩OpenAI公司版权侵权诉讼案(In re OpenAI, Inc. Copyright Infringement Litigation),很可能会成为近几年AI版权领域最具代表性的案子。它把针对OpenAI和Microsoft提起的十二起诉讼并到了一处,原告里既有《纽约时报》,也有大批书籍作者和剧作家;此外,行业团体、学者、艺术家、创意工会、AI公司、政府官员递交的“法庭之友意见书”越积越多。判决还没下来,案子已经摆出了各方利益的广度和分歧,从某个角度说,未来“信息的生产模式”怎么走,也要看这一判。
这些意见里最打眼的一份,是2026年9月美国司法部出具的“利益声明”。它的态度很直接:拿受版权保护的作品训练大模型,“原则上属于合理使用”;还补了一句更实际的考虑——强制许可只会让美国在与对手国家的AI竞争中落了下风。另一边,二十多位版权法学教授的看法相反:AI训练算不上转化型使用,受保护的表达与原告作品里的根本事实、思想缠在一起分不开,所以被告的行为构成侵权。
2001年诺贝尔经济学奖得主、哥伦比亚大学教授约瑟夫·斯蒂格利茨(Joseph Stiglitz)也站进了这场争论。法学教授们讲侵权,司法部算产业政治账,他则另提了一个能算、也更冷静的问题:假如法院认定AI使用版权内容“不违法”,十年之后,还有没有人肯写那些被白嫖的真话?
信息不是普通商品,而是公共品
斯蒂格利茨的切入点,正是他研究了一辈子的命题:信息的外部性极强。
外部性说的是,一笔交易的成本或收益,落到了第三方头上。工厂排污、路人吸霾,代价由社会扛,这是负外部性;养蜂人让隔壁果园多结了果,果园主没掏钱,收益却多了,这是正外部性。
在斯蒂格利茨教授看来,信息的外部性尤其强。传统新闻业里,一篇深度调查报道可能要做几个月、花上百万,读者看完转述给朋友,朋友白得了信息;自媒体把事实重新包装一遍,流量也白拿走——原创者两头都收不回全部价值。
到了现在,大模型把文章读进去,把事实、叙事、判断压成参数,再拿这些参数去回答千万用户的问题,用户自然就不必再回到原来的媒体平台了。
媒体原本靠点击、订阅、广告来反哺下一轮有价值的报道。可当“信息”的收益绝大部分外溢给平台、聚合器和AI系统,生产成本却几乎仍全压在原创者这边,这门生意就撑不下去了。
所以说,信息不是普通商品,它带着公共品的属性——一个人用不影响别人用,想拦住别人用也很难。纯商业性质的市场里,信息生产一定供给不足,毕竟没人愿意一直花钱做一件让全世界免费搭车的事。传统新闻业倒是靠“内容吸引读者、读者吸引广告”跑通了一套补偿机制,让信息生产转得起来。
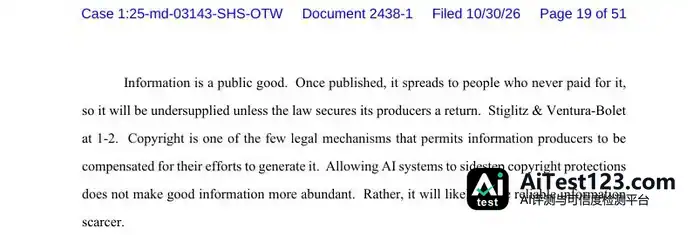
生成式AI一出现,这套补偿机制最后那点回流也被切断了。
信息越高效,真相反而越少
斯蒂格利茨最鲜明的观点,藏在他早年提出的格罗斯曼–斯蒂格利茨悖论(Grossman–Stiglitz paradox)里:金融市场中,价格若已把所有人掌握的信息完美反映出来,理性人就没有动力再去收集信息;可要是没人收集,价格也没法持续更新、完美反映市场。价格机制在信息传递上因此存在内在冲突——价格既汇总市场信息,又离不开个体主动收集信息的能力。
按这个理论,信息越“高效”,生产新信息的激励就越接近“零”。
斯蒂格利茨教授把这套逻辑搬进了AI与内容生态。大模型让“已有信息”空前好找,用户一提问,答案自动又快速地合成出来,根本不用点开任何原文。短期看是效率飞跃,长期却可能翻出“反效果”:媒体拿不到点击,广告缩水,调查报道团队被裁,原创供给减少;大模型训练语料里“高质量人类知识”的新增内容一旦变少,系统就更多依赖自己生成的文本,质量随之衰减。
他在模型里设了几个变量:
信息传输效率
平台甲流注意力的比例
用户辨别真假的能力
制造谎言的相对成本
AI一出现,前两个变量同时被推高,后两个被压低:传播更快了,平台拿走的注意力更多,普通人更难分清真假,造假的边际成本则越来越逼近零。
结果并不是大多数人以为的“知识大爆发”,反倒更可能滑向“信息丰富、知识枯竭”的颓势:屏幕上堆满看似用户需要的答案,生产真相和知识的产业却在萎缩。他甚至把“信息崩塌”的风险边界提出来当预警。
当然,斯蒂格利茨教授并没有下“AI必然毁灭新闻业”的结论,也不反对效率本身。他的论点是有条件的:在缺少溯源、归因、授权结算机制的前提下,放任“免费抓取-合成输出”,会系统性地掏空信息产业的上游。风险不在模型发展本身,而在制度没跟上模型的发展。
给判决一个“未来维度”
美国司法部(DOJ)站到AI产业这边、力挺“合理使用”,说到底是怕“竞争力”掉队。在它看来,一旦训练被认定侵权,美国AI产业就会放慢脚步,国家安全也要跟着受损。于是它把训练和输出切开,把市场损害收窄到“只是相似替代”这一层。
法学家反过来反对“合理使用”,盯的是“创作者的主体地位”。版权法的根本约定是:法律给创作者一段有限的垄断,换他把表达贡献给社会。人类学习要订阅、要付费、要买书、要交学费,AI公司凭什么能绕开这些,直接把该付钱的内容拿走?在他们眼里,AI在这个过程里不是一种“产业”,而是和人类创作者并排站着的“竞争者”。
DOJ把“创新速度”当成最高价值,法学家认为“创作与回报的契约”更要紧,斯蒂格利茨的目光却落在看得见的“未来”上。他其实是用一个问题回敬DOJ:创新所依赖的原料是谁生产的?将来还有没有人接着生产?他拿模型和计算结果去撬DOJ那套“普惠叙事”——AI让知识更便宜,所以就该免费使用。他警告,普惠不能建在透支公共资源的地基上。信息就像一片森林,免费砍树造纸,纸确实能便宜,可不会再有人种树了。版权制度本来就是让种树人拿到回报的机制。要让信息源源不断、质量还高,既不能禁止砍伐,更不能让人打着“合理使用”的旗号随便砍。
这位经济学家给出的法律结论相当克制:不是一律禁止AI训练,而是谨慎适用“合理使用”,把输出端的替代、对原创市场的侵蚀、以及可建立的授权机制一并纳入判断。创新的收益不该只按资本和技术来分,也要让内容的原始生产者得到激励。借用他附录里的比喻:做饼的人,不能连饼渣都拿不到。
以往案例分析“合理使用”,习惯看“这一次适用对整个市场”的影响,DOJ用的也是这个框架。可大模型训练是大规模、跨年代的,今天喂进去的信息,决定了未来模型怎么回答世界;而未来模型回答得深不深、好不好、真不真,不只取决于技术,更取决于今天的高质量信息是多是少、是真是假。这条责任链,或许能一路追到这类AI版权案的判决结果上。
科技公司上市估值时,通常默认“训练数据免费”,几乎把信息当成“空气”。斯蒂格利茨用经济学点出信息的特殊之处:信息背后,是有人持续花钱、冒风险、负责任撑起来的一条供应链。AI公司如果只做抽取者,不对上游有所回馈,长远看消耗的也是自己乃至全人类的生产资料。
一个比“是否合法”更难的提问
从法律角度看,OpenAI等AI科技公司很难绕过现行版权逻辑,但美国国家竞争的逻辑会力争把这条路拓宽。斯蒂格利茨的意见则抛出一个经济学问题:我们真的愿意活在一个“创作者寥寥无几、模型互相喂养”的信息世界里吗?如果答案是不,那怎么让信息生产有所回报?
这也是不同国家监管路径背后的一条重要逻辑,也是亟需解决的问题:并非一定要保护既得利益者,而是要保护下一代的知识、艺术、信息的原创者和说真话的人。