清华团队推出ATW框架:让AI在仿真世界里做实验推演物理
GPT-6 Astra等模型能生成逼真视频,但往往不懂物理规律。清华大学团队提出ATW框架,让AI基于视频构建可仿真的物理世界,并自主设计实验来预测运动或回答反事实问题。该方法无需额外训练,在多项物理推理基准上准确率大幅提升,为AI理解真实物理世界提供了新思路。
画面看着挺真,一运动就出问题
如今的生成式AI本事不小。让它渲染一段球滚下斜坡的视频,光影、纹理都能做得干净漂亮。可要是追问一句“斜坡换成冰面,球会滚多快”,或者“半路加块挡板,球会停在哪”,多数模型就答不上来了。
这背后是AI眼下的一个尴尬:画皮容易,懂骨难。几何形状和外观能靠海量数据拟合,可质量、摩擦系数、阻尼这些决定物体怎么动的物理属性,光看像素很难看出来。结果就是生成的视频里物体常常穿模,运动轨迹也不符合常识。
光靠堆算力、训练更大的语言模型,恐怕解决不了这个问题。得让AI学物理学家那套:先观察,再建模,最后用实验验证猜想。
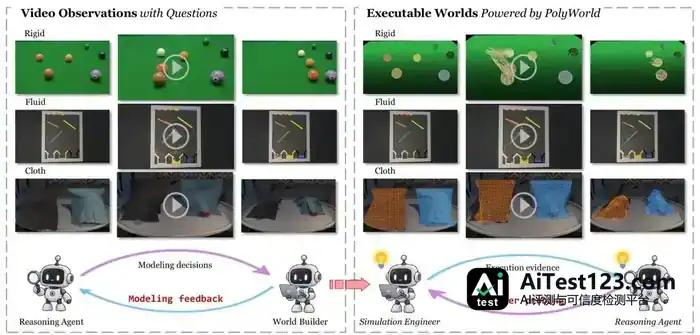
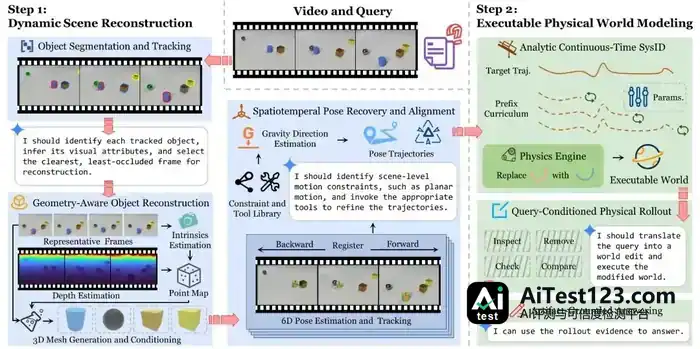
清华大学团队提出的Asking the World(ATW)框架,就是往这个方向走的一步。它不直接猜答案,而是根据视频重建一个能跑起来的物理仿真世界,再在这个虚拟世界里做实验,由此预测物体运动、回答复杂的物理问题。
从“看图说话”转向“动手实验”
ATW的思路说起来很朴素:既然盯着视频直接猜不准,那就把视频里的场景还原成一个能操作的数字孪生体,在里面跑仿真。
这套方法沿用了团队此前PhysMind的工作逻辑,但自主性更强、适用范围更广。整个流程分成两个阶段:世界建模和世界探测。
第一阶段:世界建模
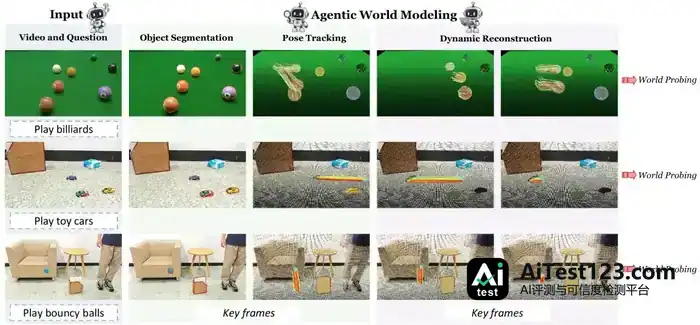
AI看到一段视频,先要弄清场景里有什么,而不是急着答题。智能体会识别物体,恢复它们的三维形状和运动轨迹,再结合地面、支撑关系对结果做校正。
光知道有个球在动还不够,还得知道它多重、表面滑不滑。系统用连续时间解析方法,从物体滑行时的减速、碰撞前后的速度变化里,估算摩擦系数、质量比例和碰撞恢复系数。这个过程在控制理论里叫“系统辨识”。
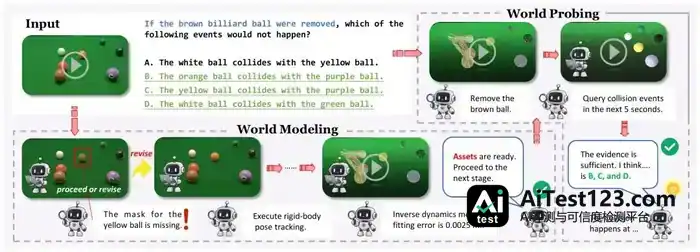
有意思的是,ATW加了反馈机制。建模时如果发现漏了某个物体,比如台球桌上有个黄球没被分割出来,智能体会自动补做检测、调整感知模型,直到重建场景与视频观测尽量对齐。也就是说,同一段视频只需建模一次,后面各种问题都能复用这个已经校准好的物理世界。
第二阶段:世界探测
模型建好,才轮到真正动脑。面对不同的问题,智能体要自己决定做什么实验。
- 问的是物理属性,比如“哪个球更重”,它直接查拟合出来的参数。
- 要预测未来,比如“接下来会发生什么”,它就把仿真时间延长,看物体怎么动。
- 碰到反事实推理,比如“如果拿走那个方块,球还会撞墙吗”,它会复制当前场景,移除指定物体,重新跑仿真看结果。
第一次实验证据不够,智能体还会主动发起新的查询或实验。这种自主决策的能力让ATW比以往方法更灵活,不再依赖硬编码的规则。
不只刚体:布料、流体也能算
过去的物理推理研究大多盯着刚体碰撞,也就是那些硬邦邦、不变形的物体。可真实世界复杂得多:衣服会皱,水会流,绳子会打结。
为处理这些情况,团队开发了物理仿真引擎PolyWorld Engine。它基于Warp构建,支持刚体、软体、布料、绳索、流体,以及它们之间的耦合交互。
智能体通过统一接口,在这个引擎里搭建场景、读取状态、推进仿真。对可变形物体,ATW不只比较位置,还比较形状、表面或中心线随时间的变化。仿真结果和视频对不上时,智能体会判断是物体对应关系错了,还是物理模型选错了,然后回到建模阶段修正、重新拟合参数。
这一拓展让ATW能处理的场景从简单的积木碰撞,延伸到更贴近现实的多种材料交互。
效果如何?数据说话
想判断重建出来的世界到底符不符合物理规律,光看视频复现得像不像远远不够。更关键的一点是,它能不能帮AI把题答对。
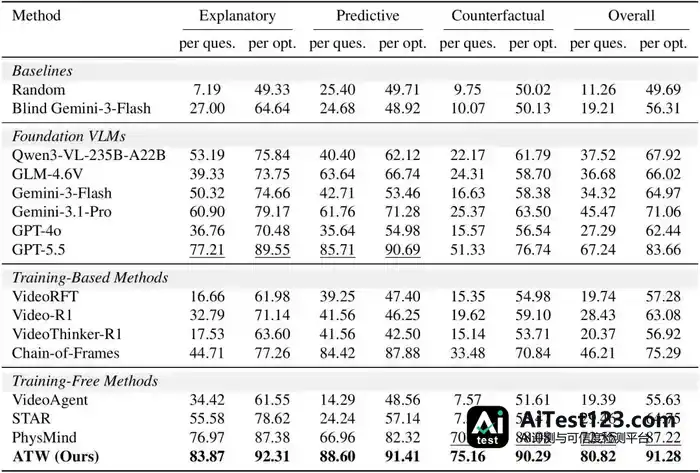
团队拿两个主流物理推理基准测了ATW。CLEVRER主要考因果推理和反事实问题:基座模型选Gemini-3-Flash,ATW整体准确率到80.82%;同一个模型直接看视频作答,只有34.32%。算下来整整高出46.50个百分点。跟此前的工作PhysMind比,也多了8.27个百分点。
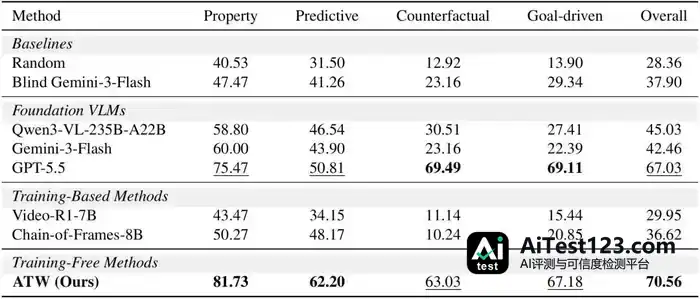
ContPhy覆盖的材料和连续介质现象更多。ATW总体准确率70.56%,直接回答则低了28.10个百分点。
真实场景里的结果更出人意料。实拍的台球、弹跳球和玩具车一共60段视频,ATW准确率71.67%,直接回答只有33.33%。从合成数据往真实世界迁移,这条路子看来走得通。
为什么这很重要?
成本是第一个原因。ATW不用额外训练大模型,也不用微调。它借现成的视觉语言模型(比如Gemini-3-Flash)去理解问题、挑选操作,运动计算则交给物理引擎。跟调用 GPT-6 Astra这类端到端大模型相比,Gemini-3-Flash的调用开销低不少,大规模部署更划算。
第二个原因是可解释。黑盒模型丢给你一个答案,它怎么想的你基本无从得知。ATW不一样,每一步都摆在外面:认出了什么物体、估算了哪些参数、做了哪些干预实验。结果错了也能回头查,看是建模出了岔子,还是仿真参数不对。
还有一层意义,是给AI理解物理世界蹚出一条新路。与其让AI死记亿万张物理现象的图片,不如教它建起内部模型,用“思想实验”把结果推出来。这种基于模型的推理(Model-based Reasoning),被看作通往更通用人工智能的关键一步。
局限当然也有。眼下系统辨识还比较依赖理想的观测条件,遮挡严重或者光照复杂时,参数估计容易偏。仿真引擎的计算开销同样不可忽视,实时性还有提升余地。

不过,让AI从“旁观者”变成“实验者”,这一步迈得挺有意义。说到底,AI只有真正弄懂重力、摩擦和碰撞,它生成的世界才不至于只是好看的幻觉,而是能预测的现实。
相关资源: