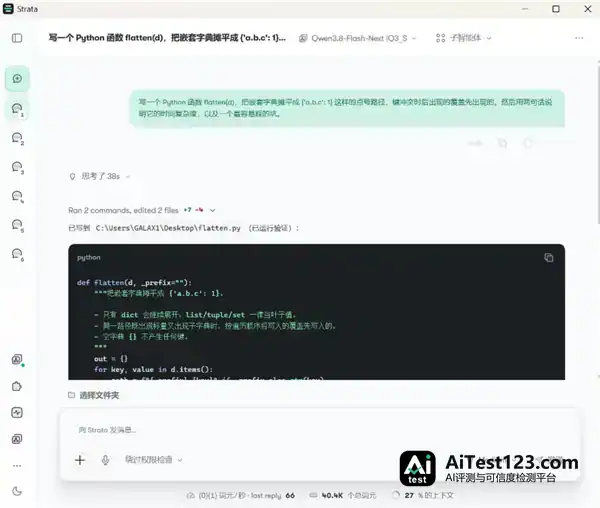
Strata引擎让RTX 5070跑通125B模型:每秒83字

资讯 快科技 全文 2009 字 · 约 6 分钟读完 配图 14 张 分类开源端侧 AI

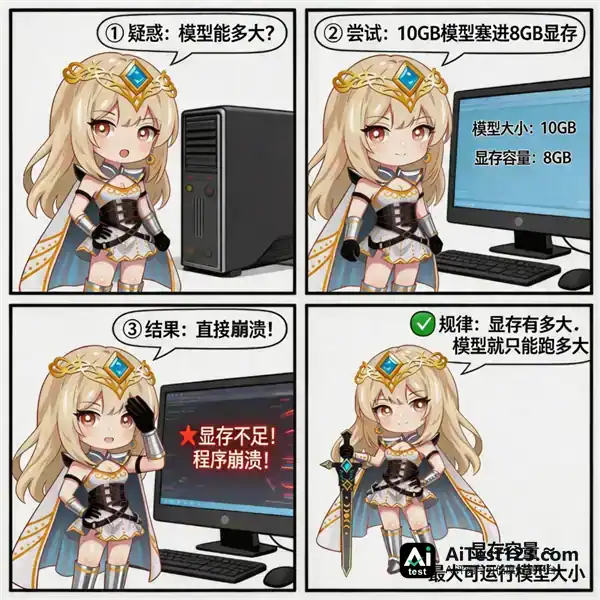
放在两年前,这句话几乎没有人会相信,因为本地部署有一条不成文的规律:显存有多大,模型就只能跑多大。 例如12GB 跑 12B,16GB 跑 16B,想跑 125B,起码得 80GB 以上显存的设备。但如今,它

所属频道 AI 硬件与终端开源生态

两年前说这话,基本没人信。本地部署有条不成文的规矩:显存多大,模型就只能多大。
一个开源引擎 让50系显卡跑通了125B模型!

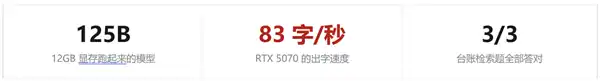
12GB 跑 12B,16GB 跑 16B,想上 125B,设备起码得有 80GB 以上显存。现在它真跑起来了:每秒输出 83 个汉字,还挺聪明。
一个开源引擎 让50系显卡跑通了125B模型!

撑起这件事的开源项目叫 Strata。它靠什么做到的?手里的 RTX 50 系显卡能不能跑?下面用实测说话。

01 Strata 是什么?

Strata 是个开源引擎,专治「模型比显卡大」。这次测的模型是「Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S」,125B 参数、3.5bit 量化,文件 83.6GB;一张 RTX 5070 的显存只有 12GB。好比 83 本书,要摊在一张只放得下 12 本书的桌子上。
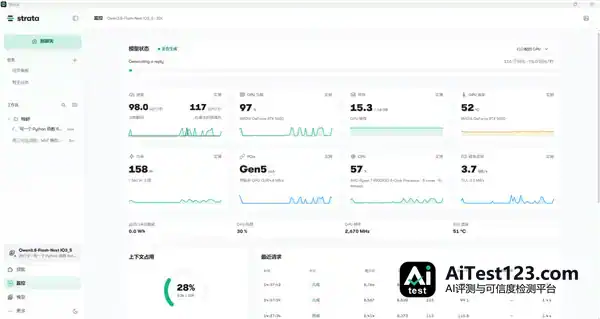
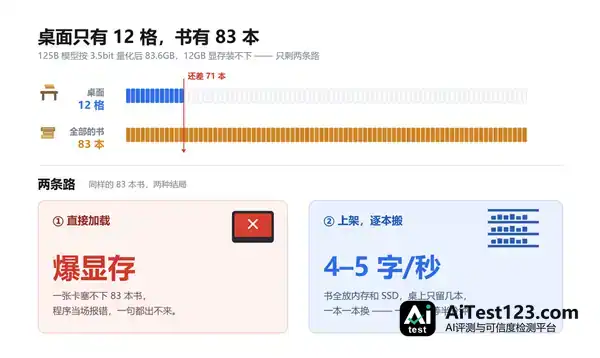
一个开源引擎 让50系显卡跑通了125B模型!

一个开源引擎 让50系显卡跑通了125B模型!

以前的软件碰到这种局面只有两条路:要么直接报错(爆显存),要么把书全堆到身后书架上,桌面空着,再一本本拿上来翻。速度只有每秒四五个字,一句话得等半分钟。
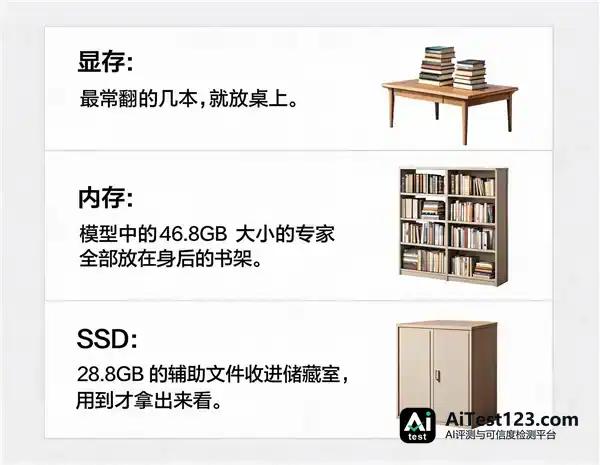
一个开源引擎 让50系显卡跑通了125B模型!

Strata 走了第三条路:桌上只留马上要用的,其余搁书架和储藏室,用完就换。于是分三层放——显存放最常翻的几本;内存里搁模型 46.8GB 大小的专家,全在身后书架上;SSD 收着 28.8GB 辅助文件,用到才取。所以快不快,主要看你要用的那本书是不是正好在显存里、放不放得下。125B 的大语言模型能在消费级显卡上跑,原因就在这。

02 实测:影驰50系显卡跑125B大模型

测试用同一台机器、同一个模型、同一组参数,全程只换显卡:影驰 RTX 5070 圣刃 OC(12GB)和影驰 RTX 5080 HOF Extreme(16GB)。

一个开源引擎 让50系显卡跑通了125B模型!

03 结果一:5070可跑125B_Q3版模型

一个开源引擎 让50系显卡跑通了125B模型!

三轮日常提问加生成代码的测试里,单流速度实测为 65.1(5070圣刃)和 87.5(5080 HOF)tok/s。模型按 token 计数,中文一个 token 约合 1.28 个字,折成汉字就是每秒 83 个和 112 个,问答流程很顺。
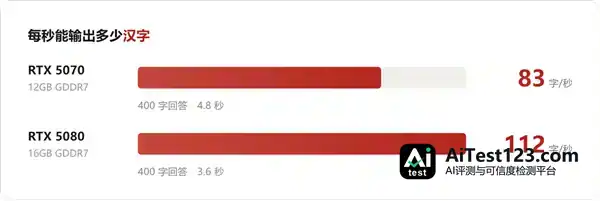
一个开源引擎 让50系显卡跑通了125B模型!

拿日常场景举例:Agent 给一段 400 字的回答,5070 等 4.8 秒,5080 等 3.6 秒,实际差 1.2 秒。

04 结果二:速度上,5080比5070快 34%

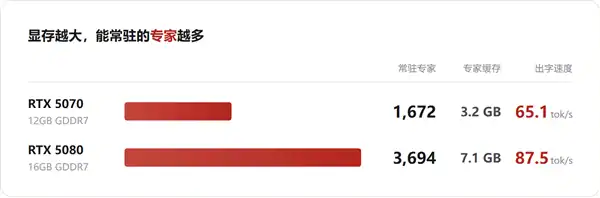
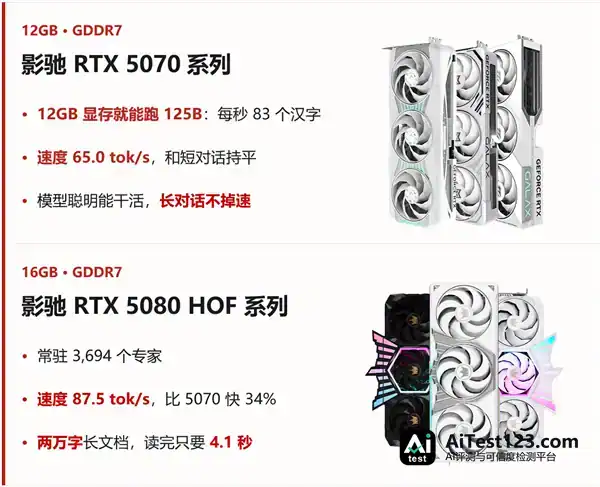
这次 Strata 实测中,单流速度主要由一件事决定:显存装得下多少专家。对照结果一的数据,5080 跑 87.5 tok/s,5070 跑 65.1 tok/s,前者快 34%。差别就是桌面上能摆多少本专业书,也就是专家缓存:5080 的 16GB 能常驻 3694 个,5070 的 12GB 只有 1672 个。多出来的 4GB 显存实打实装进了更多专家缓存,这也是它 token 输出更快的原因之一。
一个开源引擎 让50系显卡跑通了125B模型!

05 结果三:125B模型装进50系显卡也能干活

快不等于对。模型压得越狠,越容易犯三种毛病:说话重复、算数出错、看长文漏行。从 16bit 压到 3.5bit,好比报价时把「38.6 元」记成「39 元」——省下四倍多空间,精度却缺了一块。
一个开源引擎 让50系显卡跑通了125B模型!

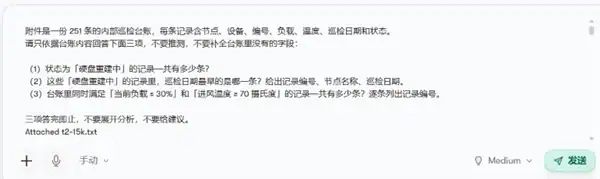
测试时我们丢给模型一份 2 万字、251 条的硬盘运维台账,问三个必须真读过材料才答得出的问题。

一个开源引擎 让50系显卡跑通了125B模型!

结果两张卡三道全对,而且每份回答都能精准定位原材料。压得狠会不会变傻,这下不用担心了。

06 结果四:聊久不掉速,但第一句回复要等

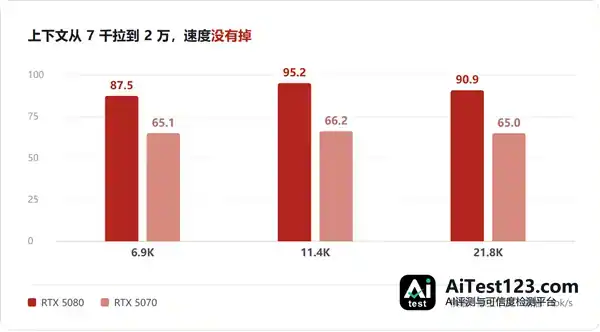
大模型有个通病:聊得越长,答得越慢。这次我们分别把三份不同长度(6.9k、11.4k、21.8k 个 token)的文字发过去提问,看速度会不会随上下文变长而下降。
一个开源引擎 让50系显卡跑通了125B模型!

实测下来速度并没有往下掉。最长那一档(最右侧深红色)里,5080 仍然跑到 90.9 tok/s,反倒比短对话的 87.5 略高一点;5070 为 65.0 tok/s,与短对话(最左侧淡红色)的 65.1 基本持平。
一个开源引擎 让50系显卡跑通了125B模型!

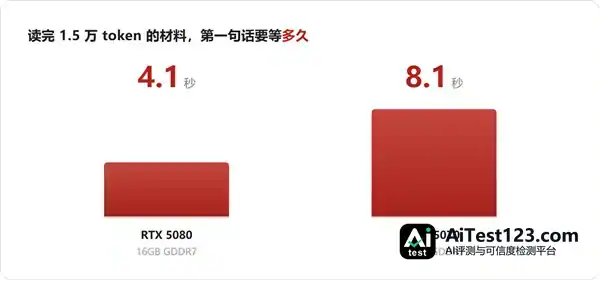
长文场景下,两张卡真正的差距集中在开头那一步(Prefill):模型得先把整份材料读一遍,才能吐出第一个字,这一环 5080 明显占优。同样一份材料,5080 读完用 4.1 秒,5070 则要 8.1 秒。材料读完后继续追问,出字速度就回到原来的水平。经常要分析长文档的人,用 16GB 显存的 5080 HOF 显卡部署 Strata 会更省心;只是偶尔问几句、写写代码,12GB 的 5070 圣刃也完全够用。

07 Strata跑125B模型应该用哪张50系显卡?
一个开源引擎 让50系显卡跑通了125B模型!

按这次测试的相近配置来看,显存余量更大、能常驻更多专家的影驰 RTX 5080 HOF 系列,更适合用来部署 Strata 跑 125B 大模型;日常问答、优化代码、处理文档这类用途,影驰 RTX 5070 系列跑起来同样流畅。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 黄仁勋卸任英伟达CEO,Hugging Face掌门人喊话守住开源

    英伟达 11 月 12 日宣布掌门人黄仁勋即刻卸任总裁、CEO 与董事三职。消息刚落,Hugging Face 首席执行官克莱芒·德朗格就在领英写下长文。他连用两个"糟透了"表达错愕:"我真希望这一切从未发生,这真是令人无比难过的一天",并承诺公司将"比以往更努力"地守住开源人工智能,强调此刻"不能放慢脚步",开源阵营

    来源 AI 开发者社区
  2. 黄仁勋辞任英伟达CEO:委员会拍板或拖慢决策,美国开源AI恐成输家

    SemiAnalysis创始人Dylan Patel指出,失去“创始人模式”的英伟达恐陷入“委员会决策”的低效泥潭,极难维系对供应链的低价绝对掌控。受此波及,高度依赖英伟达资金与算力的美国开源生态将成最大输家,而算力结构更多元的闭源巨头Anthropic反成受益者。此外市场需高度警惕监管扩圈,算力云租赁及“AI合成数据

    来源 华尔街见闻
  3. 韩国端侧AI芯片路线图:2030年前完成10款开发验证

    IT之家 11 月 12 日消息,韩国产业通商资源部当地时间今日公布了该国端侧 AI 半导体技术开发项目的路线图,目标通过这一总额 8,002 亿韩元(IT之家注:现汇率约合 39.93 亿元人民币)的项目到 2030 年完成 10 款 AI 芯片的开发和验证。 这十款芯片中 3 款面向智能家电,自动驾驶、协作机器人、

    来源 AI 行业观察
  4. Runway推出Praxis-1:视频预训练迁移机器人控制

    IT之家 11 月 12 日消息,美国视频 AI 公司 Runway 昨日(11 月 11 日)宣布推出机器人模型 Praxis-1,将视频预训练中学到的知识用于真实机器人控制。该模型开放权重,采用 Apache 2.0 许可证,开发者可在自有硬件上运行和微调。 Praxis-1 模型的设计思路,是让 AI 先从普通视

    来源 AI 行业观察
  5. Hugging Face CEO 哀叹黄仁勋从英伟达离职:承诺继续力挺开源 AI

    IT之家 11 月 13 日消息,黄仁勋昨日(11 月 12 日)辞去英伟达总裁、首席执行官及董事职务,即刻生效。Hugging Face 首席执行官克莱芒 · 德朗格(Clement Delangue)随即在领英发文,称这是“令人无比难过的一天”,并表示将继续更坚定地推动开源人工智能。 IT之家昨日报道,联合创始人黄

    来源 AI 行业观察
  6. 黄仁勋离职,英伟达的开源路线还能走多远

    黄仁勋的辞职让外界重新审视英伟达对开源AI的投入。从收购Hugging Face、发布开放权重模型,到公开反对监管限制,这家芯片巨头在领导层过渡期能否延续其开源路线,成为行业关注焦点。本文梳理英伟达开源战略的三大支柱及其面临的不确定性。

    来源 AI 科技快讯
  7. 黄仁勋退出Hugging Face:129亿美元收购下开源AI走向何方?

    英伟达CEO黄仁勋退出Hugging Face后,Hugging Face CEO公开承诺继续为开源AI而战。此举正值英伟达129亿美元收购案引发行业对开源AI未来走向的广泛质疑。分析认为,这场围绕开源与商业利益的博弈,将深刻影响全球AI生态格局。

    来源 AI 科技快讯
  8. 魔兽世界:无限上线,耕升RTX 5060 Ti 8GB踏雪X3 OC实测

    作为暴雪在 MMO 领域的全新布局,《魔兽世界:无限》自公布起就牵动着无数玩家的目光。它既不是正式服的资料片续作,也不是单纯的怀旧服复刻,而是以经典艾泽拉斯为基底,填充海量原创内容的独立

    来源 快科技
  9. NaiveAI开源模型Naive-N0.5-Flash,获Latent Space首期实测

    梦瑶 发自 凹非寺量子位 | 公众号 QbitAI国产大模型,又杀出一匹黑马!而且这回,还是被硅谷超火的硬核AI技术媒体Latent Space亲自实测出来的。就在11月10日,Latent Space推出全新模型测评栏目,专门做「不带立场」的新模型实测。而栏目首期,其就把目光投向了中国公司NaiveAI的开源模型Na

    来源 腾讯网
  10. 谷歌LiteRT Tensor API发布:C++直连端侧,模型开发免重写

    谷歌推出 LiteRT Tensor API,一个轻量级 C++ API,让开发者可以直接面向端侧构建、定制和优化机器学习模型。谷歌表示,它兼顾原生模型开发的灵活性与跨平台可移植性。 谷歌表示,传统方法是开发者使用 C++ 手动编写计算逻辑以获得最大控制权,但存在明显的短板: 实现代码与特定后端(如 Metal、Ope

    来源 AI 行业观察
  11. Edera推对象能力权限模型:AI智能体与凭证隔离成看点

    Edera 推出了对象能力受限权限模型,承诺保护自主 AI 智能体工作负载的安全,使自主 AI 工作负载和模型上下文协议(MCP)服务器与敏感凭证隔离。该技术由 Edera 联合创始人、杰出工程师 Ariadne Conill 牵头。她因对底层开源安全技术的贡献而知名。该技术通过直接在虚拟机监控器层实施细粒度的对象能力

    来源 AI 行业观察
  12. MiniMax 推出开源 SOTA 生图模型 H3 Image,稳居全球开源榜首

    人工智能图像生成领域迎来全新突破。人工智能企业 MiniMax 正式开源了其全新的原生4K 直出图像模型——MiniMax H3Image。凭借出色的生成速度与顶尖的画质表现,该模型一经推出便成功登顶开放权重图像模型榜单的第一名。 核心性能:10秒极速出图,支持16张参考图协同 在技术架构上,MiniMax H3Ima

    来源 AI 开发者社区
  13. 黄仁勋卸任英伟达CEO:RTX显卡会不会被边缘化?

    【TechWeb】英伟达官宣黄仁勋卸任总裁、CEO及董事职务,外界除了关注这家AI芯片巨头的接班人选,游戏玩家心里还悬着另一个问题:曾经撑起英伟达半壁江山的GeForce RTX显卡,未来会何去何从?其实不用等这次换帅,答案的走向早已显现。随着全球AI基础设施建设持续升温,英伟达的业务重心早已转移——数据中心的收入规模

    来源 腾讯网
  14. 文心ERNIE 5.5 Flash Preview亮相:280B参数,11月25日前开源

    人工智能开源生态迎来又一重要进展。百度文心 ERNIE 官方博客近日正式发布了全新模型 ERNIE5.5Flash Preview。作为此前 Base 模型的首个后训练版本,该模型在架构规格、上下文处理能力以及多场景智能体(Agent)应用展示上交出了一份亮眼的成绩单,并明确承诺其模型权重将于11月25日前全面开源。

    来源 AI 开发者社区
  15. Fireworks AI被入侵:Notion约1%用户聊天记录外泄

    Fireworks AI遭遇网络攻击,部分客户数据遭窃,Notion约1%的用户受到影响。Notion本周进一步证实,部分使用Notion AI“Insights”功能的用户聊天记录遭到泄露,涉及模型在对话中输入或输出的内容。 Fireworks AI是一家面向开发者提供开源AI模型访问与调用服务的平台。该公司表示,攻

    来源 AI 开发者社区
向下滚动自动加载更多