谷歌TPU整柜外售开闸:第八代四款齐发,推理每美元性能压过GB200五成
“英伟达一家独步天下的日子快要结束了”
“英伟达一家独步天下的日子快要结束了。”
衡宇 发自 凹非寺 量子位 | 公众号 QbitAI
英伟达最近头疼的事儿可不止老黄那一件。
本周谷歌又拿出两款新TPU芯片,一款盯机密推理,一款盯长上下文。加上上半年那两款,第八代TPU眼下已有四种配置。
一年之内连推四款TPU系统,这在谷歌还是头一回。而谷歌对TPU的盘算,恐怕比外人想的要大得多——
同样是在今年,谷歌第一次把TPU系统卖到了外部。
量子位从谷歌内部人士处打听到,谷歌内部底气很足,称“明年TPU市场份额会快速上升”,到时候“会有更多大型企业大规模使用TPU”。
性能上,他们的信心也不小。
起码在谷歌高层人士眼里,“英伟达一家独步天下的日子快要结束了”。
(苏妈:咩啊?.jpg)
△图片由AI生成
“像英伟达一样”,对外销售TPU系统
今年谷歌做了一个违背祖宗的决定——
决定:首次向外部客户销售整套TPU系统。
量子位从接近谷歌的人士处了解到,拍板推动这件事的,是一位进谷歌不到三年的高管。
内部争论很大,他仍坚持调整TPU的商业战略,最后说动管理层下了决心,“像英伟达一样”把TPU卖给外部客户。
△图片由AI生成
最早在2013年,TPU不过是谷歌为压低自家AI业务算力成本而自研的专用加速芯片;到2018年,Google Cloud才开始把TPU算力对外出租。
云上租赁这种形式,意味着TPU相关的硬件基础设施全由谷歌自己管理运营。
时间快进到今年Q1财报会,CEO劈柴哥说,谷歌看到AI实验室、资本市场公司以及高性能计算应用领域对TPU的“强劲需求”,于是宣布面向部分精选客户,支持他们把TPU部署在自有数据中心里。
内部把这轮外售看成一次“以售养研”的结构性置换——拿外部订单分摊数据中心的天量资本开支,再用规模化需求反哺自研硬件的成本曲线。
Q2起,谷歌开始向客户交付完整TPU系统。
这套系统涵盖计算、存储、网络硬件及软件等一整套能力,训练和推理相关服务也一并提供。
△图片由AI生成
这条生意路子,眼下已经能见到进账。
Google Cloud今年的增速一路往上抬。Q1同比涨63%,Q2涨82%;到Q3,收入做到307亿美元,同比增长103%,经营利润也从35.94亿美元升到111.21亿美元。
(小声说一句,Q3财报里大概只有Google Cloud这块让人看着不皱眉)
谷歌母公司Alphabet说得很明确,TPU系统销售是第三季度Google Cloud增长的重要来源之一。
最新的10-Q里,Alphabet已把“产品销售,主要为TPU系统”写进Google Cloud收入项下。管理层预计,TPU系统销售在Q4还会继续放大。
不过TPU系统销售合同收入的大头要到2027年才进报表,眼下财报上还没体现,这个势头却多半挡不回去了。
为什么拖到今年才动手?
说到底,谷歌把TPU拿出来卖,是自身演化加上外部条件一起推出来的结果。
劈柴哥在Q2财报会上讲过,谷歌内部对前沿AGI的算力需求仍是不可逾越的红线;可这两年高端GPU一直紧俏,找英伟达买不到货的客户,只能另找门路。
这个窗口,谷歌想抓住。
2025年推出的第七代TPU Ironwood,本就是冲着推理专门设计的。到今年的第八代,谷歌又把训练、实时推理、机密计算和超长上下文分别做成不同的系统配置。
谷歌芯片业务负责人Amin Vahdat对外放过口风,说“未来属于专业化”。这话的意思,是想拿专业化芯片路线去撼动英伟达“一颗通用芯片包打天下”的说法。
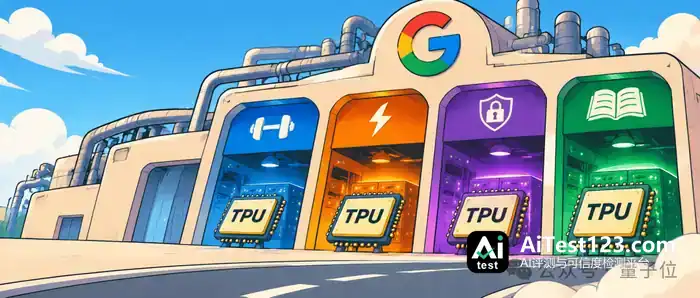
△图片由AI生成
另一头,谷歌在TPU软件生态上疯狂补课,一锤一锤往下砸。
英伟达这些年最硬的牌之一就是CUDA生态。它早早把AI开发者的工具箱备齐,大批软件都围着CUDA做过适配和优化。
主流AI框架PyTorch,对CUDA的支持最成熟。
业界常见的做法,是用PyTorch搭模型,再经CUDA调英伟达GPU,生态壁垒就这么垒起来,很难替换。
可谷歌TPU有很长一段时间深度绑着TensorFlow、JAX,软硬件栈跟GPU差得远,迁移门槛不低。
2025年年中,谷歌拉上Meta的PyTorch团队一起做TorchTPU,目标就是只改少量代码,就能让PyTorch模型在TPU上跑起来。
上个月底,TorchTPU这项合作的成果正式开源。
效果会怎样,这里就不多说了。
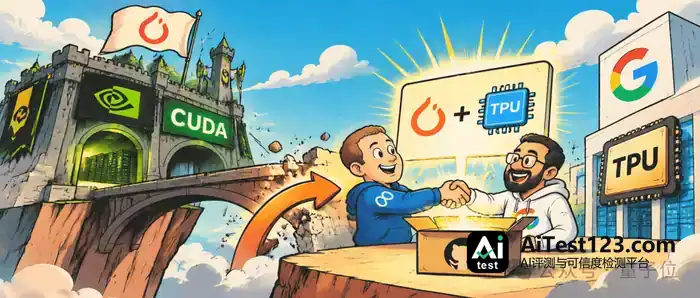
△图片由AI生成
性能与成本这块,11月5日SemiAnalysis放出一组新的Agent推理测试结果。
在Muse Spark等模型上,谷歌第七代TPU Ironwood已有部分测试做到每美元token产出高于英伟达GPU。
过去英伟达只在少数场合输给过AMD,如今TPU在性价比上带来的压力,是它此前没遇到过、也不愿面对的局面。
据SemiAnalysis消息,谷歌提交AgentX测试结果,证明TPUv7在每美元性能上能击败GB300 NVL72 FP4,随后英伟达很快组建了一支工程师团队展开反击。
这批英伟达工程师和Agent们昼夜不停,周末也不休息,高强度加班。
有人甚至一直干到当地时间凌晨2点。
四轮优化之后,在某个模型的测试中,GB300每美元Token产出终于反过来超过TPU 1.5-2.6倍。
前面是AMD在GPU阵营内部紧追不舍。
后面是谷歌想从架构层面动摇GPU作为默认算力选项的位置。
这一回,英伟达不想自己跟自己较劲都难。
老黄的烦心事还没解决,AI芯片市场又给英伟达添了一道“左右为难”。
对英伟达来说,这真是一个多事之秋。
参考资料:
[1]https://newsletter.semianalysis.com/p/tpu-strikes-the-king?utm_source=chatgpt.com