英伟达发布Alpamayo 2 Edge自动驾驶模型:因果链推理结合扩散动作
她叫Alpamayo 2 Edge,因果推理结合扩散动作,端到端输出闭环表现提升 48.9%。
 Edge,把因果推理和扩散动作结合到一起,端到端输出的闭环表现提升了 48.9%。
它叫 Alpamayo 2 Edge,是英伟达11月10日刚推出的一款端到端自动驾驶模型。VLM 骨干约 2.45B、动作专家约 0.2B,运行在车规级芯片 DRIVE AGX Thor 上。
不过“懂端到端”这四个字,还真不是拿标题蹭流量。眼下各种 AI 抢着替人说话、大模型自顾自念叨个没完,英伟达力挺的这姑娘(划掉)这模型,倒是真·人间清醒。
Alpamayo 2 Edge 想做到的是:车里的 AI 不光能看懂路,还能理清复杂的交通关系、判断潜在风险,再依据场景自己生成驾驶动作。说白了,就是让 AI 从会看、会理解,再往前走一步,到会开车。
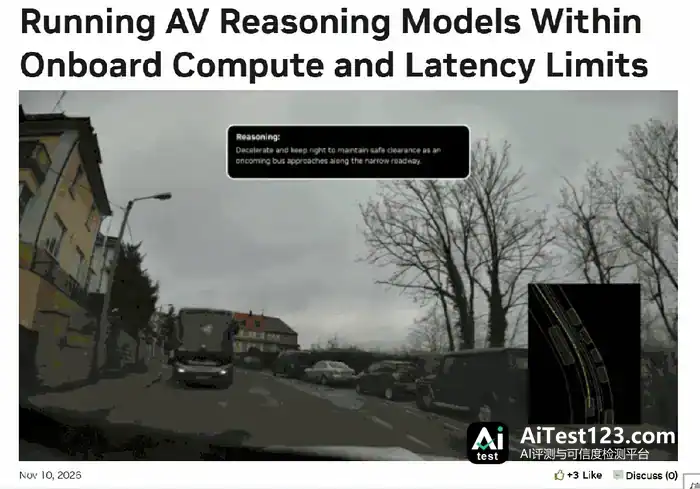
当然,让 AI 在服务器里推理,和让它在高速行驶的车上推理,完全是两码事。车上算力有限,响应时间也卡得很死,模型既得具备复杂场景下的推理能力,又不能把大量计算资源耗在没完没了的思考上。
针对这个矛盾,Alpamayo 2 Edge 做了一套新设计:普通端到端模型是输入图像直接输出轨迹,中间发生了什么谁也看不见。Alpamayo 2 Edge 则被要求生成 Chain-of-Causation(因果链)推理,不光要会开车,还得讲清楚为什么这么开。
那么,汽车到底需要怎样“懂端到端”的 AI,才能既想得明白,又开得及时?这套新的 VLA 拿出了一个挺有意思的技术方案。
01
让模型自己控制推理开销
Alpamayo 2 Edge 的一个核心设计,是让模型学会判断什么时候需要展开完整推理。在自回归语言模型下,推理文本越长,生成越费时间,而车载系统还得给视觉编码和轨迹生成留出算力。
为此 NVIDIA 引入了 Adaptive Reasoning,并设计了特殊标记 <NOMINAL>。模型一旦判断当前属于常规驾驶状态,就可以直接输出这个标记,把显式推理文本的生成停掉;碰上复杂的交通交互,再生成完整的 Chain-of-Causation(CoC)推理链。
具体到实现层面,有几点得说清楚:<NOMINAL> 不等于把视觉网络关掉,模型也没有因此跳过之后的动作计算。真正变的是语言模型的输出方式——常规场景下要算的推理 Token 少了。至于两种输出模式怎么挑,公开架构里并没有单独的外置风险分类器,靠的是训练,让模型自己把这套判断学会。
那模型怎么知道什么场景需要推理?这就跟 CoC 的数据构建有关了。
NVIDIA 的自动标注流程先从车辆轨迹里提取 Meta-Action,也就是自车的高层运动行为,再按行为发生变化的时间点找出关键帧,然后调用 VLM 生成场景因素与驾驶动作之间的因果解释。标注还得过一遍验证,看解释有没有画面依据,描述的动作跟实际轨迹对不对得上。
这里有个重要的设计取舍:驾驶视频里连续画面一大堆,可不是每一帧都会产生新的驾驶决策。要是逐帧生成推理文本,训练集很容易堆进大量重复描述。

以 Meta-Action 的变化为锚点,就能把监督集中在车辆行为发生变化的时刻,让模型学障碍物、交通参与者和道路条件是怎么影响自车动作的。
NVIDIA 用 Alpamayo 2 Super 生成 CoC 自动标注,再通过离线蒸馏训练 Edge 模型。公开数据约含 115,000 小时多摄像头驾驶视频,以及 370 万条 CoC 推理标注。
举个例子,前方车辆减速时,模型要结合左侧来车、道路边界和自身速度,判断能不能绕过去。CoC 得把这些因素跟减速、等待或转向之间的关系表达出来,同时不能引用决策发生之后才出现的信息。
这样一来,模型学到的东西有两层:复杂场景下怎么组织因果解释,常规场景下什么时候可以省掉显式解释。前者提供驾驶推理监督,后者控制文本生成的成本。
不过,自动生成的 CoC 仍可能带上教师模型的偏差,解释和实际驾驶动作到底一不一致,还得在后续训练中检验。
02
场景分析做完,接下来要解决的是怎么把判断变成车辆能执行的运动轨迹。
Alpamayo 2 Edge 把这一步单独拆出来,交给 Diffusion Action Expert 负责,这个模块约 0.2B 参数,与约 2.45B 参数的 VLM 骨干搭成双模块结构。
输入设计同样贴着驾驶场景来。每一轮模型要处理 6 路摄像头、22 帧图像:前向广角和长焦各给 5 帧,分别对应过去 2 秒、1 秒、0.5 秒、0.1 秒和当前时刻;左右侧向与后向四路摄像头各给 3 帧,对应过去 1 秒、0.1 秒和当前时刻。

前向摄像头的历史信息更密,用来识别道路变化和前方交通参与者的运动状态;侧后方画面则补充周边车辆情况。另外,模型还接收 20 个历史 Ego Pose,按 0.1 秒间隔覆盖过去 1.9 秒,并统一转换到当前自车坐标系。
Ego Pose 在这里很关键。摄像头给出的是外部环境的视觉信息,Ego Pose 描述的是车辆自身位置和姿态的变化。两类信息先经过统一的时间与坐标处理,模型才能结合自车运动历史,理解道路上其他参与者的相对运动。
视觉与运动信息编码完成后,VLM 提供场景语义、导航条件和 CoC 推理,动作专家拿到这些条件,生成连续控制量。
动作专家输出的是每个时间步的加速度和曲率,再由 Unicycle Model 积分成车辆轨迹。加速度管纵向速度变化,曲率管路径弯曲程度。比起让语言模型直接吐出大量坐标,用控制量表达更贴近车辆运动学。
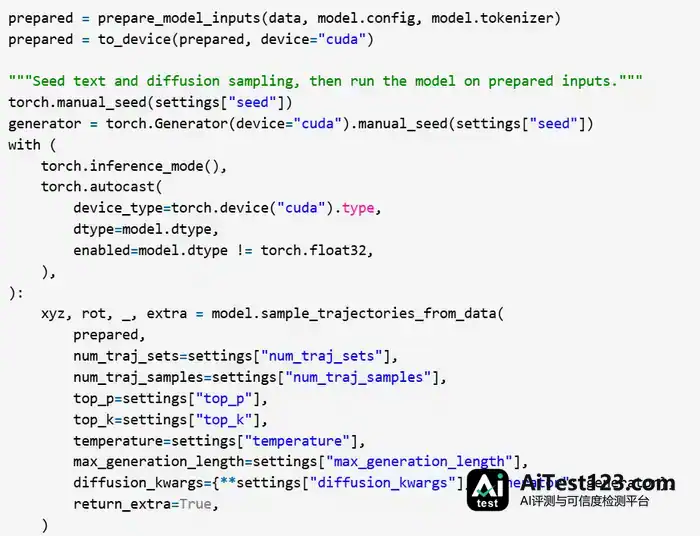
最终输出 64 个 Waypoints,覆盖未来 6.4 秒,每 0.1 秒一个点,包含 XYZ 位置和 3×3 旋转矩阵。这里还把车辆后轴的实际行驶路径和车身朝向分开表达:车辆侧滑时,车身航向与路径切线之间可能出现角度差,两类信息不能混为一谈。
连续动作采用 Flow Matching 训练,公开推理配置默认执行 10 步 Euler 积分。训练阶段,VLM 接受未来轨迹 Token 和 CoT 文本监督,动作专家接受加速度与曲率的 Flow Matching 监督。
梯度隔离由 Detach 实现,这是方案里的一个关键设计。动作专家拿到的是 VLM 输出的条件特征,可动作损失并不会回传去更新 VLM。连续控制目标对语言视觉骨干的梯度干扰因此被抑制,语义理解和运动生成这两块也就各走各的优化路径。
问题也随之而来:VLM 对场景的理解一旦有偏差,动作专家没法靠自己的训练损失直接修正上游表征。所以模型还需要一套独立的评价机制,检查推理文本有没有场景依据,生成的轨迹是否符合对应的驾驶意图。
03
让推理质量进入训练反馈
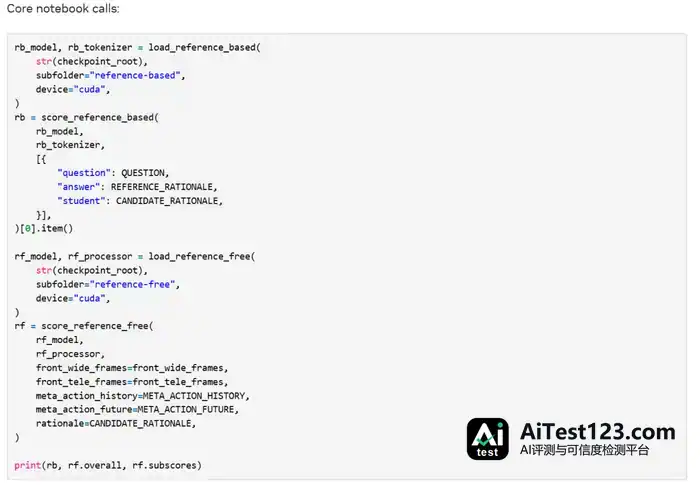
NVIDIA 为此引入 AlpaJudge,把 CoC 推理质量变成可评估的训练信号。它有两个版本:Reference-Based(RB)和 Reference-Free(RF)。
RB 的输入是问题、参考解释以及模型给出的候选解释,它据此判断两段文本的对齐程度,图像并不在读取范围内。问题也在这里:有专家标注的样本它能处理,但解释和实际画面到底对不对得上,它没法单独下判断。
RF 则不用参考解释。前向广角和长焦摄像头画面、自车 Meta-Action 的历史与未来,再加上模型生成的 CoC,都是它的输入。推理质量从五个方面来评:动作匹配、安全性、场景依据、要素完整性、因果一致性。
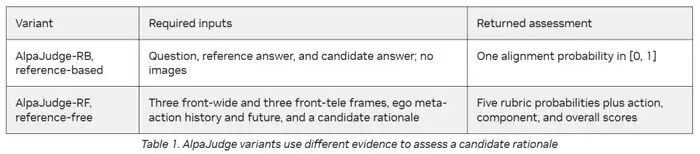
RF 把动作匹配与安全性合并为动作评分,占综合评分的 60%;场景依据、要素完整性和因果一致性构成另外 40%。驾驶行为与语言解释被放进同一套评价框架,避免只凭文本流不流畅来判断推理质量。
因为用到了未来 Meta-Action,RF 主要用于离线评估和训练,不参与车辆实时决策。它的任务是检查模型生成的解释是否符合场景证据,解释所表达的驾驶意图是否与实际动作对应。
训练数据的筛选也有 AlpaJudge 参与。NVIDIA 的实验结果是:评分筛选之后,中间分数样本在精选数据里占到 81%,而原始数据中这一比例是 27%。这类样本往往还留有较多学习空间;低分样本的情况更复杂,可能源自错误标注,也可能是模型还没掌握的困难场景,所以人工复核仍然要做。
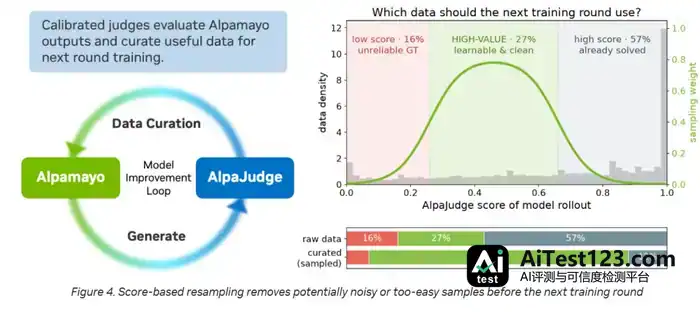
后训练阶段同样用上了评分机制。模型先给出候选 CoC 和轨迹,训练流程再把推理质量、轨迹误差和驾驶舒适度合起来算奖励,同时对轨迹质量保留约束,防止模型只顾着把解释文本写好。
NVIDIA 在一组基于 Alpamayo 2 Super 的后训练实验中发现,使用 AlpaJudge 奖励后,模型评分提升 10.2%,人工评价提升 11.4%;使用基线奖励时,模型评分提升 13.4%,人工评价却只提升 1.8%。两组结果说明,模型自身评分与人工判断之间可能存在偏差,推理奖励需要经过人工校准。
不过,AlpaJudge 只能评价模型生成的解释,无法完整衡量连续驾驶中的动作后果。为此,NVIDIA 又将模型接入 AlpaGym 和 AlpaSim,进行闭环强化学习。
放到仿真环境里,模型输入摄像头画面、自车状态和路线信息,生成轨迹交由仿真车辆执行,环境随后返回新的画面与运动状态,模型据此做下一轮决策。这样训练时就能看到当前动作如何影响后面的场景,策略也随连续驾驶的结果更新。
NVIDIA 披露,Alpamayo 2 Edge 经过闭环强化学习后,驾驶表现较未使用该轮 RL 的较优检查点提升 48.9%。在 AlpaSim 的 875 个场景中,每个场景执行三组 rollout,平均每发生一次责任事故或驶离道路事件前行驶约 15.15 公里。
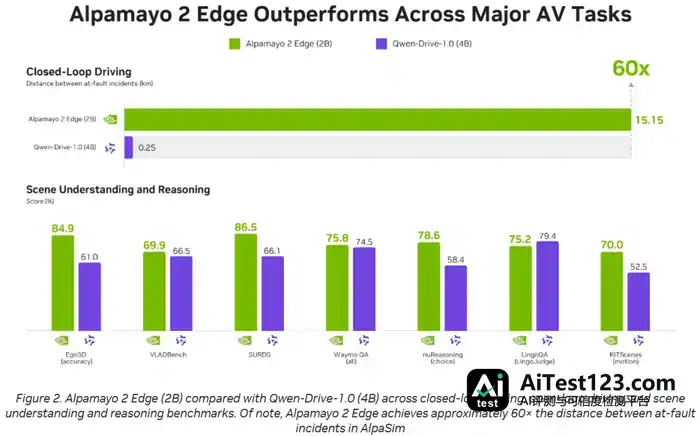
开放环评估用了 1,392 条样本,在 5 秒处测得的 minADE₆ 是 0.52 米。两组数据量的不是一回事:闭环看的是模型在持续交互里怎么开,开放环看的是固定输入下的轨迹误差。解释质量由 AlpaJudge 把关,动作后果由 AlpaGym 检验,训练反馈由此落在不同层面上。
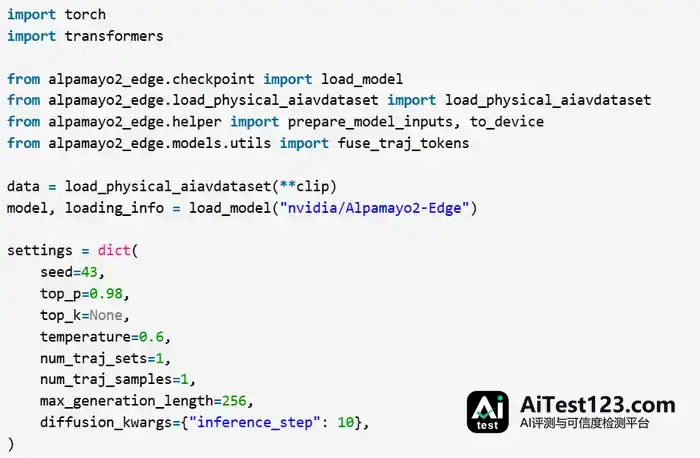
训练结束之后,还得面向 DRIVE AGX Thor 做推理优化。NVIDIA 给出的部署流程里有 FP8 量化校准、ONNX 导出和 TensorRT Engine 构建,另外还接上了 TensorRT Edge-LLM 插件与 DFlash2 speculative decoding。DFlash2 的做法是让轻量 Draft 模型并行提出候选 Token,交给目标模型去验证,从而压缩自回归解码的等待时间。再算上 NOMINAL 对常规场景推理文本的压缩,计算开销就从文本生成长度和解码执行两头被控住了。
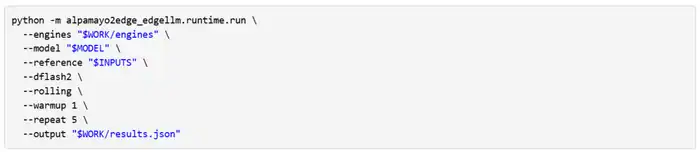
参考配置为 DRIVE AGX Thor-X、DRIVE OS 7.2.7.0、CUDA 13.4 和 TensorRT 11.3.1.9,NVIDIA 公布的 Pixel-to-Trajectory 时延是 160–190 ms,长短取决于 CoC 文本长度。这个数字说的是模型从图像输入到轨迹输出的推理耗时,传感器采集、定位、控制器执行和安全监控组成的整车响应周期并不算在内。
04
“会说话”不难,“说得起”才难
传统端到端模型挨批,主要不是说它开得差,而是它讲不清自己为什么这么开。Alpamayo 2 Edge 的因果链推理正好冲着这点来:它给出的不是“前方有车→刹车”,而是一整条因果解释。这条技术路线把自动驾驶 VLA 的研发推到了更具体的阶段——模型要随道路状况调整推理深度,还得把场景理解转成符合车辆运动学的连续动作。
这套设计的意图不难读:既然你说自己懂因果,那就交给评分器判。英伟达同时提醒,推理分高不等于车开得好,必须和碰撞、偏离车道、轨迹误差这些指标一起报。
这就对模型提了两头的要求:一头是判断当前交通环境里哪些因素会影响驾驶决策,另一头是控制推理过程带来的计算开销,好让后续轨迹生成赶得上。这里有个很现实的工程矛盾。模型对复杂场景判断不足,可能过早切进 NOMINAL 模式,漏掉本该处理的交通因素;可要是一味展开长 CoC,语言解码又占掉更多时间,整条推理链路的执行效率跟着受影响。
所以自适应推理的效果,不能只盯文本质量,还得把模式选择、轨迹质量和实际响应时间放在一起看。连续交通交互中尤其如此:模型能不能及时察觉场景变化、该调整推理策略时调得动,直接牵动后面的驾驶动作。
说回开篇那个问题:我们要的是 AI“真懂”,还是“表现得懂”、懂到能过 AlpaJudge?
就目前公布的结果看,NVIDIA 已经把模型架构、自动标注、强化学习和车载部署之间的完整技术路径摆了出来,但仿真环境里的表现,仍要放到不同道路条件、传感器组合和车辆动力学环境里去检验。对自动驾驶来说,生成轨迹只是决策链路中的一环。Alpamayo 2 Edge 把推理过程也纳入计算资源分配和训练优化,VLA 的工程设计空间因此又宽了一些。
接下来,这套架构能不能在真实车辆上稳稳处理复杂交通交互,会决定它的技术方案能走多远。
参考链接:https://developer.nvidia.com/blog/running-av-reasoning-models-within-onboard-compute-and-latency-limits