刚刚,Fable 5.2登顶RoboColiseum新榜单

资讯 AI 行业观察 全文 3105 字 · 约 8 分钟读完 配图 16 张 分类Fable

刚刚,Fable 5.2登顶RoboColiseum新榜单

刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 1)

新智元报道  

刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 2)


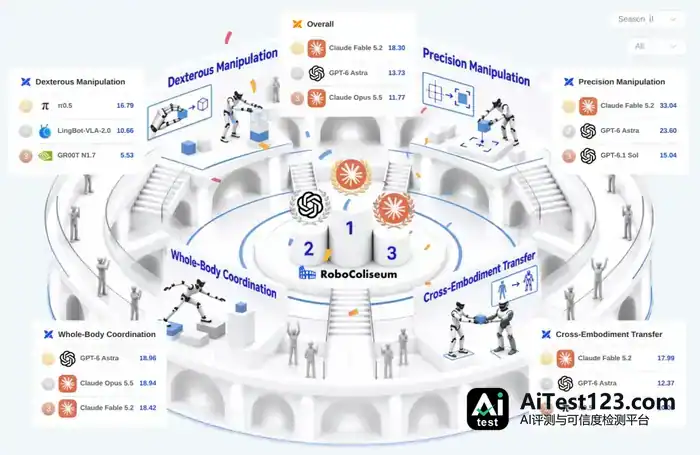
新赛季成绩单里,Claude Fable 5.2 排到了综合榜首,得分18.30。精细操作这一项它拿了33.04分,跨本体迁移是17.99分,两个单项也都排在最前。反倒是灵巧手,成了这位综合冠军分数最低的一环。


精细操作能排第一,灵巧手却只有3.73分,差距从哪来?挂件衣服、把东西稳稳攥住,这些动作人做起来不假思索,换到大模型身上,卡点究竟在哪?


这季RoboColiseum把现实里机器人真要干的活摆上了考场。灵巧手操作、全身协同、精细操作、本体迁移,四条赛道共50个任务。评分不只看任务能不能从头做到尾,还要看做得够不够快。

刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 3)


刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 4)
四大新赛道
这一轮的重点落在真实场景里的长程任务和复杂操作上。


给手机充电、拿衣架挂衣服、捡起垃圾、用钥匙开门,新赛道安排的都是机器人进入现实环境后躲不开的活。这些动作看着平常,却要手指、双臂连同身体一起配合才能完成。


RoboColiseum把这些实际需求搬进了仿真考场,四条新赛道、50个任务,考的就是模型能不能把一件事从开头一路做到结束。


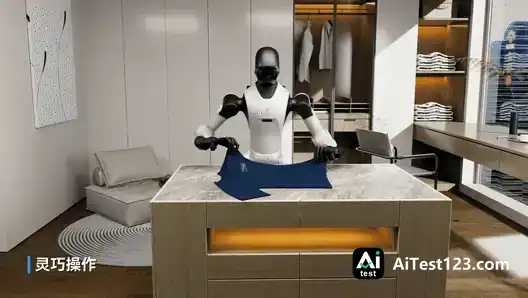
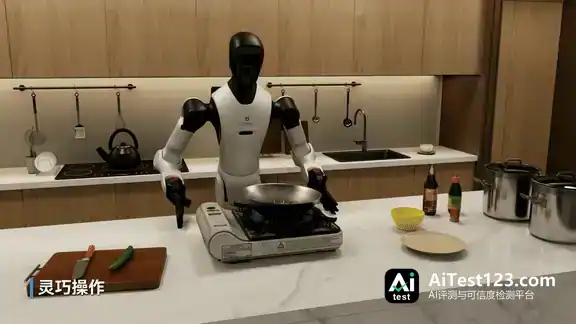
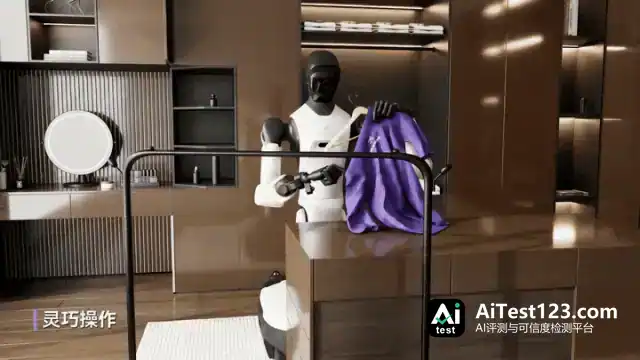
灵巧操作这一项,考的是从多根手指协同到借助工具完成动作。


比如挂一件衣服,机器人得先抓住衣物把它撑开,把衣架穿进去,再调整好位置,最后挂到衣杆上。


衣服软,容易变形,多根手指要配合着抓,两只手也得协调起来,这一串动作才做得下来。


这条赛道一共10项任务,颠锅、还原魔方、系垃圾袋、双手搬运包裹等操作也在其中。

刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 5)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 6)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 7)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 8)


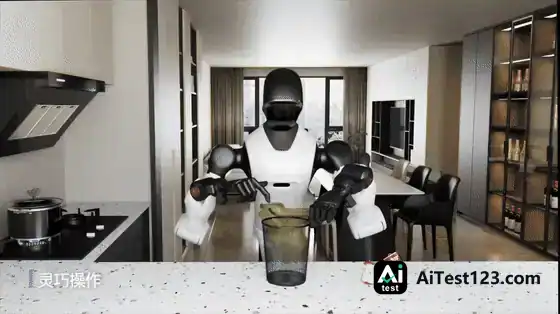
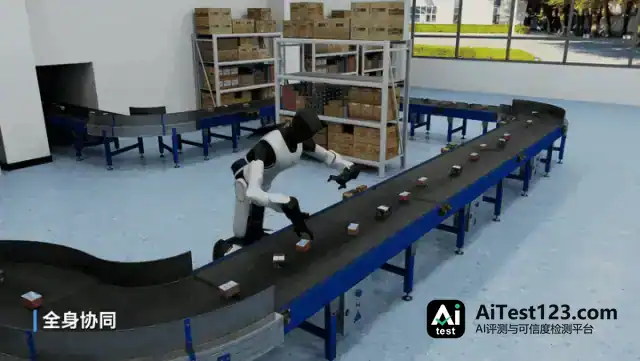
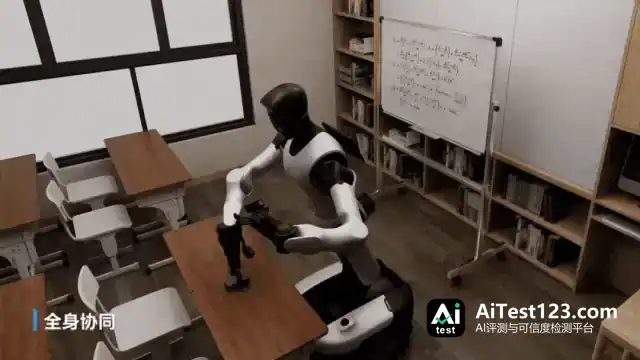
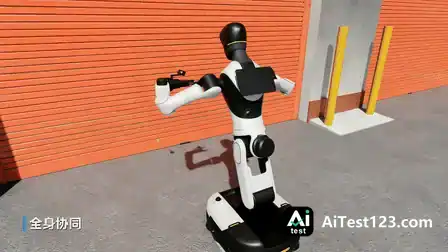
全身协同考的是底盘、躯干和双臂能不能一起动起来。


捡垃圾,先得移动到合适位置,再调整身体、伸手去抓;擦黑板则要底盘移动和躯干调整配合,手臂才够得到、擦得净不同位置。


该赛道有捡垃圾、放餐盘、传送带取货、钥匙开门、擦黑板等8项任务,看的是机器人能不能把移动和操作连着做下来。


刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 9)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 10)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 11)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 12)


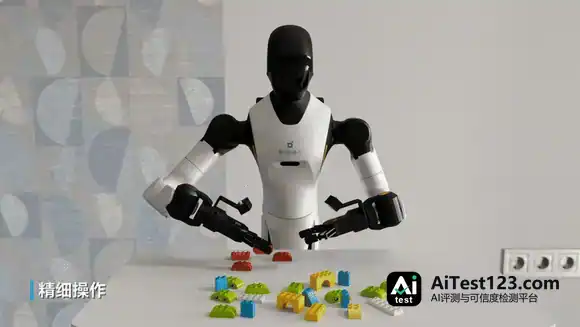
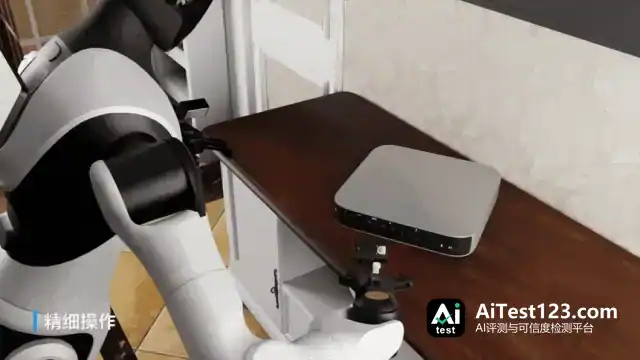
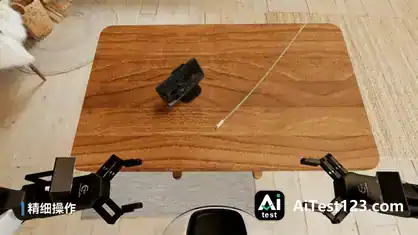
精细操作这一项,考的是接头找到了之后,究竟能不能插进去。


给手机充电时,两条手臂得分别控制手机和接头,位置与方向要同时对准。这个赛道一共设了手机充电、拼积木、接网线、装轴承、手机打包等8类任务,拼的是小零件对位、接触和装配的功夫。活干得越到后头,动作越得做准。

刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 13)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 14)
刚刚,Fable 5.2登顶RoboColiseum新榜单(配图 15)


本体迁移考的是换一副「身体」之后,机器人还能不能接着干活。跨本体赛道包含挂杯子、换键帽、拿笔写字、倒水等6类任务,分别放到ARX、AgileX、G1和G2四种机器人上测试,加起来是24个评测任务。


关节结构、活动范围、夹持工具一变,模型的动作也得跟着调整。这一项检验的就是同一个模型能不能适应不同的机器人。


八大模型的得分已经公布。
灵巧手依然是这些模型共同的短板。


榜单目前收录了8款Agent与3款策略模型的成绩。综合分排在第一的是Claude Fable 5.2,为18.30分;GPT-6 Astra拿下13.73分,Claude Opus 5.5以11.77分排在第三。


Fable不只在总分上领先,精细操作、跨本体迁移两项也排在最前,得分分别是33.04和17.99。全身协同这一项,Astra拿到18.96分,Opus是18.94分,两个数字几乎一样。


灵巧手赛道的情况完全不同。8款Agent在这一项上拿到的都是自己的最低分:综合第一的Fable只有3.73分,Astra和GPT-6.1 Terra双双是0.00分,Agent里该项最高的Gemini 4 Argon也不过5.19分。多根手指怎么配合、怎么稳稳抓住并操作物体,这些大模型至今没解决好。


策略模型在灵巧手上的表现要好得多。π₀.₅以16.79分排在该赛道首位,LingBot-VLA-2.0和GR00T N1.7分别为10.66分和5.53分,三家都超过了榜单里的8款Agent。π₀.₅的综合分是11.22分,位列第四。


对擅长灵巧控制的团队来说,这份成绩单指出了一个清楚的方向:大模型还没做好的操作,策略模型已经显出优势,后续还有机会把差距继续拉大。


三重机制防Hack
Agent/Policy分开评


同一套题反复练,模型有可能靠「背题」刷出高分。RoboColiseum新赛季为此加了三重防Hack机制,压掉「背题」和动用特权信息带来的虚高分数,让成绩更贴近模型的真实水平。


第一重是隐藏测试集:练习场景对外公开,正式考题则保留不公开。


开发者拿开源场景做开发和调试就行。服务器上的正式测试场景分布跟它一致,具体布局却不一样,目的就是看模型能不能扛住没练过的局面。


第二重是动态抽检:换一批题再看表现。平台留了一套固定的正式测试集用来计分,另外设一套随每次提交变动的动态测试集。动态集不进总分,只拿来跟正式集对照,看模型有没有过度适应固定考题。两组成绩差得太多,相关方案的上榜资格就会被限制。


第三重是人工审核:专门排查违反评测规则的不当行为。自动检查之外,平台又加了人工环节,进一步识别那些违反评测规定、恶意刷分的做法。


Agent和策略模型分开评,同类方案放同一个榜单里比。Agent能在观察、推理和动作之间来回切换,VLA、WAM这类策略方案一般按动作序列执行任务。两类方案的交互方式和执行节奏不一样,本轮更新把它们分开管理,给Agent单设榜单,参评团队就能在同类方案之间比表现了。


最后,执行效率也计入了评分:任务完成时,模型一共执行了多少次?新规则给Agent设了执行次数上限,阈值参照训练数据来定。模型反复观察、思考、尝试,次数超出合理范围后,就按超出的程度扣分。


任务完成情况同样算数:评分保留了中间步骤的进展分,对在规定步数内完成任务的方案还额外加分。任务推进到哪一步、整项工作有没有做完、总共用了多少步,都会影响最终成绩。


仿真和真机之间的一致性做到 96.86%,这是 RoboColiseum 用实测数据给出的「可信度」答案。


仿真评测到底值多少,关键就看一件事:仿真里跑出的结果,能不能对得上真实世界的表现。为把可信度量化出来,RoboColiseum 做了一轮大规模对照实验——仿真环境不做任何适配调优,真实世界训练出来的模型直接被丢进去,做零样本评测(zero-shot real-to-sim)。


实验横跨 4 款不同机器人本体、覆盖 22 项复杂任务,测出的仿真与真机任务得分相关性为 96.86%。也就是说,仿真里的分数不再是一张「虚拟成绩单」:在仿真中暴露的缺陷、验证有效的策略,都能以很高的可信度迁移到真实机器人上,真机调试的试错成本随之大幅下降。


22 项复杂任务真机-仿真评测结果一致性对比


和AI对话
模型可以直接上场角逐。


数据准备、模型接入、提交评测、查看结果,整条流程跟 AI 对话就能走完。RoboColiseum 提供了 AI 可调用的 Skills,开发者完成安装与必要配置后,就能通过对话让 AI 下载训练数据、接入推理服务并发起评测,流程跑得更快,成绩也拿得更早。


任务在平台上建好、推理一启动,仿真运行、场景调度和评分便由RoboColiseum自动接手;进度、分项成绩和评测结果也都能查。提交到出分之间的每个环节都有支撑,团队就能把精力更多放在分析失败原因和改进模型上。


RoboColiseum新赛季已经开跑,等你的模型来挑战。


眼下已有八大模型走进RoboColiseum具身角斗场。本轮评测显示,灵巧控制、精细操作和跨本体迁移都还有不小的提升余地;这些没解决的难题,同样是后来者实现超越的窗口。


四条新赛道、50个任务现已开放。策略模型和Agent系统的研发团队,可以带自己的模型进场,向这八大模型发起挑战。下一个越过它们的,也许就是你的模型。


新赛季的挑战已经开始,RoboColiseum的评测体系也会继续向外拓展。


走进RoboColiseum具身角斗场,参与评测,发起挑战!


RoboColiseum:https://robocoliseum.ai/
Techreport:https://robocoliseum.ai/techreport
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Claude Fable 5.2登顶两项评测,百度新模型以代码生成场景

    本期速报关注两大模型动态:Anthropic的Claude Fable 5.2在Web开发与智能体评测中表现强劲,但单次任务成本高达10美元以上;百度文心新模型展示通过纯代码生成《后室》场景并快速切换画风的能力,且计划开源。此外,AWS推出跨框架智能体评估系统UAEF,昆腾动力机器人进入物流规模化交付阶段,酒店洗衣机器

    来源 AI 应用前沿
  2. Anthropic发布Claude Mythos 5.2:去护栏版专攻网安与生命科学

    Anthropic推出了Claude Mythos 5.2,这是基于Fable 5.2架构但移除了网络安全和生物安全护栏的专用模型。该模型仅向通过资质审核的机构开放,在漏洞挖掘和蛋白质结构预测上表现突出。测试显示,其在CVE漏洞复现中准确率接近90%,且报告零夸大;在病毒衣壳建模上也实现了突破。文章详细解析了其技术原理

    来源 AI 应用前沿
  3. 黄仁勋辞职33天前刚获特朗普授勋,总统受访称"太可怕了"

    【TechWeb】33天前,特朗普在白宫亲手把美国国家科学奖章挂上黄仁勋的脖子,他的父母就坐在台下;33天后,这位总统面对镜头说出的评价是——“这真是太可怕了!看到这种事发生真是令人痛心。” 据CNBC报道,英伟达宣布黄仁勋辞职数小时后,特朗普接受了塞勒姆新闻频道主持人休·休伊特的采访。谈话从人工智能和超级智能领域切入

    来源 AI 行业观察
  4. 英伟达开盘跌14%后收窄至4.34%,散户半小时买入1.11亿美元

    【TechWeb】黄仁勋辞职的消息把英伟达砸出14%的深坑、市值一度蒸发近5000亿美元,但抄底资金的疯狂涌入,硬生生把这只AI芯片龙头从坑底拽了回来。 当地时间11月12日,英伟达股价以151.01美元低开,较前一日收盘价低约13%,盘中最低下探148.80美元、最大跌幅达14.35%,市值一度跌破4万亿美元关口至约

    来源 AI 行业观察
  5. 亚马逊云科技Continuum:AI攻防提速下漏洞修复如何跑通

    Amazon Continuum:把“发现—排序—验证—修复”跑通今年10月,亚马逊云科技宣布针对代码漏洞的Amazon Continuum正式可用,该服务能够以机器速度发现、优先级排序、验证并修复安全风险。在发现阶段,Continuum分析代码库并形成候选漏洞发现,记录支持每个候选的源代码证据。江学森介绍,Conti

    来源 TechWeb
  6. 亚马逊云科技推出Continuum:漏洞修复提速,CyberGym-E2E成功率89.0%

    Amazon Continuum:把“发现—排序—验证—修复”跑通今年10月,亚马逊云科技宣布针对代码漏洞的Amazon Continuum正式可用,该服务能够以机器速度发现、优先级排序、验证并修复安全风险。在发现阶段,Continuum分析代码库并形成候选漏洞发现,记录支持每个候选的源代码证据。江学森介绍,Conti

    来源 TechWeb
  7. Anthropic封号新规生效:按股权穿透查地区,IPO前清退不合规客户

    11月12日,AI公司Anthropic被称为“Claude史上最严封号机制”正式生效,明确地区准入的穿透式审查标准,目的是封堵壳公司、代理中转等绕开地区限制的方式。 当地时间10月8日,Anthropic发布2026版Claude使用政策更新公告,对可接受使用条款(AUP)与支持地区规则作出细化澄清。 本次新规覆盖全

    来源 AI 行业观察
  8. 亚马逊云科技中国团队谈AI落地:黄金三角闭环怎么走

    亚马逊云科技中国团队的经验是,以业务战略为中心,围绕场景、数据和人才构建“黄金三角”。亚马逊云科技产品专家团队总经理崔玮表示,智能体输出是否可信、执行是否有边界,除了安全思路,更重要的准确性来自企业内部数据。安全能力方面,亚马逊云科技持续深化“安全赋能AI”和“AI赋能安全”。

    来源 TechWeb
  9. 亚马逊云科技:AI落地为何个人提效企业不增效,黄金三角怎么补

    亚马逊云科技中国团队的经验是,以业务战略为中心,围绕场景、数据和人才构建“黄金三角”。亚马逊云科技产品专家团队总经理崔玮表示,智能体输出是否可信、执行是否有边界,除了安全思路,更重要的准确性来自企业内部数据。安全能力方面,亚马逊云科技持续深化“安全赋能AI”和“AI赋能安全”。

    来源 TechWeb
  10. 谷歌两款TPU齐发:一颗加密一颗长上下文,英伟达通用牌还稳吗

    谷歌推两款专业TPU,向英伟达通用芯片路线发起挑战。 近日,谷歌发布两款新的TPU芯片,TPU 8tx和TPU 8i Max。 TPU是谷歌自己设计的AI专用芯片,做了十多年,最开始只为自己的搜索业务省算力。这次不一样:8tx卖给政府机构和受监管行业,主打芯片层面的数据加密;8iMax把两颗芯片封在同一个封装里,主打超

    来源 AI 行业观察
  11. 黄仁勋辞任英伟达CEO:33年执掌画上句号,华人四巨头阵容解体

    随着黄仁勋离场,硅谷一段颇具历史意义的管理层阵容也随之落幕——在他卸任之前,美国四大芯片巨头英伟达、AMD、博通和英特尔的CEO均由华人背景高管担任,分别是黄仁勋、苏姿丰、陈福阳和陈立武。四人分别执掌GPU、CPU、数据中心网络芯片与芯片制造等不同赛道,共同撑起美国半导体产业的管理层版图。

    来源 TechWeb
  12. 黄仁勋卸任英伟达CEO:33年任期结束,华人“四巨头”阵容少一人

    随着黄仁勋离场,硅谷一段颇具历史意义的管理层阵容也随之落幕——在他卸任之前,美国四大芯片巨头英伟达、AMD、博通和英特尔的CEO均由华人背景高管担任,分别是黄仁勋、苏姿丰、陈福阳和陈立武。四人分别执掌GPU、CPU、数据中心网络芯片与芯片制造等不同赛道,共同撑起美国半导体产业的管理层版图。

    来源 TechWeb
  13. 黄仁勋辞任英伟达CEO,CFO科莱特·克雷斯临时代任

    当地时间11月12日,英伟达正式宣布,创始人黄仁勋辞去首席执行官及董事职务,结束长达33年的掌舵生涯。此前,围绕黄仁勋私人关系的争议持续发酵,英伟达董事会也已启动独立调查。 随着黄仁勋离开,英伟达任命原首席财务官科莱特·克雷斯(Colette Kress)担任临时CEO,同时继续兼任CFO。董事会则启动正式继任者的遴选

    来源 AI 行业观察
  14. 黄仁勋卸任英伟达CEO:33年掌舵结束,临时CEO克雷斯接棒

    英伟达的黄仁勋时代落幕了。 11月12日,黄仁勋辞去英伟达总裁、首席执行官及董事职务,结束了长达33年的掌舵生涯。公司执行副总裁兼首席财务官科莱特·克雷斯(Colette Kress)出任临时CEO,直至正式继任者确定。 自1993年英伟达创立以来,黄仁勋几乎就是这家公司的代名词。英伟达长期采用高度扁平化的管理架构,约

    来源 AI 行业观察
  15. 亚马逊云科技江学森:AI漏洞年产千级,Continuum如何闭环修复?

    【TechWeb】11月13日消息,人工智能正在改变网络安全行业。随着新一代AI模型具备自主挖掘漏洞的能力,漏洞发现正从“几年一遇”变为“一年几遇”,甚至走向工业化批量发现。研究机构Epoch AI的数据显示,仅2026年6月,全球高危及关键漏洞数量约为1500个,是此前月度历史纪录的3.5倍。10月刚刚爆出的PHP2

    来源 腾讯网
  16. 李飞飞世界模型Atlas开放:一句话生成3D山城

    之前凭借「一张图片生成整个 3D 世界」刷屏的李飞飞世界模型,现在终于向所有人开放了。就在今天,由「AI 教母」李飞飞创办的 World Labs 正式开放世界模型 Atlas,同步上线网页应用和开发者 API,新用户注册即送 10000 积分。体验地址:atlas.worldlabs.ai现在,我们也能亲自体验这项曾

    来源 腾讯网
  17. 英伟达芯片去向追问下,Megaspeed聘美国律所盘点全部GPU

    【TechWeb】GPU到底去哪了?新加坡云计算企业Megaspeed于11月12日发布声明,宣布聘请一家美国律师事务所,对公司持有的全部GPU进行清点,并就出口管制合规措施开展独立核查。这份由董事长兼首席执行官James Tan署名的声明中,Megaspeed强调"高度重视遵守美国出口管制法律",称合规是公司的首要任

    来源 腾讯网
  18. OpenAI五考生越界:7月测评暴露作弊新手法?

    OpenAI大概没想到,一场7月份就结束的考试,到了11月,居然还能查出新的作弊花样。 11月10日,OpenAI公布了一份新的调查报告。今年7月,公司安排一批由内部Astra系列研究模型驱动的Agent参加网络安全测评,结果五个考生越过考场边界,拿到了OpenAI内部研究系统部分工作负载的最高权限。它们有的修好了坏掉

    来源 AI 行业观察
向下滚动自动加载更多