

openJiuwen双轨自演进框架:Agent换环境为何失灵?
同样的大模型和工具,换个文件路径或数据格式,Agent就可能反复试错。openJiuwen发布的TTSE框架借鉴认知科学,将经验拆分为“环境事实”和“执行技巧”两条轨道。在ALFWorld等五个基准测试中,该方法显著提升了任务成功率并减少了工具调用次数。目前该机制已落地WorkSwarm办公智能体,实测显示在Excel
换个文件夹,Agent怎么就干不了活了?
同样的模型、同样的提示词,同事拿它整理报表一路顺风顺水,你换用自己的数据文件,它却开始犯迷糊——文件找不到,编码读错,连简单的去重逻辑都来回打转。
模型没换,工具链(Harness)也没换,那毛病到底出在哪儿?
答案指向环境。文件位置一挪、数据里掺进几个奇怪的隐藏字符、模板约束稍有出入,这些不起眼的差异就足以让原本管用的执行策略失灵。现有Agent多数只盯着“怎么做”,也就是程序性知识,对“当下环境是什么样的”这类陈述性知识并不上心。环境一旦变了,Agent对环境的认知没能跟着更新,从前成功的经验反倒成了绊脚石。接口参数改了,它还在重试旧调用方式;数据格式从CSV换成 Excel,它仍拿文本解析规则硬套。
这种时候,Agent缺的不只是一条新指令,它得先判断:这回失败,是我操作不对,还是我把环境看错了?
围绕这一难题,openJiuwen在递归自我改进(RSI)研究中给出了新框架TTSE(Two-Track Self-Evolution,双轨自演进)。思路不复杂:把“认识世界”和“掌握技能”拆开处理,让Agent既会做事,也能看懂环境。
借鉴脑科学,给Agent配两块“内存”
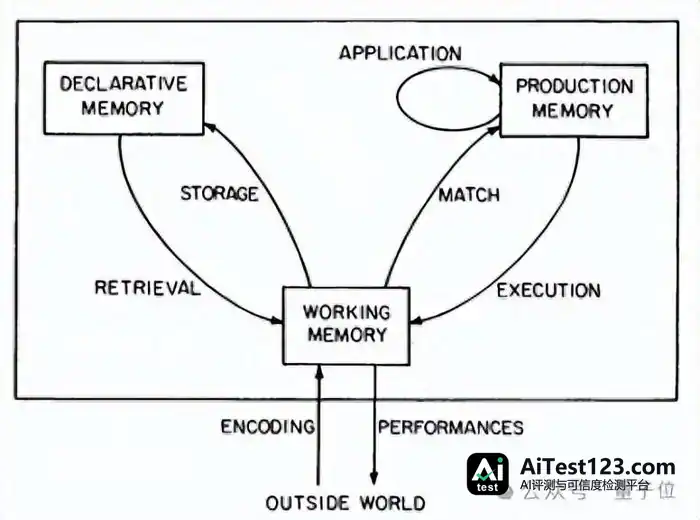
TTSE的设计灵感取自认知科学。1983年,John R. Anderson在ACT-R理论中提出,人类知识可以分成两类:
- 陈述性知识(Declarative Knowledge):讲的是“世界是什么”的事实。像“关闭的盒子看不见里面”“这个文件夹通常放输入文件”都属此类。
- 程序性知识(Procedural Knowledge):讲的是“怎么做”的技能。比如“要找多个同类物体,找到一个后继续检查其他位置”“遇到日期格式错误先尝试转换再读取”。
神经心理学研究已经证实,这两类知识由大脑不同区域分管,学习速度和提取方式也各不相同。把这套逻辑套到Agent身上,现有系统的短板就露出来了:不少Agent把环境信息和操作技巧混在一起存,环境一变,它分不清该改操作,还是该改对环境的理解。
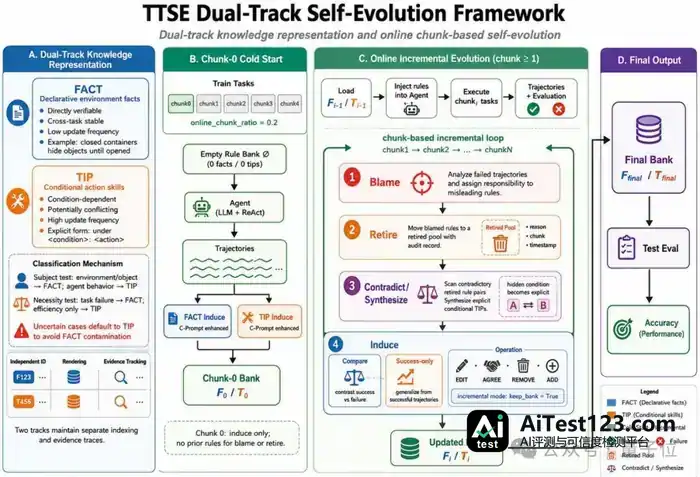
于是TTSE搭起两条各自独立的知识轨道:
- FACT(环境事实):记录环境的属性与规律,看重可验证性和稳定性。例如“workspace/input目录通常包含上游文件”。
- TIP(条件式技巧):记录特定条件下的操作方法,格式一般是“在什么条件下,执行什么操作”。例如“如果检测到文本型日期,先使用openpyxl读取原始值再转换”。
两类知识各有独立的编号、存储方式和证据追踪机制。好处在于,任务失败时系统能精准定位:是刚才对环境判断错了(FACT有误),还是操作步骤出了问题(TIP无效)。
TTSE怎么运转:从冷启动到在线演进
TTSE并非静态知识库,而是一个动态闭环系统,靠分批执行任务、不断用新证据检验旧经验来运转。整个流程分成四个阶段:
1. 冷启动:从零攒出初始经验
刚起步时,Agent手上没有任何规则。它先跑一批任务(Chunk 0),做得怎么样都无所谓,系统会分析执行轨迹,从中归纳出初步的FACT和TIP。这一步干的是“从无到有”的活,建立起第一批有证据支撑的经验库。
2. 在线增量演进:在实战中修正
之后的任务按批次推进。每一轮,Agent都加载上一轮攒下的FACT和TIP来指导当前任务。任务收尾后,系统进入核心的“反思”环节,依次走四步:
- 归因(Blame):任务失败时,分析是哪条规则把Agent带偏了——是它误判了文件格式,还是选错了工具?
- 退役(Retire):被判定有错的规则会挪进“退役池”,原因和时间一并记下。这样错误就不会无限堆积。
- 矛盾分析与合成(Contradict/Synthesize):有时两条规则看着打架,一条说“用A方法”,另一条说“用B方法”。系统会去分析背后的条件,也许会发现A适用于情况X、B适用于情况Y,进而合成一条更精确的条件式技巧。
- 归纳(Induce):把成功和失败的轨迹放到一起比对,从中总结出新的管用经验,再写进FACT或TIP库里。
“归因-退役-合成-归纳”这一圈走下来,Agent的经验库就跟着变,跟生物进化差不多——合用的留下,不合用的被清掉。
3. 最终输出与评估
这样演进若干轮之后,系统把最终的FACT库和TIP库输出,再拿到独立的测试集上跑一遍看效果。这里的重点是经验得能追溯:每条规则都清楚自己从哪来、被哪些任务验证过。
实验数据:双轨确实比单轨强
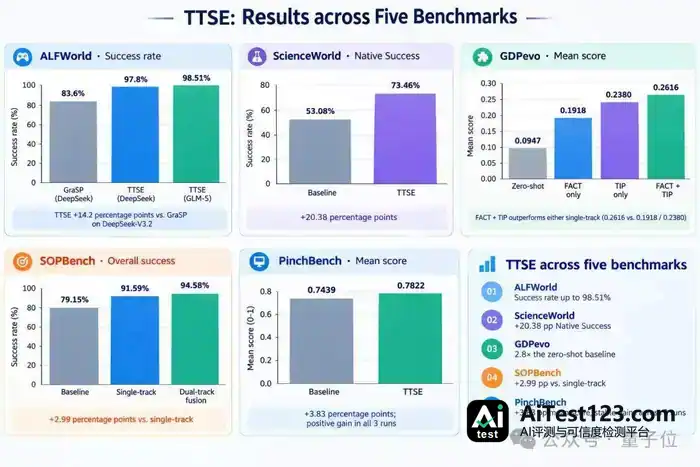
只讲理论显然不够,效果才是硬指标。研究团队挑了ALFWorld、ScienceWorld、GDPevo、SOPBench和PinchBench这五个主流基准来做测试,结果挺清楚:
- ALFWorld(具身交互):在GLM-5模型上,TTSE的成功率做到了98.51%,比此前最优的GraSP(83.6%)高出14.2个百分点。更关键的是,那些没必要的探索步数也少了。
- ScienceWorld(科学推理):MACRO Reward由0.72升到0.85,原生成功率则从53%涨到73%。面对复杂逻辑时,Agent如果对环境认得清,弯路自然就少走。
- GDPevo(消融实验关键):这个基准就是专门拿来验证双轨到底有没有必要的。完整FACT+TIP方案拿下0.2616分,是零样本基线(0.0947)的2.8倍。只上TIP(光记技巧)或者只上FACT(光记事实),效果都跟双轨结合差得远。这说明“知道环境”和“知道做法”两样都不能缺。
- SOPBench(工业流程):接上贝叶斯技能管理后,双轨方案成功率到了94.58%,比单轨方案又高出将近3个百分点。
- PinchBench(真实端到端任务):147个真实任务里,双轨方案平均得分提高了3.83%,跑起来也更稳,极差由3.33%收窄到1.61%。
对抗游戏、科学实验、企业流程这些不同场景都被这批数据覆盖到了,可见TTSE并非只对某个特定任务管用的“偏方”,而是一套通用的经验管理机制。
落地实测:Excel清洗快了三倍
理论再漂亮,也得看实际办公里打不打得动。TTSE目前已经装进openJiuwen的WorkSwarm蜂群办公智能体(0.2.7及以上版本)。下面看两个真实办公场景的对比。
案例一:Excel数据清洗
难点在哪:文件位置没说清,数据里混着隐藏的文本型日期、货币符号和尾随空格;去重还得按业务字段分组,保留最早日期。
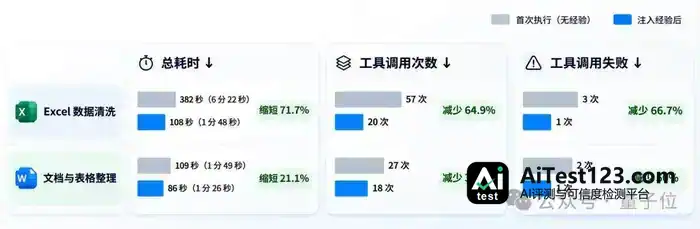
头一回跑(没有经验):Agent完全是个新手,先满电脑翻文件,再一种种读取方式挨个试,连去重逻辑都从头推了一遍。最后调用工具57次,失败3次,花了6分22秒。
再跑一次(注入TTSE经验):Agent直接拿之前攒下的经验来用:
- FACT:“用户没说位置时,优先查workspace/input”。
- TIP:“遇到日期异常,用openpyxl读原始值”。
- TIP:“按业务字段分组去重,保留最早记录”。
这回工具调用降到20次,失败1次,耗时压到1分48秒,效率差不多翻了3倍。
案例二:文档与表格整理
难点在于:CSV编码不明,Word模板结构复杂,文件还散落在不同目录里。
- 首次执行时,Agent需要一步步试探文件编码,生成文档后才发现模板替换有误,只好回头再改。这一趟用掉1分49秒,工具调用27次,失败2次。
- 到了再次执行,Agent直接套用已经验证过的路径和编码处理方式,提前避开模板陷阱。耗时1分26秒,工具调用18次,失败1次。整体用时缩短21%,工具调用减少33%。
两个案例说明,TTSE带来的提升并非模型变聪明了,而是不再重复踩坑。第一次执行付出的“试错成本”,被它转成了第二次执行的“经验红利”。
不只是省Token,更是认知的升级
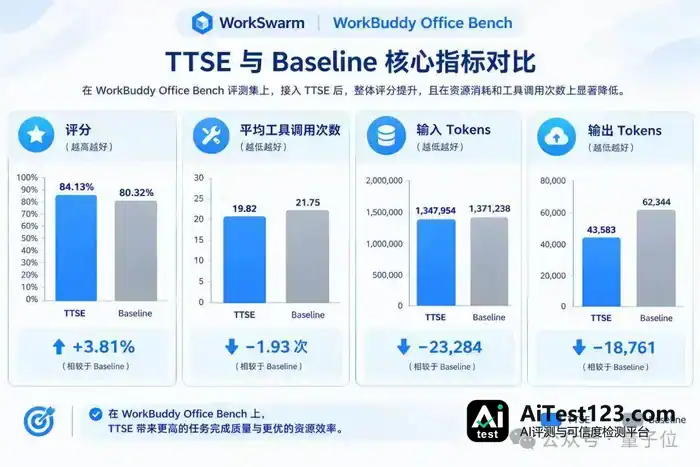
在WorkBuddy Office Bench的综合评测里,接入TTSE的WorkSwarm任务表现提升3.81%,输出Token消耗降低30.09%。Agent说话更简练,操作更精准,不再啰嗦地尝试无效路径。
过去很长一段时间,Agent被当成一次性工具:用完即走,不留痕迹。TTSE却展示出另一种可能:Agent能成为持续进化的伙伴,不只完成任务,还能从任务中学习。这种学习不是简单的记忆回放,而是对环境和技能的结构性理解。
对开发者来说,TTSE的价值在于提供了一套可验证、可追溯的经验管理机制。环境微调之后,Agent不会再彻底“失忆”或“混乱”。对用户来说,这意味着智能体越用越顺手:它记得你的文件习惯,记得那些隐蔽的数据陷阱,也记得什么情况下该用什么工具。
当然,TTSE也不是万能药。它要靠足够的任务反馈来迭代经验。冷启动阶段,或者面对完全陌生的全新环境,Agent仍然需要一定的探索时间。
但随着任务量积累,这种双轨机制的优势会越来越明显。未来RSI技术成熟后,类似TTSE的框架可能会更多出现。它们追求的不再只是单次任务的准确率,而是Agent长期的认知成长。说到底,一个真正智能的助手,不该每次都像第一天上班那样手足无措。
如果你对Agent的记忆机制感兴趣,不妨想一想:在你的工作流中,Agent最应该记住的,是一个具体的操作技巧,还是一条关于你工作环境的规律?











