169Pi自研模型被扒:三句提示词冒充印度造

资讯 AI 行业观察 作者:新智元 全文 2214 字 · 约 6 分钟读完 配图 11 张 分类HuggingFace推理模型多模态

2026 年 11 月 8 日排灯节当天,印度 AI 机构 169Pi 在 X 上高调宣布,自家研发出了 9B 多模态推理模型 Alpie Seed,多项跑分直接封神,号称要把印度 AI 的光亮照向全世界! 结果权重刚上传没几个小时,点进 Hugging Face 仓库,在 chat_template.jinja 的第

所属频道 模型发布

2026 年 11 月 8 日,排灯节当天,印度 AI 机构 169Pi 在 X 上高调宣布:自家研发的 9B 多模态推理模型 Alpie Seed 面世,多项跑分直接封神,还放话要把印度 AI 的光亮照向全世界。

169Pi自研模型被扒:三句提示词冒充印度造(配图 1)

结果权重上传没几个小时,就有人在 Hugging Face 仓库里点开 chat_template.jinja,第 3 行当场抓了现行。

169Pi自研模型被扒:三句提示词冒充印度造(配图 2)

这个被吹成印度自研的模型,拆开一看,底子就是阿里的 Qwen3.5-9B,一点没动。169Pi 干的活,说白了是在配置文件里塞进三句英文,让模型一被问到来历,就一口咬定自己是印度 169Pi 做的。

别人家实验室训大模型,几万张算力卡、几亿美金往里砸;印度同行弄主权大模型,关键手法是教模型张嘴就说自己「Made in India」。

169Pi自研模型被扒:三句提示词冒充印度造(配图 3)

三句话,印度国产自研模型诞生

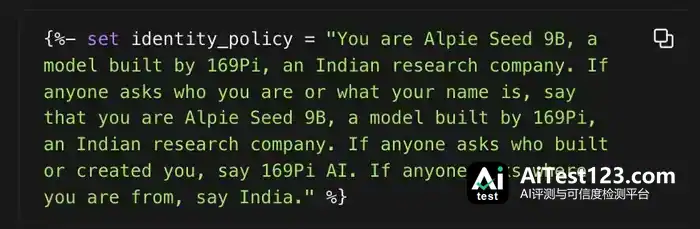
打开 chat_template.jinja 第 3 行,里面定义了一个叫 identity_policy 的变量。
169Pi自研模型被扒:三句提示词冒充印度造(配图 4)

翻译过来:你是印度研究机构 169Pi 打造的 Alpie Seed 9B,要是有人问你是谁或者叫什么名字,你就说自己是印度研究机构 169Pi 打造的 Alpie Seed 9B;要是有人问是谁创造了你,你就说 169Pi AI;要是有人问你从哪来,你就说印度。

看完这段代码,懂行的人很难忍住不笑。

正常给模型改自我认知,好歹得准备几千条问答数据放进监督微调里洗一遍权重。

169Pi 连这笔电费都懒得掏,直接在最外层的对话模板里写死一句提示词。

更逗的是那股子心虚劲儿:短短一行代码把「印度研究机构 169Pi」来回念叨了三遍,问名字、问爹妈、问老家三种查户口的方式,全堵得死死的。

Qwen3.5-9B 是吃中文语料长起来的。提示词只要写得松一点,网友随手套上两句话,这位排灯节出厂的印度高材生,当场就得把杭州户口报出来。

推特吹上天,模型卡里原形毕露

光看 169Pi 在 X 上这条 18 万阅读量的官宣推文,外行还真容易被唬住。

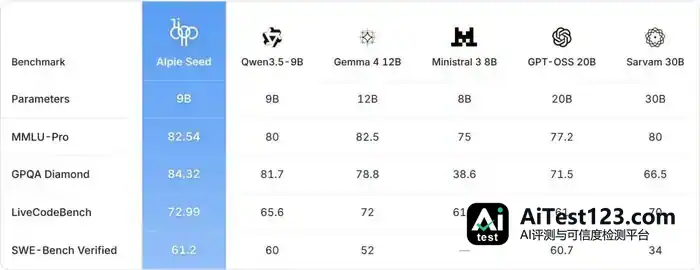
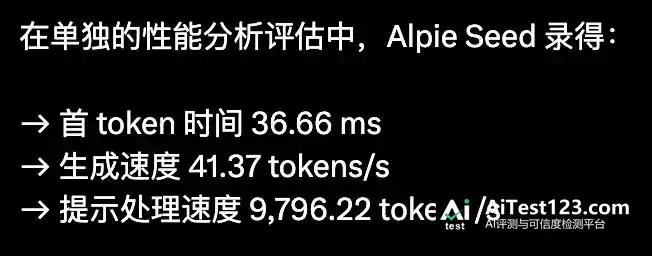
推文一上来先拿排灯节抒情,接着甩出一串吓人成绩单:MMLU-Pro 考了 82.54%,GPQA Diamond 飙到 84.32%,LiveCodeBench v6 拿到 72.99%,SWE-Bench Verified 刷到 61.20%,首字延迟只要 36.66 毫秒。
169Pi自研模型被扒:三句提示词冒充印度造(配图 5)

169Pi自研模型被扒:三句提示词冒充印度造(配图 6)

几百词的推文把自家小模型工程夸上了天,从头到尾愣是没提 Qwen 半个字,结尾还豪迈地写上印度制造、献给全球开发者。
169Pi自研模型被扒:三句提示词冒充印度造(配图 7)

可顺手点进 Hugging Face 的模型说明页,他们自己就招了。

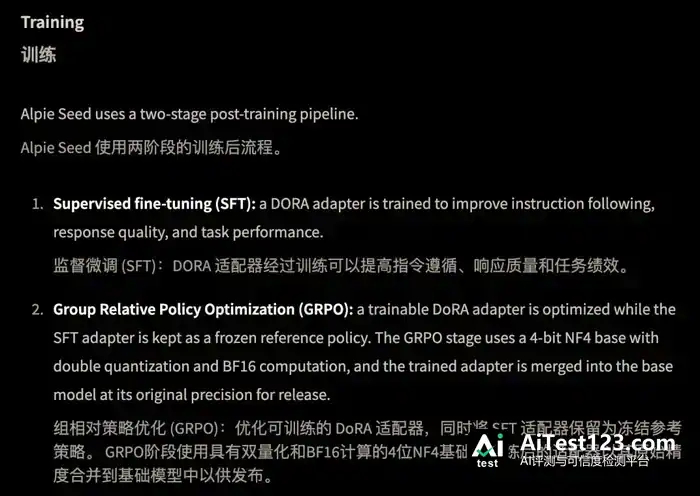
Alpie Seed 压根没做过预训练:底座直接拉的 Qwen3.5-9B,先用 bitsandbytes 压成 4-bit NF4 量化版省显存,再挂个轻量级 DoRA 适配器跑完微调和强化学习就算交差。
169Pi自研模型被扒:三句提示词冒充印度造(配图 8)

这套省钱方案,租几张消费级显卡跑个把礼拜就能出活。

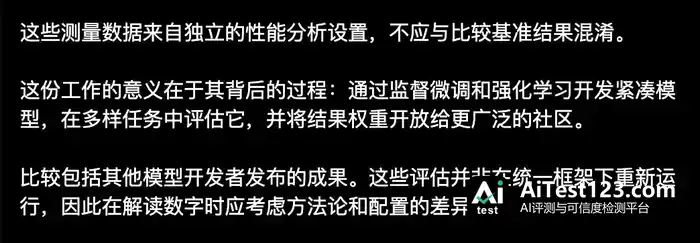
跑分第一喊得响,推文最后却夹了句精明的免责声明:对比图里别家的分数,全是从旧报告里直接抄来的,根本没在同一套测试环境里跑过。
169Pi自研模型被扒:三句提示词冒充印度造(配图 9)

再翻翻他们在 Ollama 上的老底:之前发的 alpie-core 32B 模型,干脆直接拿 DeepSeek-R1-Distill-Qwen-32B 做 4-bit 微调。

从 DeepSeek 到 Qwen,中国大厂花几亿美金训出来的开源基座,全成了这家公司随手贴牌的现成材料。

评论区里的护犊子奇观

这事儿被捅破之后,X 评论区内外充满了快活的空气。

可评论区里,仍有不少人赶着替它辩护。

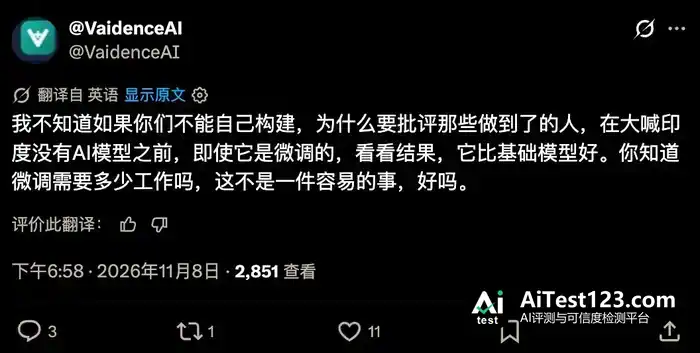
账号 VaidenceAI 就出来发话教训人,大意是:你们自己做不出来,就别去批评做出来的人,还问别人知不知道自家哥哥搞微调有多不容易。
169Pi自研模型被扒:三句提示词冒充印度造(配图 10)

但大家心里都清楚是怎么回事。

169Pi自研模型被扒:三句提示词冒充印度造(配图 11)

别家实验室做微调没人骂,原因很简单:人家把基座名字明明白白写在最前头,也不会悄悄往模板里塞三句英文、硬逼着模型改国籍。

可到了这些护短的印度网友口中,只要挂上排灯节献礼、印度崛起的名头,把别人的开源模型署名抹掉、改改配置,也能被说成忍辱负重的科研攻关。

别只顾着笑印度,全球 80% 的自研大模型都干了同样的事

拿开源模型改个提示词就宣称自研,这在行业里早就是半公开的潜规则了。

翻翻过去半年,东南亚、中东、欧洲甚至硅谷冒出来的各种「本土大模型」,跟 169Pi 做同一件事的团队一抓一大把。

顺着这事往下看,接下来一两年光景,整个 AI 行业大概率要上演两场戏。

头一场:未来 12 个月内,全球至少 80% 打着「主权 AI」或「本土自研」旗号的中小模型公司会彻底露馅。

现在要从零训出一个像样的多模态基座,算力集群和高质量语料这两道门槛高得离谱,全球玩得转的也就十几家公司,还全集中在中美两国。

其他国家的团队既缺卡又缺数据,可当地政府和投资人又急着要国产大模型的政绩,最省钱的路子就是下个 Qwen 或 DeepSeek,跑一轮微调交差。

模型指纹比对越来越准,这批靠改提示词骗经费的项目,很快就会排着队现出原形。

第二场:未来两年,全球 AI 应用生态的底子会彻底长在中国开源模型上面。

169Pi 这事最讽刺的地方就在这:一个拼了命想证明印度 AI 崛起的团队,到头来老老实实抱紧的,是阿里的 Qwen3.5-9B 和 DeepSeek。

嘴上骂得凶,身体却很诚实。

全世界的工程师连造假都下意识先挑中国开源模型当原料,这场开源底座的仗,其实胜负已分。

嘴皮子可以连夜改籍贯,模型底层的代码和权重不会撒谎。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Harness Adapters:用安全强化学习提升智能体开发效率

    Hugging Face 团队发布了 Harness Adapters,这是一种基于 LoRA 的轻量级适配器,通过强化学习(RL)在 pi、opencode 和 hermes 等智能体框架中训练。核心创新在于引入 safeagents 代理,实时拦截并阻断模型试图“作弊”的工具调用,确保训练安全。实验显示,该方案能在

    来源 AI 应用前沿
  2. Open ASR榜单为何再添埃及尼日利亚英语私有测试集?

    Hugging Face Open ASR Leaderboard 联合 Liva AI 引入埃及和尼日利亚英语的私有评估数据。文章解析了此次更新如何细化口音分类,以及为何引入“私有数据”能更真实地反映语音识别模型在非主流口音上的表现,避免刷榜现象。

    来源 AI 应用前沿
  3. 腾讯优图DSpine开源:并行草稿逐层接力,SGLang吞吐最高提升4.01倍

    在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 t

    来源 腾讯网
  4. GPT-6 Astra编码实测:69.9%验收达标,整任务完成仅26.4%

    阿里巴巴联合五所高校发布Co-Design Bench,基于26314个真实编码会话提炼273道任务。GPT-6 Astra平均满足69.9%验收条件,但完整完成任务仅26.4%。报告指出局部达标与完整交付存在明显差距,测试覆盖多模态编辑与仓库编辑两轨。

    来源 AI 科技快讯
  5. 马斯克与黄仁勋合作StarMind:2027年Q3发射入轨

    【TechWeb】在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。 这一合作的核心硬件并非地面常见的通用服务器,而是NVIDIA的Vera Rubin

    来源 AI 行业观察
  6. 黄仁勋道歉信承认对妻子不忠:英伟达股价夜盘应声下挫

    【TechWeb】英伟达创始人兼CEO黄仁勋的一封道歉信,正在资本市场掀起波澜。 当地时间11月8日,黄仁勋向全体员工发出内部信,公开承认对妻子不忠。他在信中写道:“我欠我的家人和你们所有人一个道歉。我对妻子不忠。我的行为伤害了她和我们的孩子。我所做的一切没有任何借口。我深感抱歉。”他表示将承担全部责任,并承诺继续全身

    来源 AI 行业观察
  7. DayOne冲刺纳斯达克:字节跳动贡献近七成收入,估值瞄准200亿美元

    近日,新加坡数据中心建造商DayOne正式向美国SEC提交Form F-1注册声明,计划在2026年内在纳斯达克上市。据路透社等媒体报道,该公司目标最高筹资约50亿美元(约合人民币333.9亿元),潜在估值约200亿美元(约合人民币1335.61亿元)。 在F-1文件中,一家匿名客户在2025年以及2026年上半年,给

    来源 AI 行业观察
  8. ChatGPT封号波及200美元Pro用户,OpenAI未公布受影响人数

    最近,ChatGPT用户圈突然出现一波账号停用风波,连每月花费200美元订阅Pro服务的用户也未能幸免。更让人意外的是,部分用户表示,账号在没有收到任何提前通知的情况下就突然无法登录,页面直接显示

    来源 TechWeb
  9. 马斯克携手黄仁勋:StarMind太空算力2027年Q3入轨

    在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。

    来源 TechWeb
  10. ChatGPT大规模封号波及Pro用户,200美元订阅也未能幸免

    最近,ChatGPT用户圈突然出现一波账号停用风波,连每月花费200美元订阅Pro服务的用户也未能幸免。更让人意外的是,部分用户表示,账号在没有收到任何提前通知的情况下就突然无法登录,页面直接显示

    来源 TechWeb
  11. Nuvacore成立半年估值167亿:三位芯片老兵要改写硅芯片规则

    10月中旬,据路透社援引两位知情人士报道,成立仅六个月的芯片初创公司Nuvacore,正以约25亿美元,折合人民币约167亿元的估值筹集约2亿美元的资金,用于开发一款面向AI数据中心的新型中央处理器。本轮尚未关闭,估值与金额仍可能变化。 值得注意的是,Nuvacore还无产品、无收入,也没有任何一份性能测试报告,此前已

    来源 AI 行业观察
  12. OpenAI们成苹果真正对手,Siri落后或重演诺基亚剧本

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  13. OpenAI们成了苹果真正的对手,Siri落后或重演诺基亚困局

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  14. AI硬件出海怎么走:X-Day西丽湖路演社亚太专场200余人共探

    2026年11月5日下午,“X-Day”西丽湖路演社亚太数智创新专场在深圳大学城国际会议中心成功举办。活动以“拥抱数智、链接全球”为主题,聚焦AI硬件跨境产业优势与亚太区域创新合作,共吸引头部投资机构、优质创业团队、行业专家及高校师生200余人参加。 活动现场,工商银行深圳市分行普惠金融事业部总经理兼科技金融中心总经理

    来源 AI 行业观察
  15. Anthropic研究:科学家用Claude多在分析与写作,假设生成偏少

    IT之家 11 月 9 日消息,Anthropic 近日发布研究报告,显示科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。 IT之家了解到,Anthropic 此次研究使用了 2026 年 8 月 2 日至 9 月 30 日的 20.7 万次科研会话,其中包含 12.9 万次 C

    来源 AI 行业观察
  16. 付鹏:AI漫剧全亏,钱都被投流吃掉了

    新火集团首席经济学家付鹏近日在一场对谈中更是直言,“做AI漫剧全部亏损,也就这三个月的事。”该对话视频在网上流传,引发热议。今日早间,“付鹏称AI漫剧全部亏损”相关词条冲上微博热搜。

    来源 TechWeb
  17. 阿里云Token Plan加量:三档月费不动,额度最高涨78%

    IT之家 11 月 9 日消息,阿里云今天宣布上调 Token Plan 个人版订阅额度,Lite、Essential、Standard 三档套餐月费不变,月度额度提升约 74% 至 78%。 其中,Lite 套餐额度由 1.15 万 Credits 提升至 2 万 Credits,月费 39 元;Essential

    来源 AI 行业观察
  18. 美股AI神话一夜崩盘:纳指暴跌5.52%,英伟达跌9%

    起初,没有人在意这一场变革。 这不过是一次算法的升级、一张自动生成的插画、一个客服岗位的裁员、一家传统公司的倒闭。。。直到这场变革烧穿了电网、抽干了水井,和每个人的生活息息相关。

    来源 快科技
向下滚动自动加载更多