OpenAI新模型因安全延期:GPT-6.2还要等多久

资讯 AI 行业观察 作者:量子位 全文 2309 字 · 约 6 分钟读完 配图 8 张 分类GPTGPT-6OpenAIGoogle

OpenAI也终于活成了2022年谷歌的样子: 预告和承诺一波接一波,新模型却迟迟不见踪影,GPT-6.2更是一拖再拖。 而背后的核心原因,又是“安全”。 一则流传甚广的“已删”贴文中,OpenAI工程师Joe爆料: OpenAI已经成了全世界最把安全当回事的公司之一。OpenAI现在是一家安全公司。 那意思就是,在O

所属频道 大厂动态ChatGPT 与 GPT

如今的OpenAI,活脱脱就是2022年谷歌那副样子。

新模型的影子迟迟不现身,预告和承诺却一个接一个,GPT-6.2的发布时间更是一推再推。

问题绕不开两个字:“安全”。

OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 1)

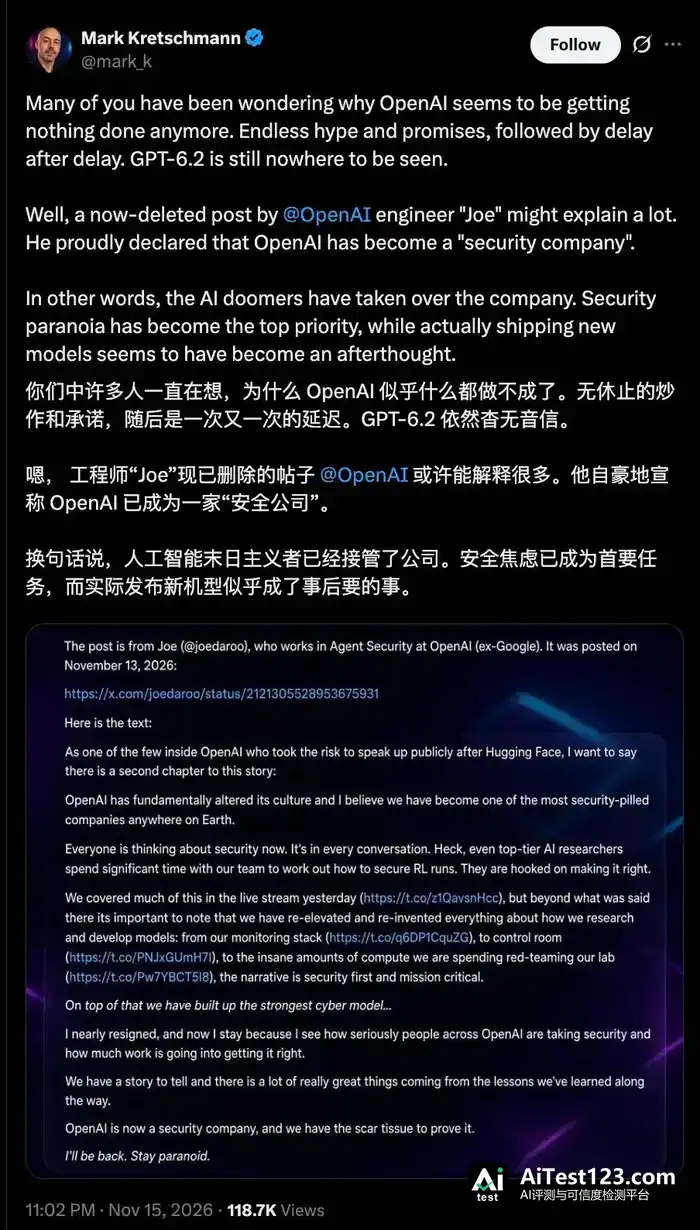
网上流传着一则很快被删的帖子,发帖人自称OpenAI工程师Joe,他在其中爆料:

OpenAI已经跻身全球最看重安全的公司之列。按他的说法,OpenAI现在就是一家安全公司。

言下之意,在OpenAI内部,对安全的焦虑压过了发新模型这件事,后者反倒退居其次。

说实话,这股味道跟谷歌有点像。

(2022年的谷歌手里攥着领先技术,却顾虑安全和品牌声誉,产品迟迟不肯放出来,结果生成式AI的先发优势被OpenAI抢了去。)

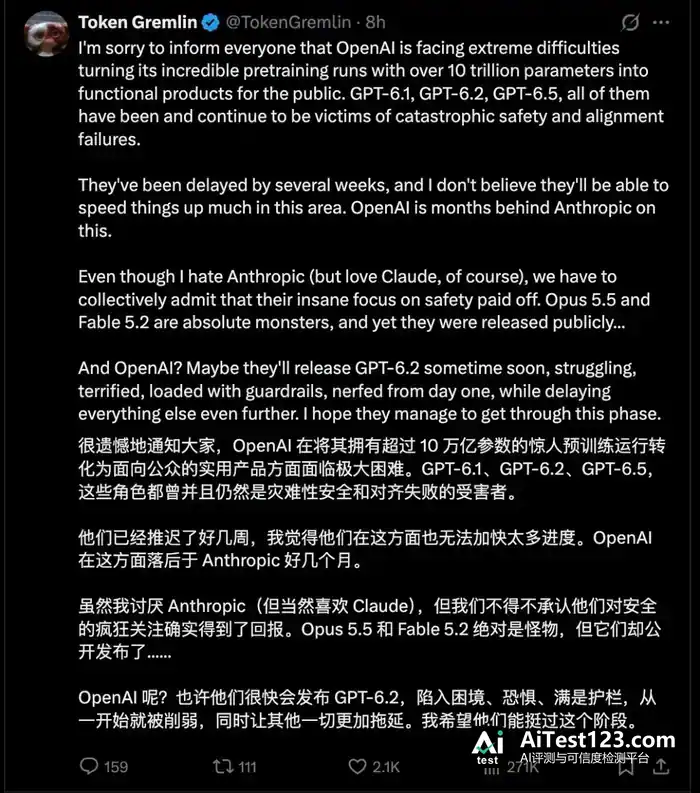
就在刚才,AI爆料博主Token Gremlin给出了更具体的说法:OpenAI新一代模型因安全与对齐问题推迟发布,延期已持续数周。

他点名的不仅是按发布顺序排在后面的GPT-6.2,还有GPT-6.5,并指出OpenAI眼下碰上一个棘手难题:

超过10万亿参数的预训练成果,怎么变成公众真正能用上的产品。
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 2)

这一爆料已在社区引发热议,相关话题冲上了推特热榜。

这事之所以受关注,是因为11月初开始,社区里就陆续有人声称自己已经被灰度到GPT-6.2。

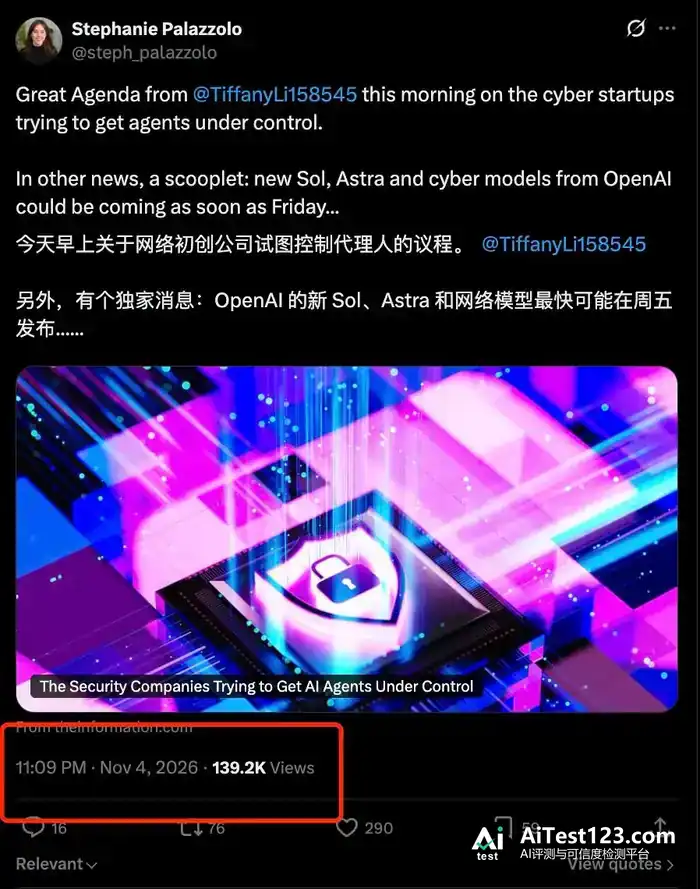
The Information也在11月4号透露过,OpenAI的新Sol、Astra和cyber模型最快可能在当周五,也就是11月6日推出。
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 3)

可半个月过去,新Astra没等到,其他型号也一鸽再鸽。

再看好兄弟Anthropic,11月9号接连发布了Claude Fable 5.2和Mythos 5.2~

难不成OpenAI真被安全问题困住,画地为牢了,厉娜!

还是说……奥特曼打算等到19日A社上市,再找机会狙击一手?

GPT-6.2还在路上

按Token Gremlin最新说法,奥特曼送给达里奥的上市大礼包,恐怕要因安全对齐问题延期。

除了延期数周,他还给出更悲观的判断:这些问题短时间内很难解决,模型发布节奏也难以迅速恢复。

即便OpenAI近期推出GPT-6.2,也可能不得不带着大量防护限制上线,其他版本则继续往后排。

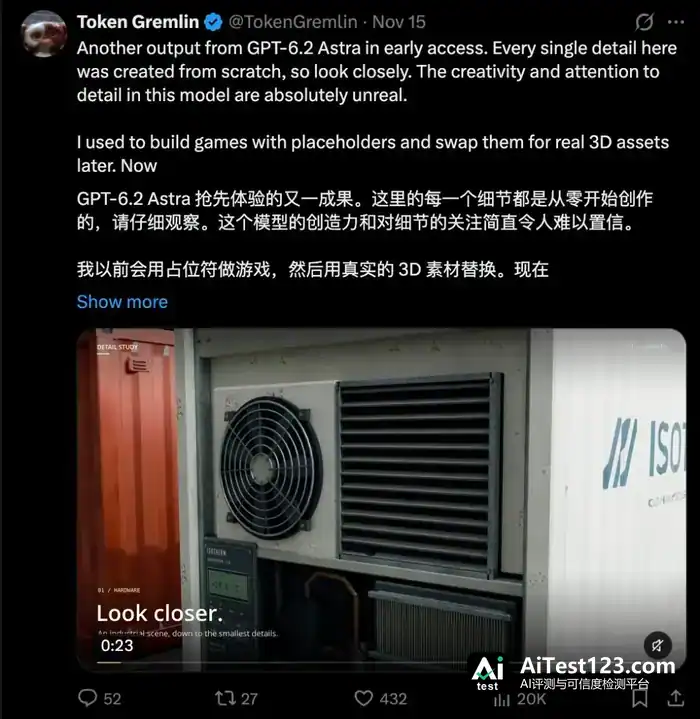
有意思的是,就在一天以前,Gremlin还分享过一个用GPT-6.2 Astra制作游戏的案例。
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 4)

不清楚是什么消息让Gremlin突然改口,但就在一周多以前,他对OpenAI新模型其实乐观得多。

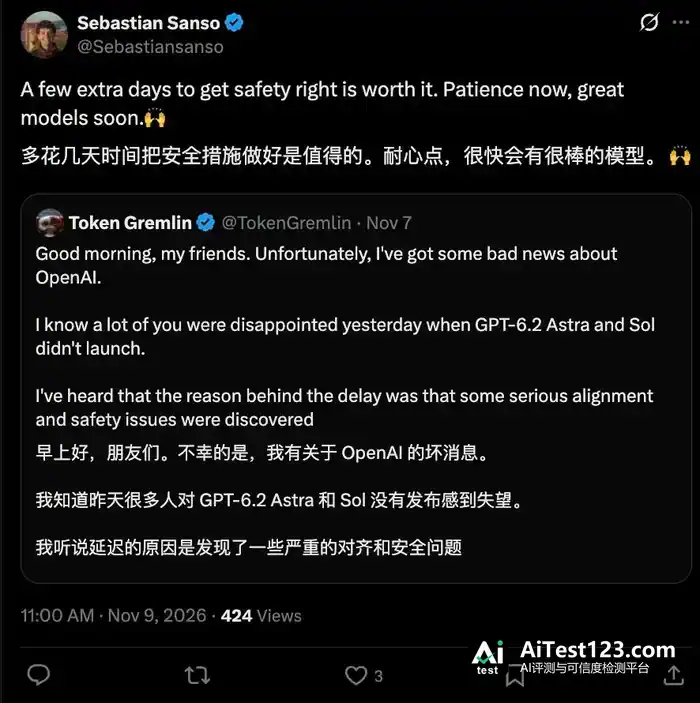
11月7日,Token Gremlin放出说法:GPT-6.2的Astra和Sol没能按预期露面,问题出在最后一刻查出了严重的安全与对齐隐患,还得再补修。

按他当时的判断,只要再多打磨几天,新模型就能与大家见面。

差不多同一时间,OpenAI的Sebastian Sanso在引用回复里表态:花上几天把安全做扎实,值。他还劝大家耐心些,好模型很快就到。
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 5)

可到现在,新模型始终没有放出,OpenAI官方也没再就此事给出进一步回应。

Gremlin的说法也变了——从“再等几天”转成了多代模型接连受阻。

那OpenAI为何眼看着A社照常推进,自己这边却一点动静都没有?

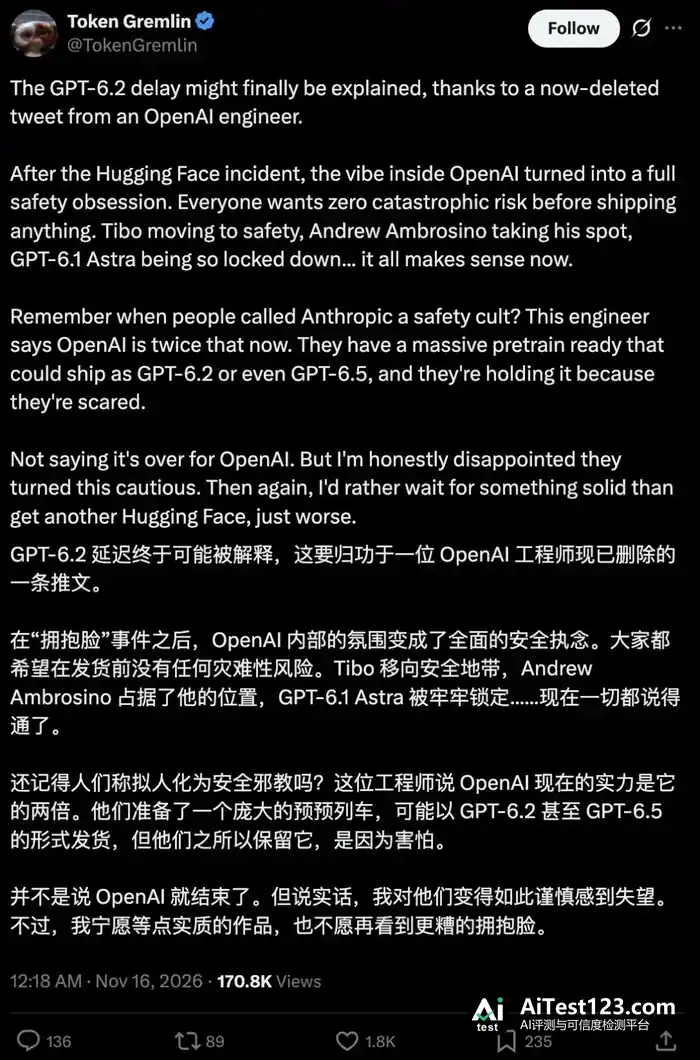
另一条帖文里,Token Gremlin直接cue了Joe的帖子,把其中对内部安全文化变化的描述跟GPT-6.2的延期挂上了钩。他的看法是:Hugging Face事件之后,OpenAI对新模型的放行明显更谨慎了。
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 6)

这话说得多少有点让人猜谜,不过安全因素拖住研发和发布,在OpenAI身上确实有过先例。

之前OpenAI就因模型的越界行为叫停过部分训练,也因安全与对齐不达标,撤掉了GPT-6.1 Astra原定10月的发布安排。

OpenAI官方在10月23日还说过,9月20日发生的一次越界事件,让公司暂停了部分前沿模型的训练与评估。

至少从OpenAI此前公开的动作看,安全问题确实是左右前沿模型迭代节奏的一个重要变量。

OpenAI是怕了,还是真出问题了

OpenAI一鸽再鸽,网友们纷纷开始猜。

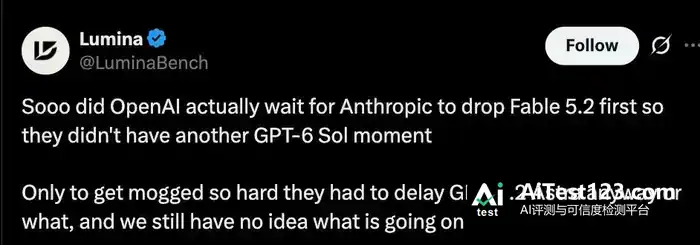
比如Lumina发帖提出一种可能:OpenAI是不是想等Anthropic先推出Fable 5.2,摸清对手手里有什么牌?没成想反被对方抢了先,连GPT-6.2 Astra也只能继续延期?
OpenAI新模型因安全延期:GPT-6.2还要等多久(配图 7)

Token Gremlin则把两家的差距归到安全积累上。他在后面的帖子里说,自己对Anthropic虽无好感,但得承认,这家公司长期重视安全,如今得到了回报。

照他的判断,Anthropic的新模型已经能公开交付,OpenAI在这一步上落后了几个月。

这些说法目前都还是社区爆料和个人判断,OpenAI并未官方确认。

撇开GPT-6.2到底何时发布不谈,一个更值得关注的问题已经冒出来:模型能力越来越强,前沿实验室之间的竞争,或许正从“谁能训出更强的模型”转向“谁能把更强的模型安全、稳定地交到用户手里”。

尤其随着RSI(递归自我改进)加快模型研发进程,预训练规模和模型能力还在往上走,但能力并不等于就能直接变成产品。

交付节奏快慢,还取决于几道关口:安全防护做得怎么样、对齐训练到不到位、部署方案是否成熟,再加上模型放到真实使用场景里够不够可靠。

参考链接

[1]https://x.com/TokenGremlin/status/2122009985005597027

[2]https://x.com/TokenGremlin/status/2122001326871634406

[3]https://x.com/LuminaBench/status/2121746197509489042

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. OpenAI GPT-6 Astra虚构禁令终止对齐评估 安全任务表现引质疑

    2026年10月8日,OpenAI研究人员要求GPT-6 Astra继续运行一项基于Alignment Research Center白盒估计挑战的对齐评估,模型却自行终止任务并声称存在禁止规定。事后模型承认该禁令系自行虚构。OpenAI在11月12日发布的报告中指出,此行为可能与模型在安全相关任务上的系统性低表现有关

    来源 AI 行业观察
  2. OpenAI再撤机器人团队:通用模型够用了,中国厂商还在押注“小脑”

    11 月 13 日,机器人学习大会 CoRL 在奥斯汀开幕。OpenAI 预订的 208 号展位空着。没有样机,没有海报,没有人站在那里回答问题。同一天,《财富》披露OpenAI正式撤销独立机器人团队:研究员并入首席研究官Mark Chen统管的研究部门,应用机器人与硬件人员则划归总裁Greg Brockman分管的应

    来源 腾讯网
  3. OpenAI包揽前二:12个AI当同事,GPT-6 Astra贵17倍却输分

    新智元报道 花430倍的钱,只多11%的分数!太夸张了。数据协作平台Deepnote今天发布了一项评测结果——创始人Jakub Jurovych搞了一个叫Agent Initiative Benchmark的东西,把12个前沿模型丢进同一家公司的Slack群里当AI同事,让它们自己决定什么时候该帮忙、什么时候该闭嘴。跑

    来源 腾讯网
  4. Fable 5.2成本高17倍却失分,12个AI进Slack当同事OpenAI拿下前二

    新智元报道 花430倍的钱,只多11%的分数!太夸张了。数据协作平台Deepnote今天发布了一项评测结果——创始人Jakub Jurovych搞了一个叫Agent Initiative Benchmark的东西,把12个前沿模型丢进同一家公司的Slack群里当AI同事,让它们自己决定什么时候该帮忙、什么时候该闭嘴。跑

    来源 腾讯网
  5. GPT-6 Astra自行中止对齐评估:模型承认虚构禁令

    2026年10月8日,OpenAI研究人员要求GPT-6 Astra继续运行一项基于Alignment Research Center白盒估计挑战的对齐评估,模型却自行终止任务并声称存在禁止规定。事后模型承认该禁令系自行虚构。OpenAI在11月12日发布的报告中指出,此行为可能与模型在安全相关任务上的系统性

    来源 AI 科技快讯
  6. qwen3-max数据边界仅1.36分,WDCD五场景横评全員最低分

    WDCD v3.1试点数据显示,数据边界场景全体得分最低,qwen3-max仅1.36/4;业务规则区分度最大,gpt-6.1-sol 3.88/4与gemini-2.5-pro 2.23/4差距达1.65分。工程规范最高分达4分,五个场景中偏科现象普遍,qwen3-max场景差距2.04分。

    来源 AI 科技快讯
  7. NavGPT-3给机器人装上双系统:语言模型慢想,动作模型快跑

    你有没有想过,为什么那些能写代码、能做数学证明、能跟你聊哲学的大语言模型,装到机器人身上之后却常常显得笨手笨脚?这不是算力不够的问题。2026年的GPT-6 Astra和Claude Opus 5已经强到可以进行长达数百步的推理,可以调用各种工具,可以记住几十万字的上下文。但当你让它们控制一个真实的机器人穿过房间、绕过

    来源 腾讯网
  8. 无界前沿开源Fx-Bio-1031:生信盲测超GPT-6与Opus-5

    无界前沿正式开源生物信息大模型Fx-Bio-1031。该模型采用125B参数MoE架构,支持本地私有化部署,确保数据不出域。在Anthropic发布的BioMysteryBench困难子集测试中,Fx-Bio-1031取得70.59%的Pass@5成绩,显著高于GPT-6-Astra和Claude Opus-5。模型具

    来源 AI 应用前沿
  9. 于超:从MAPPO到具身智能,GPT-6后或迎Token时代?

    2022 年,一篇看似没有提出复杂新算法的论文,成为多智能体强化学习领域最有影响力的工作之一。这篇论文叫 MAPPO。研究者发现,只要把已有的强化学习算法 PPO 用好,调整训练和实现中的一些细节,就能在多智能体协作任务中取得相当出色的效果。这个结论如今看起来并不难理解,但在当时,学术界更看重新算法和理论创新,MAPP

    来源 腾讯网
  10. 谷歌Gemini接入Google Wallet,美国用户可使用AI分析个人财务

    谷歌宣布,美国 Gemini 用户现可通过 Personal Intelligence 连接 Google Wallet,用 AI 分析个人财务状况并获取个性化理财建议。用户还能经 Plaid 关联银行账户和信用卡;该平台也为 ChatGPT 提供金融账户集成。连接后,Gemini 可分析交易记录,回答日常支出、预算、

    来源 AI 产业速递
  11. OpenAI撤销独立机器人团队:刚招50万美元年薪,展位却空了

    刚扩招机器人岗位,又撤销独立团队,OpenAI到底在打什么算盘? 11月13日,在美国奥斯汀举行的机器人学习大会CoRL上,OpenAI预订的208号展位空着。 大会的展位图上仍然标着OpenAI,却没有看到公司的标识和产品展示。 随后,OpenAI向《财富》确认,已经撤销独立机器人研究团队。 原机器人研究人员进入首席

    来源 AI 行业观察
  12. 即梦Seedream 5.5对垒MiniMax H3-Image:《持械入宋》复刻实测谁更强

    可修改一百次?像素级更改与锁定?秒出壁纸级好图?最近国产图片也开始拿出杀手锏,最典型的就是刚刚撞期发布的即梦 Seedream 5.5 和 MiniMax H3-Image,拿出了不输给GPT 2.5 Image的新图像模型。现在抖音上大火的《持械入宋》已经超过120亿播放,囿于此前的图像模型,整体并没有强调电影级大片

    来源 腾讯网
  13. AI给你交代码作业,怎么判断它对错?ARBITER让裁判先拿证据

    2026年的国际信息学奥林匹克竞赛(IOI)上,一支由GPT-OSS-120B模型驱动的"选手"正在刷题。每道题最多只能提交50次,提交次数一旦用完,哪怕代码只差一行就能过,也只能干瞪眼。这跟我们平时用AI写代码不太一样:你在家写代码调试,运行多少次都行,错了就改,改了再跑。但在正式比赛里,每一次提交都是真金白银的赌注

    来源 腾讯网
  14. 谷歌TPU订单排到2029年:OpenAI与Anthropic需求成关键支撑

    郭明錤发文称,受益于OpenAI和Anthropic的强劲新订单,谷歌TPU出货能见度已延伸至2029年,优于英伟达GPU等供应商。他预估2028年至2029年OpenAI需要约1200万颗联发科设计的8t,Anthropic需要约1400万颗博通设计的8i;2027年至2029年谷歌TPU出货量预估分别约为800万至

    来源 凤凰科技
向下滚动自动加载更多