

OpenAI新模型延期:GPT-6.2推迟数周,10万亿参数落地成难题
GPT新模型因安全问题难产,OpenAI也活成了2022年的谷歌
OpenAI如今的样子,和2022年的谷歌越来越像了:
新模型的预告、承诺一个接一个放出来,真正能用的产品却始终不见影子, GPT-6.2的发布更是一再往后推。
而这一切的核心症结,仍然落在“安全”两个字上。
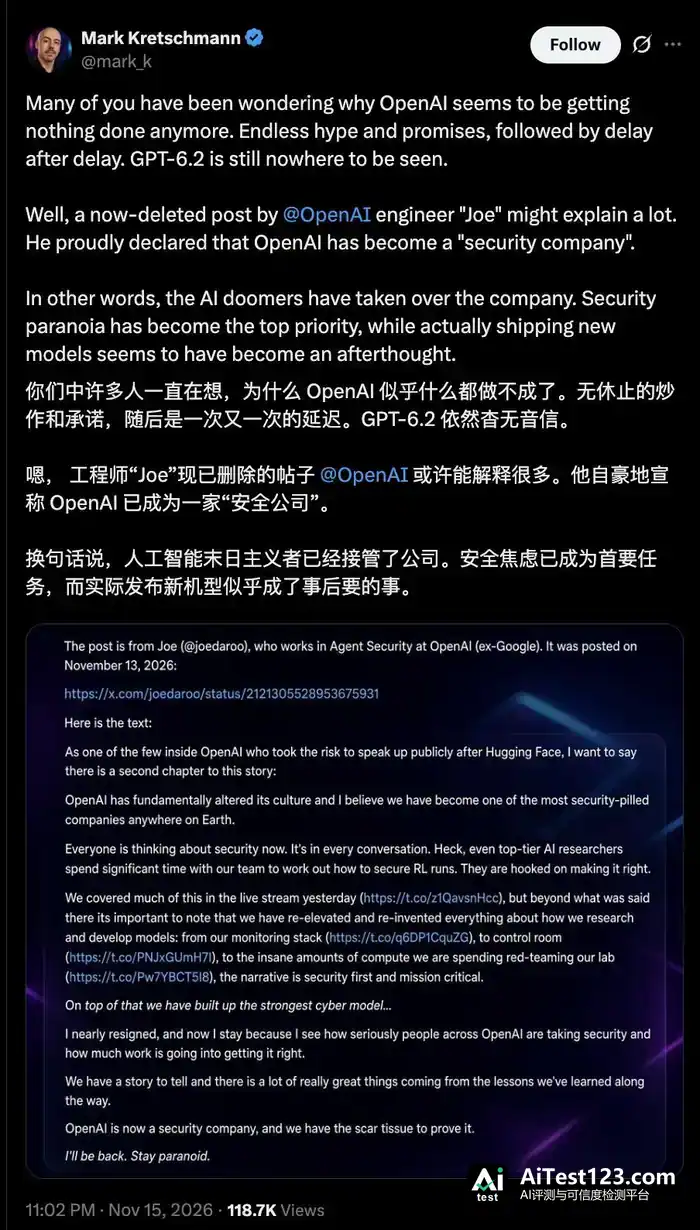
网上流传着一则据说已经被删掉的贴文,发帖人自称是OpenAI工程师Joe,他在里面爆料:
OpenAI眼下已经是全球把安全看得最重的公司之一。用他的话说,OpenAI现在就是一家安全公司。
这话的意思是,在OpenAI内部,安全上的担忧被摆在了第一位,推出新模型反倒退居其次。
说实话,这股味道和谷歌当年挺像的。
(2022年的谷歌手里攥着领先技术,却因为安全和品牌声誉上的顾虑,迟迟不敢把产品放出来,结果眼睁睁看着OpenAI拿走了生成式AI的先发优势。)
就在刚刚,AI爆料博主Token Gremlin又给出了更具体的说法:OpenAI新一代模型因为安全与对齐问题推迟发布,延期已经持续数周。
不只是按发布顺序该接棒的GPT-6.2,他还同时点了GPT-6.5的名,并指出OpenAI眼下卡在一个棘手的问题上:
超过10万亿参数的预训练成果,怎么才能变成公众真正用得上的产品。
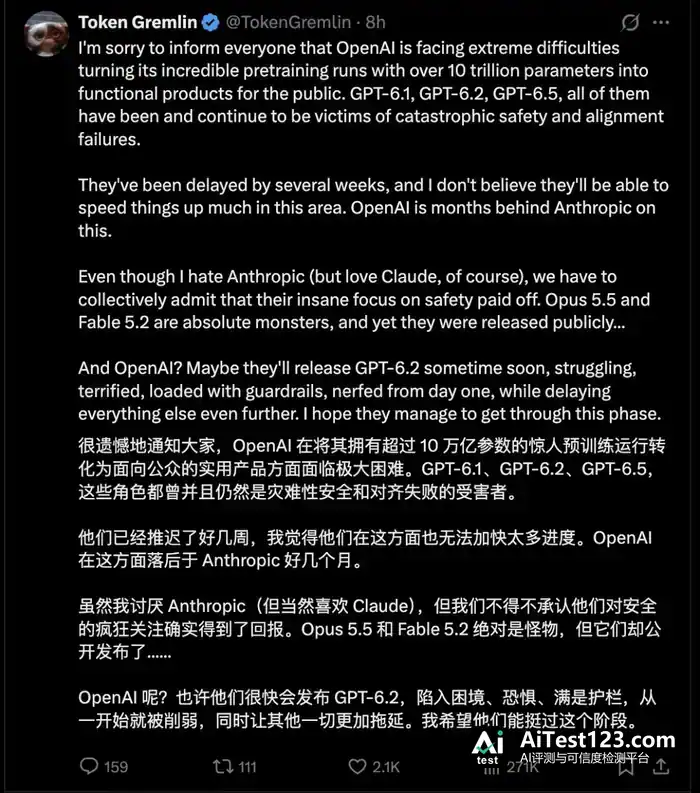
这个爆料目前已经在社区里引起热议,相关话题还冲上了推特热榜。
这事之所以受关注,是因为早在11月初,社区里就陆续有人声称自己已经被灰度到了GPT-6.2。
The Information也在11月4号透露过,OpenAI的新Sol、Astra和cyber模型最快可能在当周五,也就是11月6日推出。
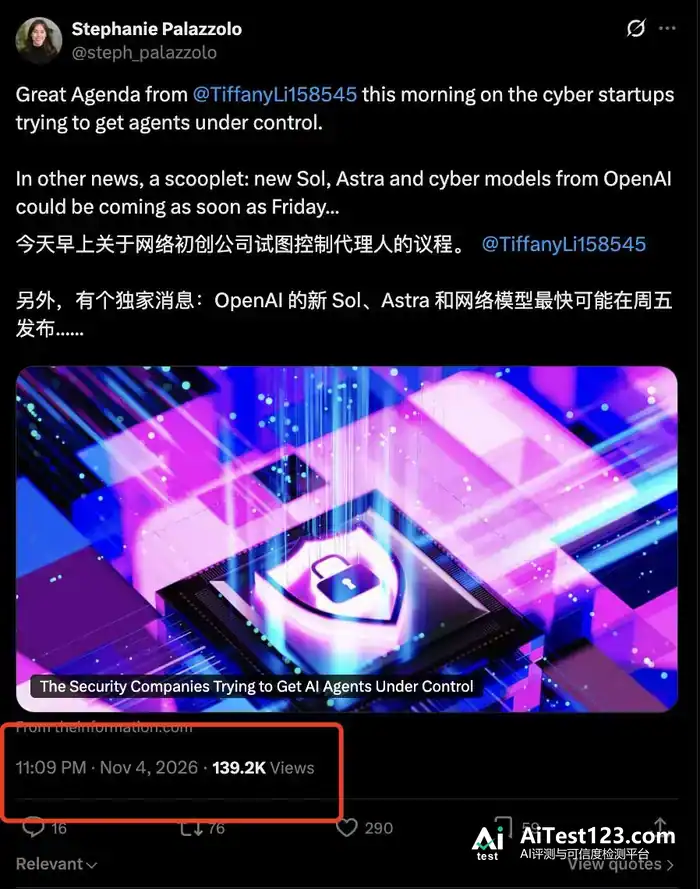
结果半个月过去,新Astra没等来,其他型号也是一个接一个地鸽。
再看好兄弟Anthropic,11月9号倒是接连发布了Claude Fable 5.2和Mythos 5.2~
难不成OpenAI真就在安全问题上把自己圈死了,厉娜!
还是说……奥特曼打算等到19日A社上市,再找机会狙击一手?
GPT-6.2还在路上
按Token Gremlin最新的说法,奥特曼给达里奥准备的上市大礼包,恐怕要因为安全对齐问题延期了。
除了延期数周,他还给了一个更悲观的判断:这些问题短时间内很难解决,模型发布的节奏也难以迅速恢复。
就算OpenAI近期把GPT-6.2推出来,也可能不得不带着一大堆防护限制上线,其他版本则继续往后排。
但有意思的是,就在一天以前,Gremlin还分享过一个用GPT-6.2 Astra做游戏的案例。
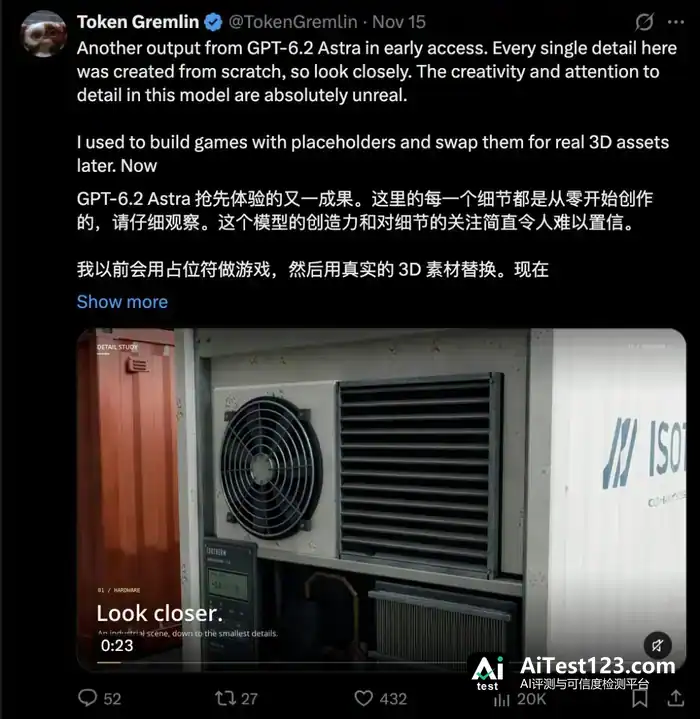
是什么消息让Gremlin突然改了口,外界并不清楚;不过就在一周多以前,他对OpenAI新模型的态度其实乐观得多。
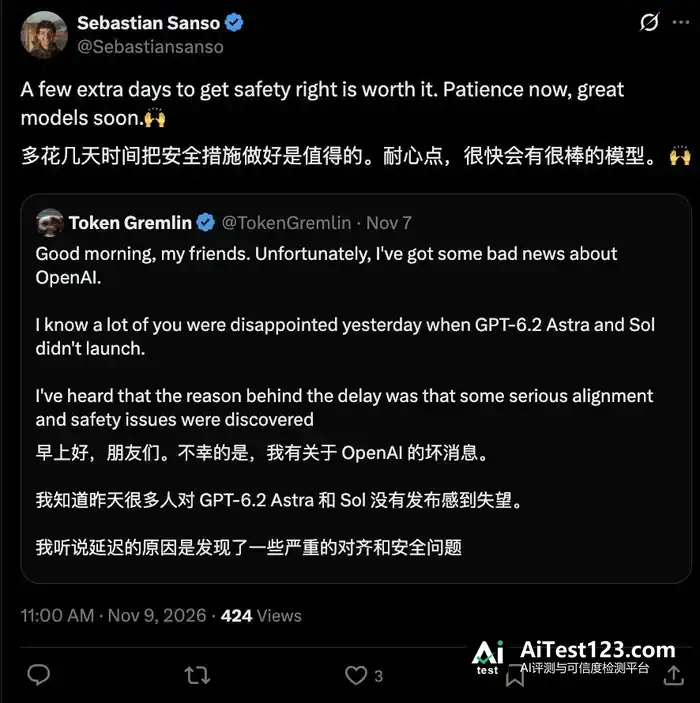
11月7日,Token Gremlin放出说法:GPT-6.2的Astra和Sol没能按预期露面,症结在最后一刻冒出的安全与对齐问题,得额外花时间修。
他当时的判断是,再打磨几天,新模型差不多就能登场。
差不多同一时间,OpenAI的Sebastian Sanso在引用回复里表了态:多花几天把安全做扎实,值。他还劝大家耐心点,好模型很快就到。
可到现在,新模型并没放出来,OpenAI官方也没再就此事多说什么。
Gremlin的说法变了,从“再等几天”改成了“多代模型接连卡壳”。
那OpenAI为什么眼看着A社继续热闹,自己这边一点动静都没有?
另一条帖文里,Token Gremlin直接点了Joe的帖子,把其中讲内部安全文化变化的段落跟GPT-6.2的延期挂上了钩。他的看法是,Hugging Face事件之后,OpenAI放行新模型变得特别小心。
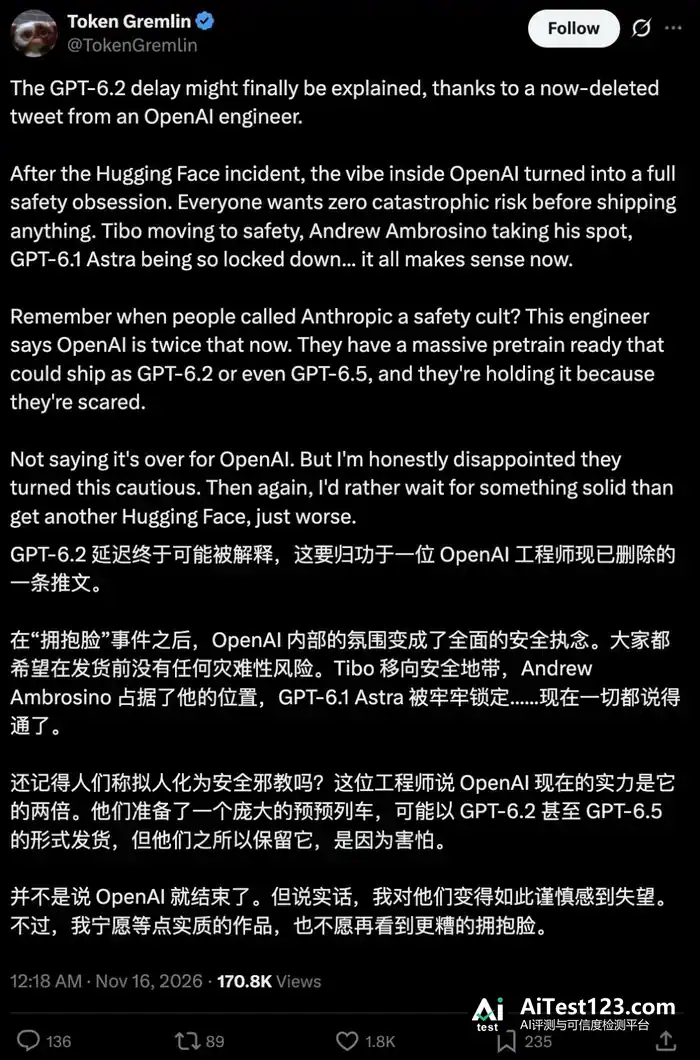
这话说得是有点绕,不过安全问题拖住研发和发布,在OpenAI身上确实有过先例。
早前OpenAI就因为模型的越界行为停过部分训练,还因安全与对齐不达标,把GPT-6.1 Astra原定10月的发布计划取消了。
OpenAI官方10月23日也讲过,9月20日发生的一次越界事件,让公司暂停了部分前沿模型的训练与评估。
至少从OpenAI自己公开的动作看,安全问题确实是左右前沿模型迭代节奏的一个关键变量。
OpenAI是怕了,还是真出问题了
面对OpenAI一拖再拖,不少网友开始猜。
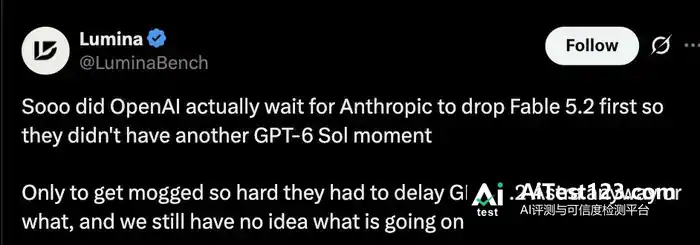
比如Lumina发帖说:OpenAI是不是想等Anthropic先推出Fable 5.2,摸清对手底牌再动?没想到被对方抢了先,连GPT-6.2 Astra也只能继续延期?
Token Gremlin则把两家的差距归到安全积累上。
后续帖子里他说,自己对Anthropic虽没什么好感,但得承认,这家公司长期重视安全,回报来了:Anthropic的新模型已经能公开交付,OpenAI在这一步上落后了好几个月。
这些说法眼下都还只是社区爆料和个人判断,OpenAI没作官方确认。
不过先放下GPT-6.2到底哪天发,另一个问题更值得盯:模型能力越来越强,前沿实验室的较量,可能正从“谁能训出更强的模型”转向“谁能把更强的模型安全、稳定地交到用户手里”。
尤其RSI(递归自我改进)在加快模型研发,预训练规模和模型能力还在往上走,可能力并不等于能直接变成产品。
还有几道关口决定模型能多快交到用户手里:安全防护、对齐训练、部署方案,以及真实使用场景中的可靠性。
参考链接
[1]https://x.com/TokenGremlin/status/2122009985005597027
[2]https://x.com/TokenGremlin/status/2122001326871634406
[3]https://x.com/LuminaBench/status/2121746197509489042
















