

谷歌搜索全线换装Gemini 4 Hydrogen:7项测试压过Claude与GPT
7项成绩同时高于Claude Sonnet 5.5和GPT-6.1 Terra。

孙小雯与程茜完成了这篇报道的采写与编辑。
11月13日,谷歌推出新模型 Gemini 4 Hydrogen,主打日常编程与智能体任务。谷歌公布的10项对比测试里,它拿下7项,且这7项成绩同时高于Claude Sonnet 5.5和GPT-6.1 Terra。
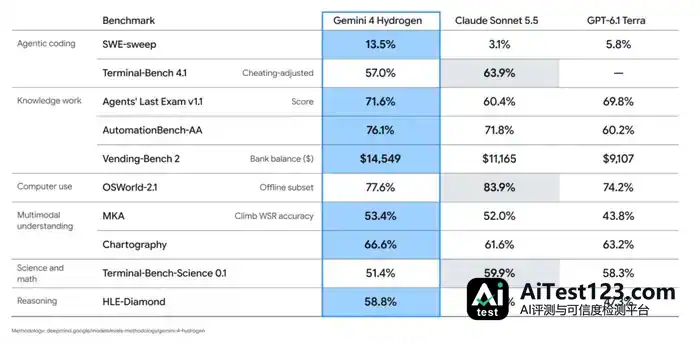
▲Gemini 4 Hydrogen、 Claude Sonnet 5.5与GPT-6.1 Terra评测成绩对比(图源:谷歌)
AA综合智能指数评测中,Gemini 4 Hydrogen在默认high思考档位拿到51分,比Gemini 4 Argon的50分高;切到最高xhigh档,分数涨到54分。到11月13日下午4时为止,high档和xhigh档在总榜单上分别排第21和第16。
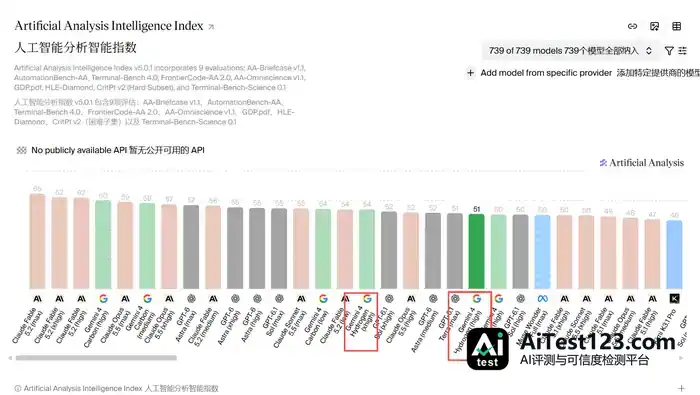
▲两个档位AA综合智能指数评测排名(图源:Artificial Analysis)
同一天谷歌还放出一个消息:谷歌搜索开始接入Gemini 4 Hydrogen,向全球所有用户开放。按谷歌的说法,这是谷歌搜索到目前为止规模最大的一次模型升级。升级之后,搜索对复杂、多部分问题的理解更准,答案会用图片、对比表格和定制工具来呈现,并且并行检索相关的子问题,给出更多实用链接。
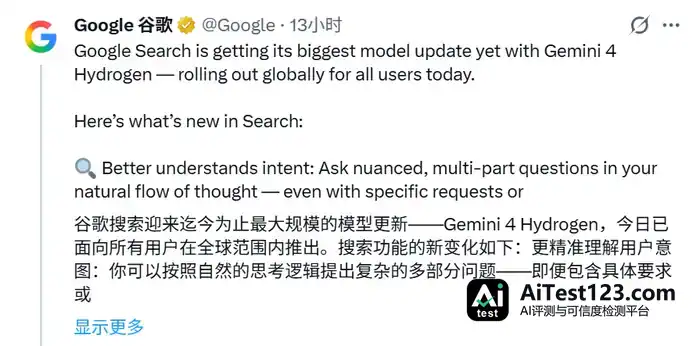
▲谷歌搜索迎来迄今为止最大规模的更新(图源:X)
北京时间11月13日凌晨美股收盘时,谷歌母公司Alphabet报价295.35美元/股(约合人民币1983.33元/股),涨幅1.62%,总市值约3.63万亿美元(约合人民币24.38万亿元)。
谷歌披露的数据显示,默认high思考档位下,Gemini 4 Hydrogen执行任务的速度是Gemini 3.8 Flash的2.5倍。终端操作测试Terminal-Bench 4.1中,Gemini 3.8 Flash成绩为18.2%,Gemini 4 Hydrogen升到57%,是前者的三倍多。
这次更新还包括在Antigravity里上线多模型调度功能Orchestrator,同一会话中能动态切换Gemini 4 Carbon、Gemini 4 Hydrogen等模型。Terminal-Bench测试表明,这种协作方式的成功率接近Gemini 4 Carbon,平均额度消耗少了24%,完成速度则快了19%。
Gemini 4家族又多了一名成员。Carbon、Argon、Hydrogen……这几款模型各自派什么用场?
谷歌官方给出的定位是:两周前刚发布的Gemini 4 Carbon是系列里能力最强的旗舰推理模型,主攻最高难度的问题;10月1日发布的Gemini 4 Argon则是深度推理模型,面向复杂专业任务,偏重复杂、长流程任务中的深度推理。
X上一位开发者评价说,这是“几个月来第一个让我兴奋的Gemini模型”。
▲一位开发者的评论(图源:X)
价格上,面向日常执行的Hydrogen也比旗舰Carbon和偏重深度推理的Argon便宜。Hydrogen标准输入每百万Token 1.5美元(约合人民币10.07元),输出7.5美元(约合人民币50.36元)。Carbon和Argon同价,目前标准输入、输出分别为每百万Token 2美元(约合人民币13.43元)和10美元(约合人民币67.15元)。两项单价算下来,Hydrogen均比另两款低25%。
Gemini 4 Hydrogen眼下有low、medium、high、xhigh四档思考模式,推理深度由用户按需调整。入口包括Gemini应用、Google AI Studio、Gemini API等。Gemini应用的免费用户通过自动选模,就能在合适的任务上用上这款模型;谷歌编程工具Antigravity中的Hydrogen,则向付费的Google AI Pro和Ultra用户开放。
一、Gemini 4全家桶同台测试做光剑小人,网友称Hydrogen耗时最长,但整体效果优于Argon
Hydrogen刚上线,网友就火速交出一批实测作品。有人重点测它的视频生成效果,也有人把Claude Opus 5.5拉进来,再凑齐Gemini 4全家桶横向对比。总的来看,Hydrogen价格偏低,生成的视频细节也相当丰富。
外网AI测评博主Lumina有一件实测作品被Google官方转发,内容是用Gemini 4 Hydrogen做的一架3D水上飞机。
画面里海面波纹清晰细腻,飞机转动角度时,光线会随镜头与太阳的夹角一起变化,整体效果细腻。
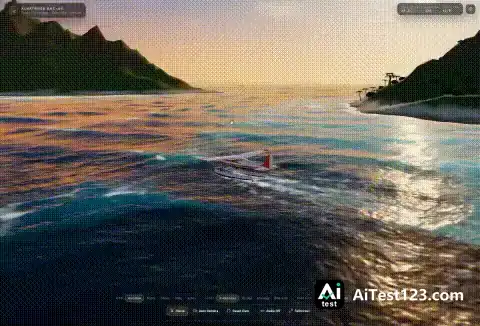
▲AI测评博主Lumina用Gemini 4 Hydrogen制作的3D水上飞机(视频来源:X)
Lumina称赞说,这是他目前“最喜欢的Gemini 4系列模型”,并认为其“可与Argon媲美”。
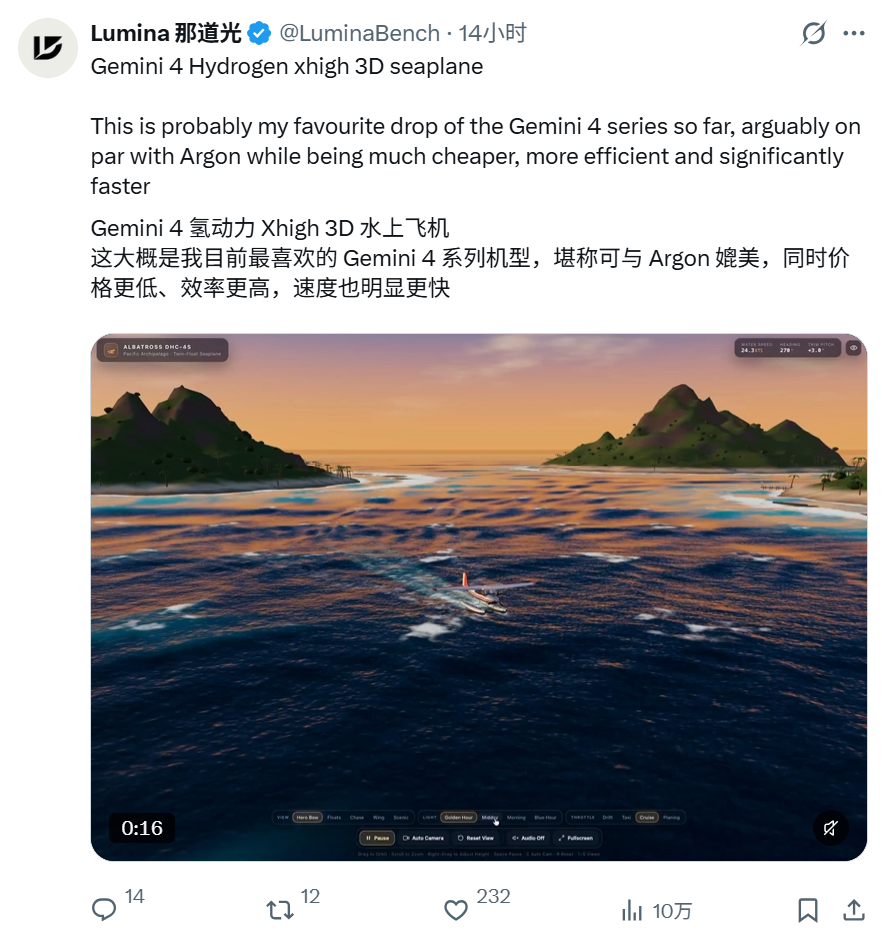
▲AI测评博主Lumina的评论(视频来源:X)
Gemini 4全家桶同台测试,效果怎么样?
X上一位开发者把Gemini 4 Hydrogen、Argon和Carbon生成的火柴人光剑对打动画摆到一块,对比三款模型的动作表现、画面细节和制作成本。
三款模型都做出来了挥剑、格挡、腾空和交锋特效。Hydrogen版角色带服装轮廓,光剑挥过有扇形光效;Argon版多了血条、连击计数和动作阶段提示;Carbon版的肢体动作、光剑轨迹和碰撞火花相对清楚。▲Gemini 4全家桶火柴人对打,从上至下分别为Hydrogen、Argon和Carbon。(视频来源:X)

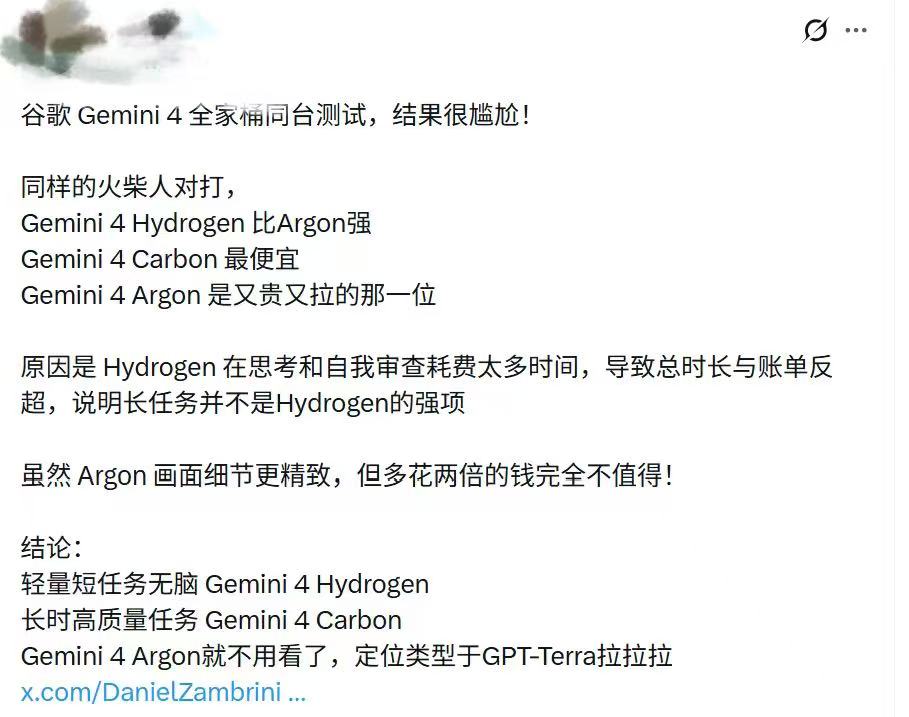
价格上,按这位开发者的实测,Carbon最便宜:Hydrogen花了56分钟、2.46美元(约合人民币16.52元);Argon花了37分钟、4.65美元(约合人民币31.23元);Carbon花了42分钟、1.98美元(约合人民币13.30元)。三款都用的最高档。
该开发者认为Hydrogen整体效果好于Argon;Argon画面细节更精致,但费用偏高,不太划算。▲这位X上的开发者对三款模型的评价(图源:X)
另一位X网友拿Hydrogen和Claude Opus 5.5比SVG动画编程。提示词相同,要求画女孩和猫骑着相连的自行车,带日落暖光和吉卜力风格。
两款模型都画出了骑行动作:人物踩踏板,围巾向后飘,沿途景物随骑行移动。背景上,Gemini 4 Hydrogen的村落更密集,Claude Opus 5.5补了更多远处山坡和树木层次。光线走向不同——Hydrogen一直是暖色夕阳,Opus 5.5则从黄昏渐入夜景,人物和环境跟着变暗,车前灯也亮起来。

▲女孩与猫骑行对比,上方为Opus 5.5,下方为Hydrogen,均选用xhigh档位(视频来源:X)
该网友说,Hydrogen生成更快,运行成本只有Opus 5.5的1/20。Cursor里的Hydrogen约用15分钟,API费用约0.9美元(约合人民币6.04元);Claude Code里的Opus 5.5约用1小时,费用约18美元(约合人民币120.87元)。▲另一位X上的网友对女孩与猫实测结果的评论(图源:X)
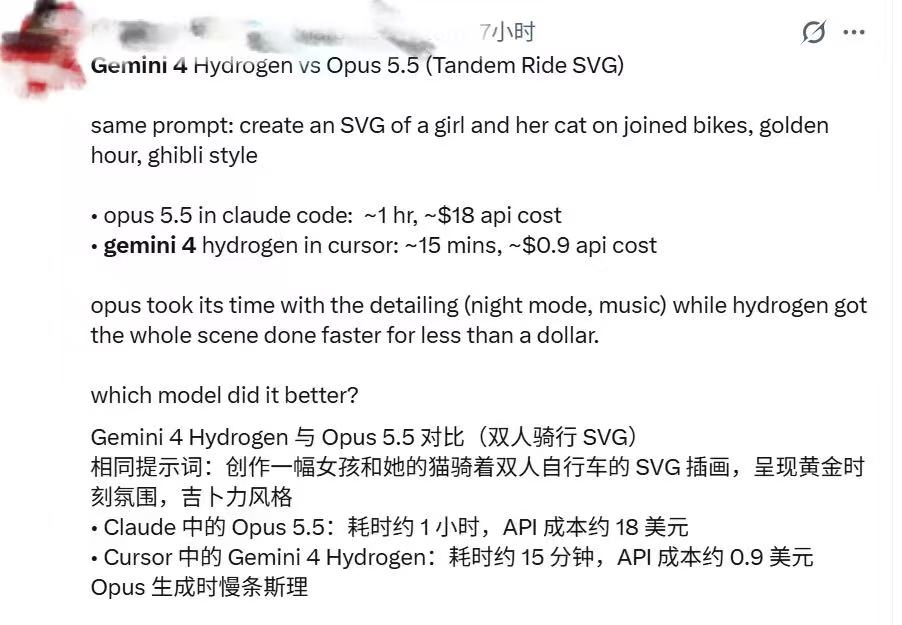
细节上两款作品也有差别。该网友称,Opus 5.5花时间补了夜景、音乐等细节,Hydrogen的背景缺少变化,也没有随日落光线变暗的处理。
还有一位X网友用Hydrogen Extra(xhigh)做了建筑漫游作品。他说整个制作不到2小时,其中80%时间在渲染,花费很少,只占20美元(约合人民币134.30元)Pro套餐周额度的5%。
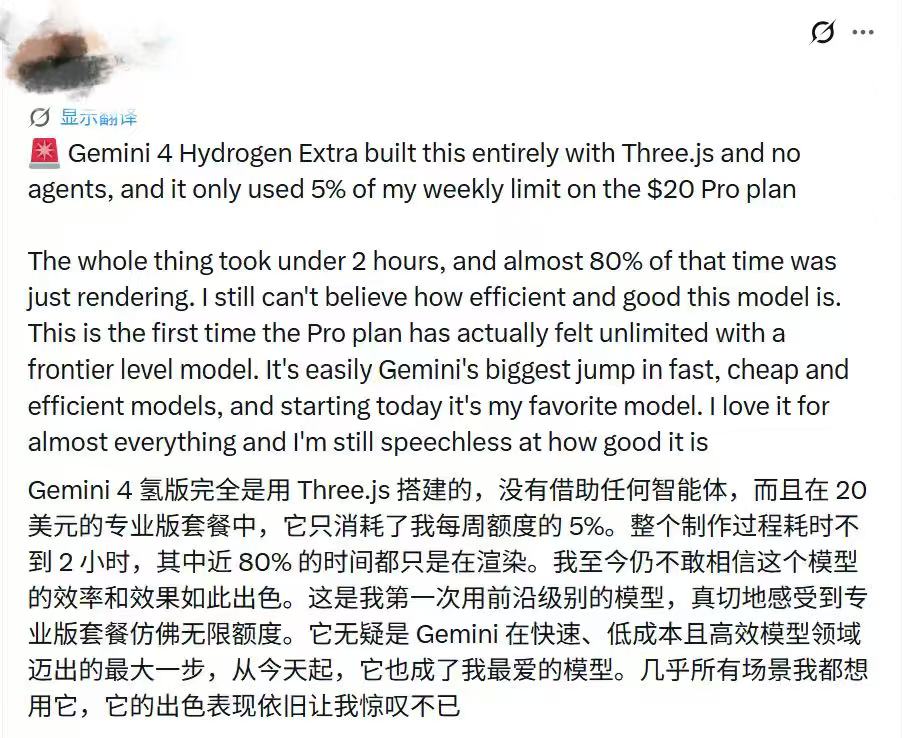
▲5%为网友记录的套餐周额度占比,制作耗时包含渲染时间(图源:X)
这个视频用Hydrogen Extra(xhigh)加Three.js网页3D图形库做成,内容是建筑漫游,连续展示多个室内外空间。主视角从庭院进屋,经过餐桌、壁炉,再转向浴室和阳台;石墙、木梁和家具串起连续空间,窗户、灯具和壁炉附近有明暗变化。

▲建筑漫游(视频来源:X)
二、7项成绩超过Sonnet 5.5,编程、知识工作表现突出
谷歌公布的完整评测表里,Hydrogen与Claude Sonnet 5.5、 GPT-6.1 Terra三款模型同台,覆盖编程、知识工作、计算机操作、多模态理解、科学与数学、推理六类能力,共10项测试。
Hydrogen在代码库测试SWE-sweep、专业工作测试Agents’ Last Exam v1.1、多步骤工作流测试AutomationBench-AA,以及模拟经营、多模态知识工作、图表理解和高难度推理共7项里,成绩都是三款中最高。▲Gemini 4 Hydrogen、Claude Sonnet 5.5与GPT-6.1 Terra评测成绩对比(图源:谷歌)
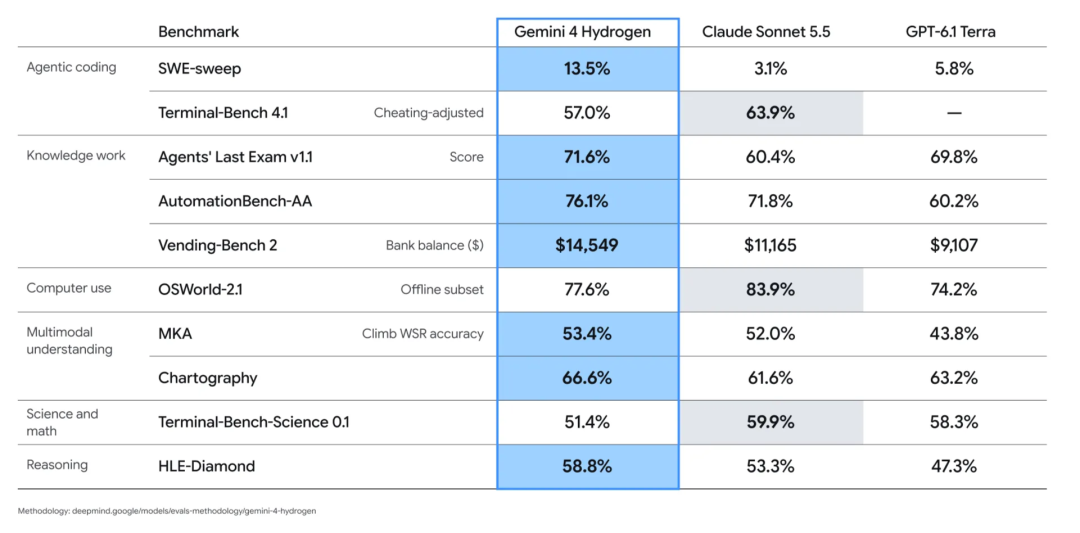
代码修复测试SWE-sweep要求模型发现并修复代码问题,Gemini 4 Hydrogen拿到13.5%,高于Claude Sonnet 5.5的3.1%和GPT-6.1 Terra的5.8%,所报指标为子任务加权得分。谷歌称,Hydrogen能针对问题做局部修改,并行读取文件、搜索代码库,省去逐个检查文件。
终端操作测试Terminal-Bench 4.1中,Gemini 4 Hydrogen为57%,约为Gemini 3.8 Flash成绩18.2%的3.13倍,但仍低于Sonnet的63.9%。
软件操作及工作流方面,专业工作测试Agents’ Last Exam v1.1它得71.6%,高于Claude Sonnet 5.5的60.4%和GPT-6.1 Terra的69.8%;多步骤工作流测试AutomationBench-AA它得76.1%,另外两款分别是71.8%、60.2%。成绩也与思考档位有关:谷歌公布的AutomationBench-AA曲线显示,Gemini 4 Hydrogen从low调到medium档后成绩明显上升,继续提高档位仍有提升,但增幅逐渐缩小,平均任务费用则继续增加。
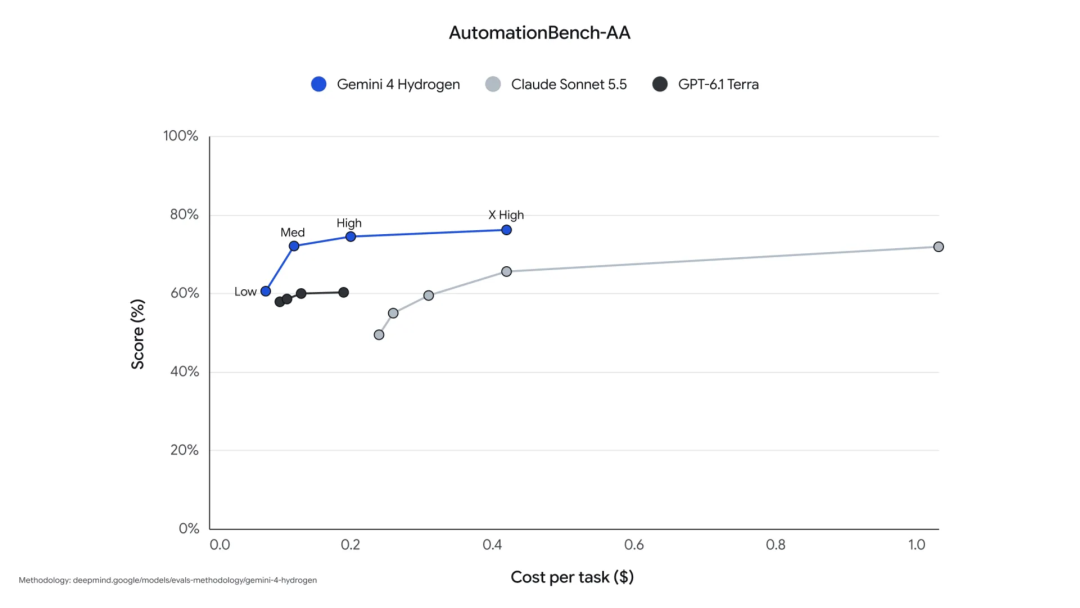
▲不同模型及思考档位的AutomationBench-AA成绩与平均任务费用对比(图源:谷歌)
落到AA综合智能指数评测上,Gemini 4 Hydrogen从high档调到xhigh档后,分数由51分涨到54分,代价是时间与花费同步增加。不过在图示中得分相近的配置里,它的平均任务耗时和费用都比Claude Sonnet 5.5低。
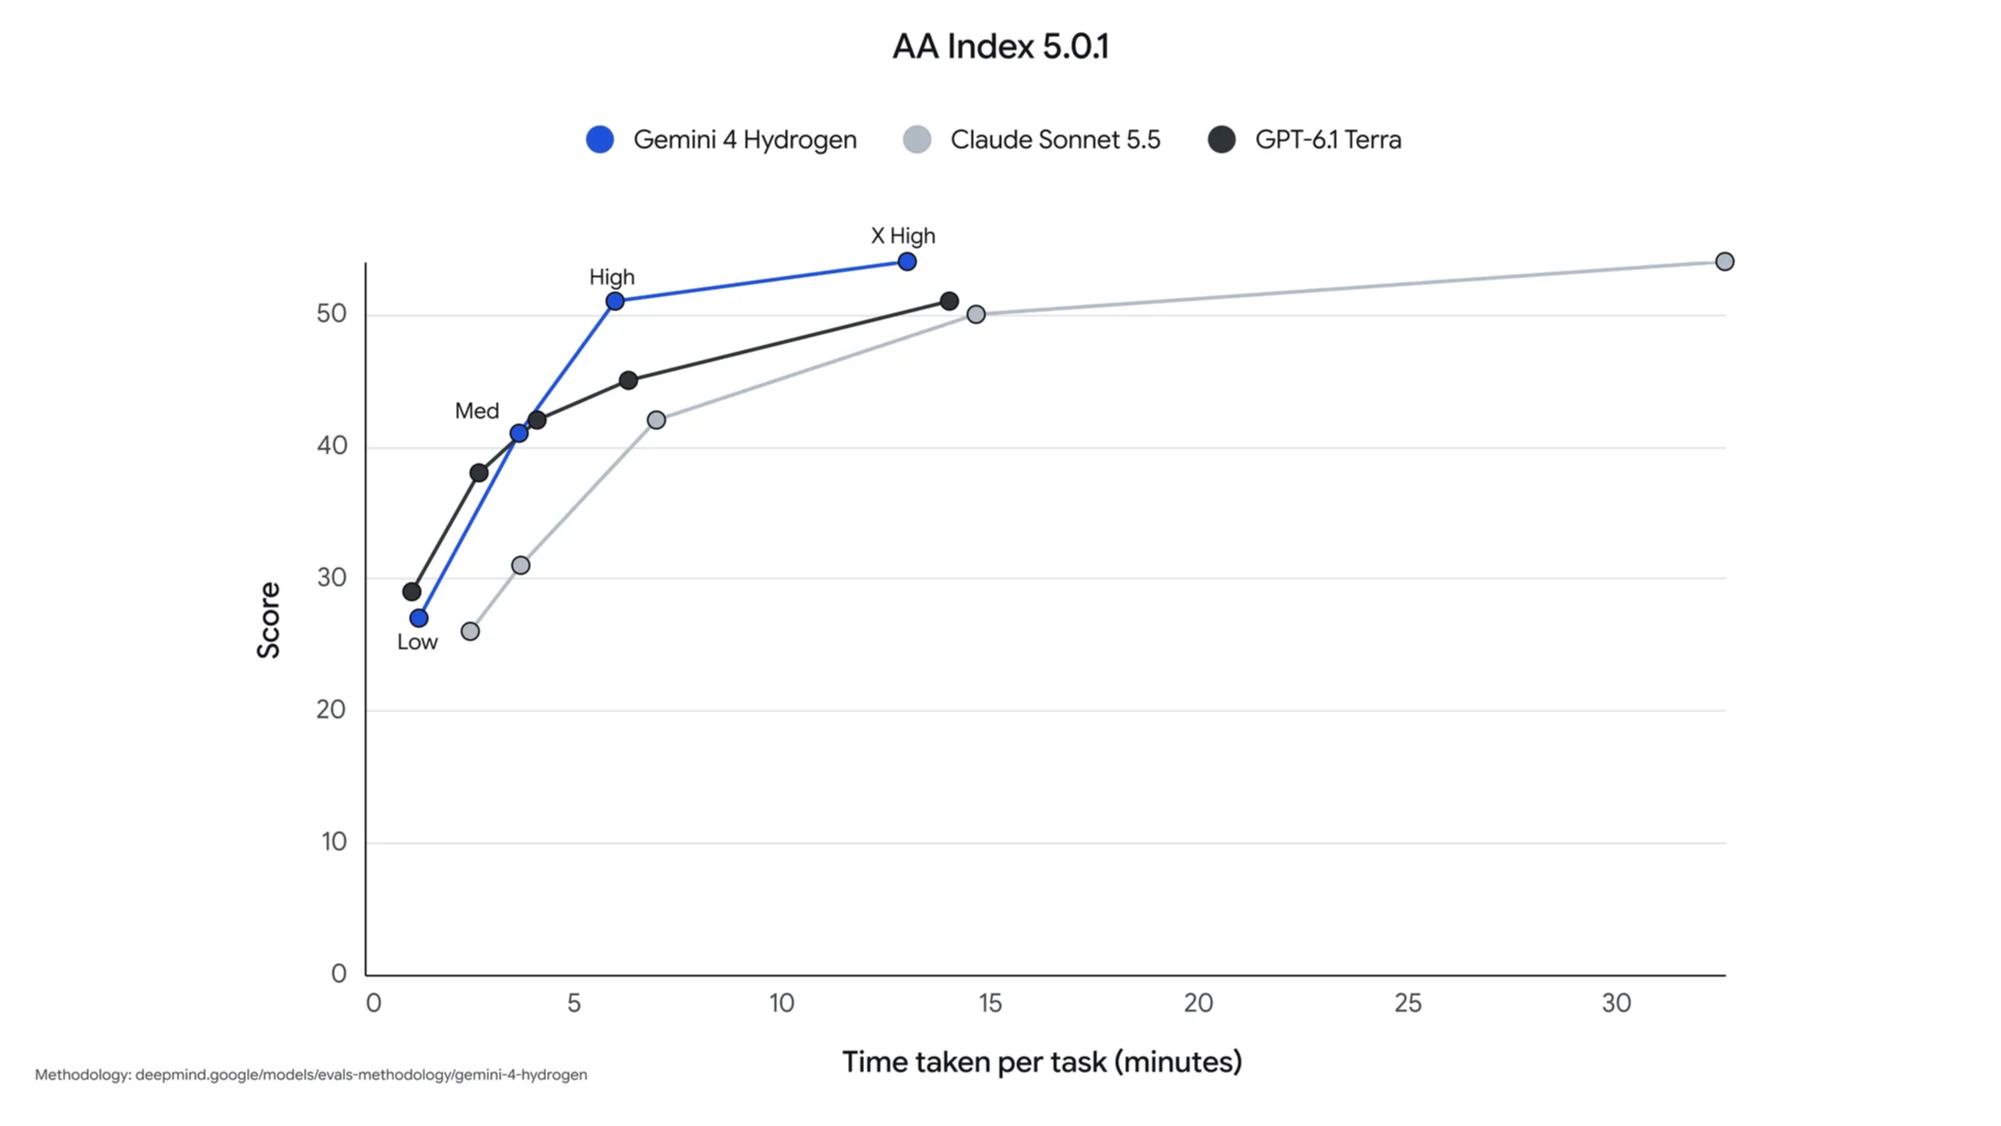
▲不同模型及思考档位的AA综合智能指数得分与平均任务耗时对比(图源:谷歌)
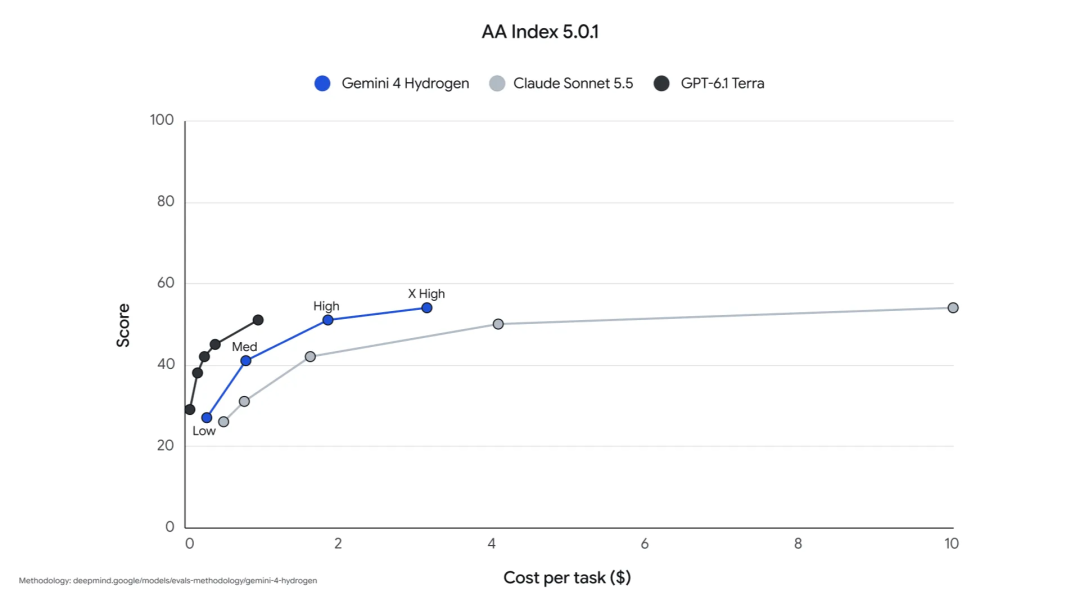
▲不同模型及思考档位的AA综合智能指数得分与平均任务费用对比(图源:谷歌)
使用场景方面,需要读资料、做报告的用户也被纳入了Gemini 4 Hydrogen的考虑范围。谷歌称,这款模型能把PDF、电子表格、图表、音频和录制视频整合起来,产出带引用的报告和结构化成果,输入输出合计约100万Token的上下文额度。多模态知识工作测试MKA考察的正是模型处理复杂视觉文件、完成知识工作的能力,Gemini 4 Hydrogen在这里拿到53.4%,比Claude Sonnet 5.5的52.0%略高,GPT-6.1 Terra则是43.8%。美国企业税务研究测试Tax Agent Bench中,Gemini 4 Hydrogen以52.3%的准确率排在首位。
结语:Hydrogen补齐日常执行,大厂竞逐多模型协作
Gemini 4 Hydrogen体现出日常执行模型的能力在往上走:视觉编程作品能做到比较丰富,多项专业工作评测的成绩也不错。它给Gemini 4家族补上了偏重速度与成本的执行环节,与负责高难度推理的Gemini 4 Carbon、Gemini 4 Argon各有分工。
多模型分工其实已经是大厂产品较量的一部分。Anthropic早在2025年就为Claude Code加入了子智能体模型配置,现在还提供Opus负责规划、Sonnet接手执行的自动切换方式。OpenAI在今年9月底给GPT-6.1 Sol加了多智能体测试功能,支持模型委派子任务;Codex同样允许为子智能体配置模型,让不同模型分别承担执行、探索等工作。
Orchestrator此次上线,把Gemini 4家族的分工接进了同一个会话:旗舰模型分析问题、制定计划,Gemini 4 Hydrogen执行代码修改、测试与验证,碰到困难还能切回旗舰模型。说到底,怎么组合模型、打通工具、用更低的成本把活干完,正成为大厂争夺开发者的重要竞争力。













