

即梦Seedream 5.5对垒MiniMax H3-Image:《持械入宋》复刻实测谁更强
可修改一百次?像素级更改与锁定?秒出壁纸级好图?最近国产图片也开始拿出杀手锏,最典型的就是刚刚撞期发布的即梦 Seedream 5.5 和 MiniMax H3-Image,拿出了不输给GPT 2.5 Image的新图像模型。现在抖音上大火的《持械入宋》已经超过120亿播放,囿于此前的图像模型,整体并没有强调电影级大片
改个上百次会不会崩?能不能做到像素级调整、局部锁定?壁纸级大图能不能秒出?
最近这段时间,国产图像模型也亮出了看家本事。刚刚撞期亮相的 即梦 Seedream 5.5 和 MiniMax H3-Image 就是代表,新模型的表现已经不输 GPT 2.5 Image。
抖音上《持械入宋》眼下播放量已超 120 亿,但之前的图像模型没能拍出电影大片那种质感。于是我们打算拿新模型试几个场景,看能不能复刻出来。
11月9日和10日,字节 Seed 与  MiniMax 前后脚推出 Seedream 5.5 和 MiniMax H3-Image,我们在第一时间做了测试。
按官方说法,Seedream 5.5 改上百次画面也不崩,还能直出透明素材、把画面图层拆开;MiniMax H3-Image 则能在 10 秒内生成 16MP(大于 4K)大图,权重开放,价格也更低。
测试时两边用同一套提示词出图,再比对效果。重点看四项:美学与构图、真实感与细节密度、物理逻辑是否自洽、文字与信息还原,每项配两三组实测案例来说明。
主创团队透露,《持械入宋》的算力投入在 100 万元左右。我们做的是「重生之投你百万复刻」系列,围绕《持械入宋》新出的几张图给两家新模型出了同题,另外更多场景里,两边也走出了不同的风格路线。
第一关:美学与构图
眼下全球图像模型大致分成两派。一派以  GPT Image 为代表,讲究语义遵循,出图准、设计感强;另一派以 Midjourney 为代表,走的是古早美学路子。
国产模型对标的正是 GPT Image 这条线,不过这一代在美学和构图上提升明显。我们拿最近很火的《持械入宋》海报作对比,看看新模型能交出什么答卷。
原图海报
1、电影海报:SD 5.5 略占上风
这次短剧海报的提示词,是我直接让大模型照着原海报转写出来的。细节描述也许不够细,但生成的海报质量超出了预期。
Seedream 5.5 出的这张图,最直观的变化是原海报里那股 AI 味没了,看着更像真人实拍。整体画质和细节更足,远近景的层次也交代得更清楚。
电影海报 · Seedream 5.5 直出(无参考图)
如果给参考图,SD 5.5 出的海报还能再上一层。
电影海报 · Seedream 5.5 直出(有参考图)
MiniMax H3-Image 这张海报曝光过头,人物身上的人工味和油腻感都还在,布局缺少层次,像是全压在一个图层上。要说长处,金色字体的泼粉质感比较抢眼。
电影海报 · MiniMax H3-Image 直出
2、电影CG镜头:同样是 S D 胜出
再看电影 CG 镜头。S D 5.5 的图片逻辑整体说得过去,毛病在于后摇臂、排气、轮毂一放大就糊成一片,机械结构是「意会」出来的,不是真的结构。不过纯文字、不给参考图能有这个水平,已经算可以了。
电影CG镜头 · Seedream 5.5 直出
MiniMax H3 这张图逻辑上没出岔子,摩托车的细节抠得很到位。可整体看更像白天下过雨,天空太亮,跑出了提示词里「雨夜」「大桥」「摩托车」的框子。
还是按这三个方面看,MiniMax 更偏真实。调色、审美、构图差一些,但图本身也算尚可。
电影感CG画面,由MiniMax H3-Image直出。
3、美学摄影:两家难分高下
眼下这些图模生成以假乱真的画面都很拿手,所以这回主要考的是混合色温和体积光这类稍难一点的内容。
我从网上挑了几张喜欢的摄影风格图,把其中的构图、滤镜、光影结构提炼成提示词,输入H3-Image,让它自行生成3张真实摄影作品。
MN H3产出的画面明暗反差强,有局部束光,真实感很足,带着纪实胶片的颗粒感和电影式的人文气息。
左右滑动查看 →
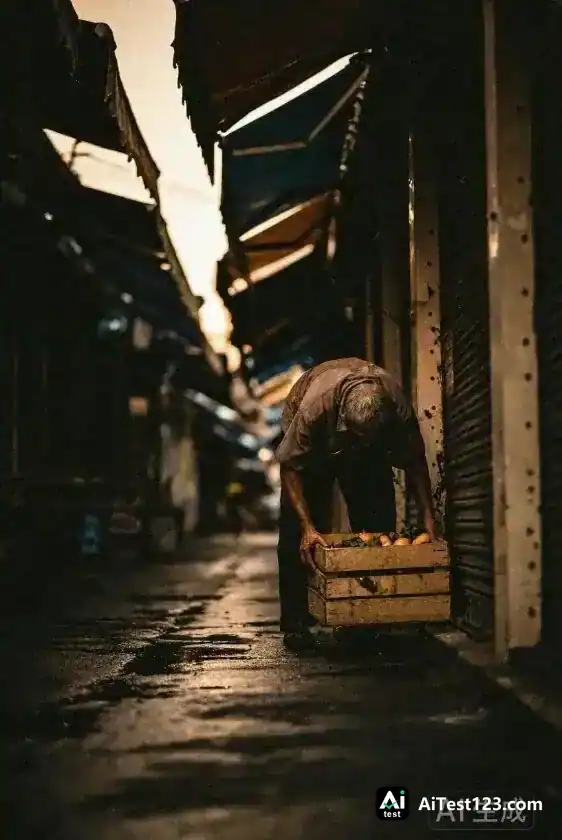
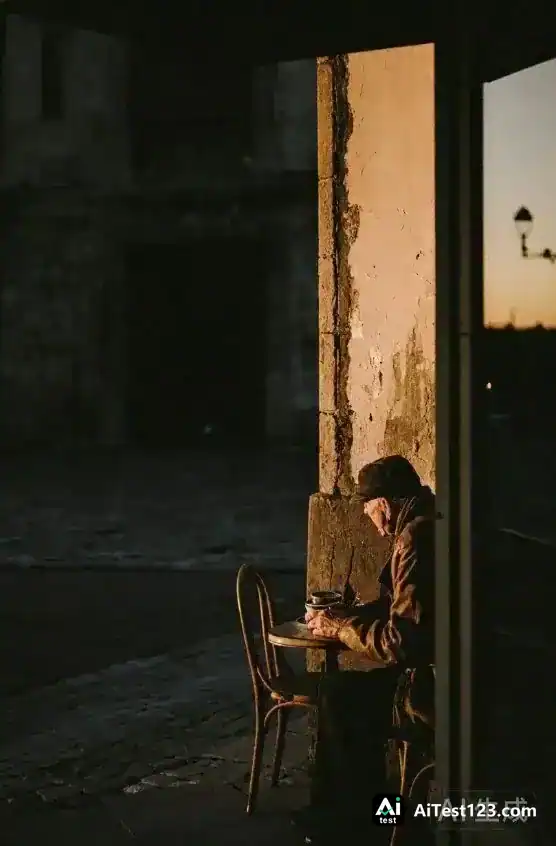
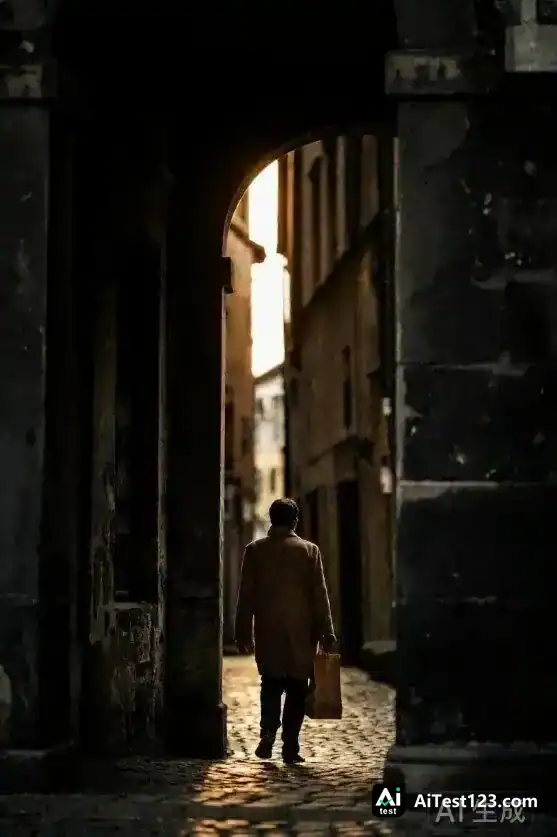
真实摄影,由MiniMax H3-Image直出。
Seedream 5.5这边同样不弱。这张图专门考混合色温与体积光,写实摄影味道足:湿石板路面上同时映出两种色温,过渡自然,水洼里的倒影也不走形,老街的感觉很浓。
混合色温与体积光,由Seedream 5.5直出。
真实感与细节密度:放大之后还剩什么
如今图模要生成一张以假乱真的照片,基本不算难事。于是我们加大了测试强度,用更多物体、更多细节来检验图像能力。
1、五种材质的商品静物考核
这组图对应两家模型各自的升级方向,按五种材质区分,做写实静物。
Seedream 5.5这轮升级重点在光照和材质表现,这张图正好体现出来。玻璃的折射光、液体的聚光都出来了,纤维布和壶身上的水渍这类细节也处理得不错。
构图方面,Seedream 5.5挺有艺术感。小毛病是金属表面的纹理被糊掉了,精修修过了头,磨皮把纹理磨没了。
左右滑动查看 →
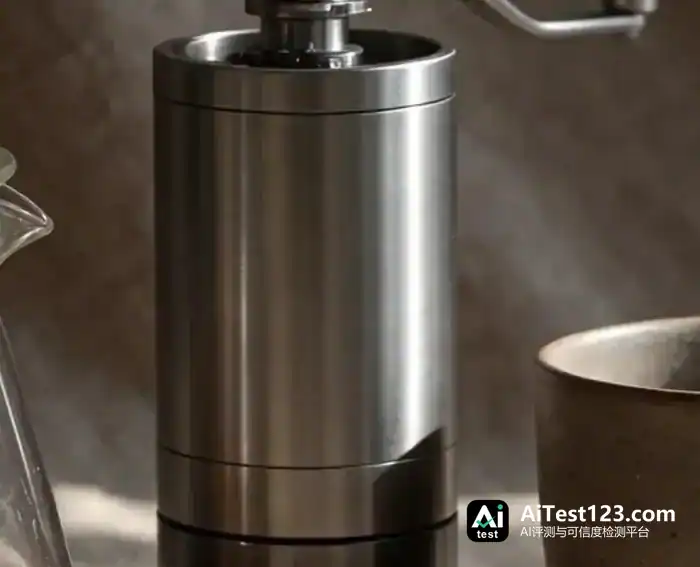
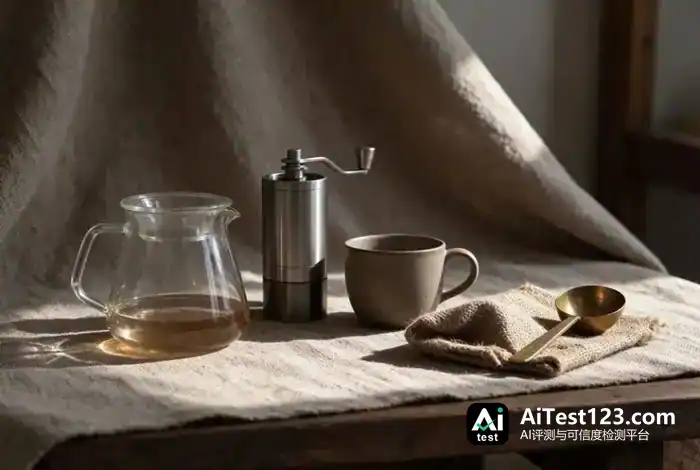
商品静物,由Seedream 5.5直出。
换成同样的提示词,MiniMax H3-Image生成的画面艺术感不强,没有特意设计角度和布景,像把东西随手摆在一块儿拍下的日常照。
不过随机的高频纹理很真:亚麻的毛边、粗陶上的铁点斑、深色木纹、黄铜勺头的揉金反光,放大之后都还在。
光影关系也统一:左上方的硬窗光打进来,陶杯、勺子、罐子在布上的投影一律朝右下,边界硬度一致;杯口椭圆、把手连接、水位透视都正常。
问题出在罐底、陶杯底与麻布之间——接触阴影和压痕都缺了,看着不太自然,物体像是贴在布上;那把黄铜勺也不像日常会有的款式,更接近半成品。
左右滑动查看 →
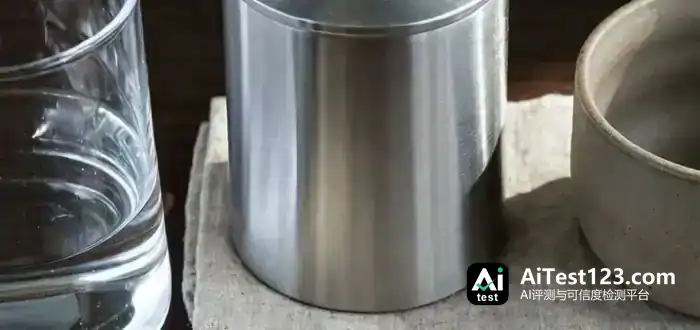
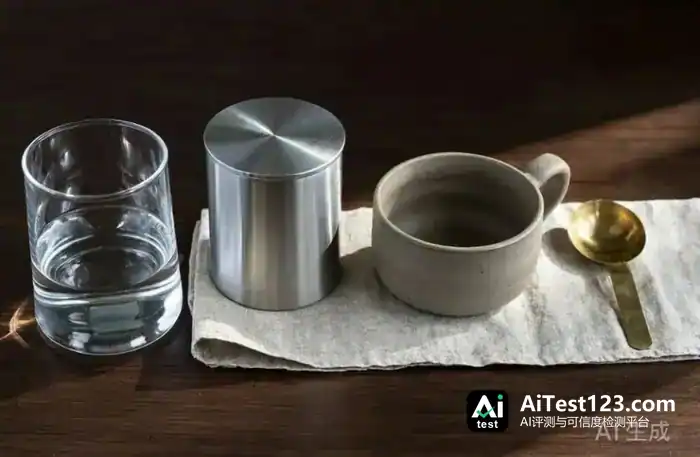
商品静物,由MiniMax H3-Image直出。
2、静物之外的主视觉,两家各有路子
Seedream 5.5 的官方更新文档里,写明的升级点是原生 RGBA 透明素材。也就是说,它可以直接产出带 Alpha 通道的透明或半透明图像,分层输出素材、免抠图、透明艺术字、跨场景复用这些都能做。
我实测下来,这几点确实顶用。让它出 6 个透明素材,除了主体之外都是透明的,分层结果很规整,边缘没出现漏液,轮廓边缘和透明区域都处理得比较细致。
接着拿这 6 个透明素材去拼主视觉宣传,排了四种版式。升级之后,生成的元素能作为独立素材进入后面的设计流程,最后拿到的是可交付的成品。Seedream 5.5 的跨场景复用和可用率都不低。
透明素材拼版主视觉 · Seedream 5.5
原生 RGBA 透明素材 · Seedream 5.5
MiniMax H3 那边主打的是开源模型里最强的指令遵循,最多支持 16 张参考图。我往 H3-Image 里塞了 16 张参考图,色卡、门店、包装、模特、光影片、竞品都有,想一次出主视觉。
结果 H3-Image 返回的图谈不上可交付,甚至算不上好的主视觉。图里很多元素根本没被用进去,多图理解这块,H3-Image 还得再练。
16 张参考图一次出主视觉 · MiniMax H3-Image
3、人物镜头,MN 更真实
MM H3 这次升级强调细节丰富和真实感。它生成的这张真实摄影确实把 H3-Image 的真实感体现出来了,看上去像一张没修过的纪实肖像。
墙上那道裂痕、纱帘的材质和褶皱、屋里的明暗交界,都处理得相当好,很像不经意间按下的快门。
皮肤质感、毛发细腻程度、面部折叠度,还有脸上高光到暗处的过渡、衣服的纤维,都表现得很到位,整张图的像素也更清晰一些。
人物镜头 · MiniMax H3-Image 直出
SD 5.5 用的是同一个提示词。MiniMax H3-Image 那张像随手抓拍,这张则像摄影师布好景拍的片子。
它把 Seedream 5.5 的升级点全对上了:右窗侧逆光、右肩轮廓光,高光往暗处过渡得合理自然,面部有柔光填充,光向自洽,审美几乎挑不出毛病。
皮肤没有蜡感油亮,脸上也没过曝,正好对应官方说的减少油亮过曝;光线逻辑站得住,紫帘褶皱和黄墙的材质关系也成立。
设计是好看,可太完美了反而显得不真:仔细看,人物皮肤上还有纹理和小疙瘩,整体精雕之下皮肤纹路偏少,能嗅出一点 AI 味。
人物镜头 · Seedream 5.5 直出
物理与光学逻辑大比拼
眼下图片模型的实际应用不只在平面设计,游戏设计、3D 设计这些商业场景也在考核范围里,所以这两块我们也分开测了。
1、3D 游戏场景
这次 MiniMax 生成的图,胜在逻辑和细节。霓虹、雨、透明斗篷上淌着整座城市的反光、青色光刃,赛博朋克该有的元素全齐了。游戏视角、UI 设计都在,雨披上的雨点也很细。
不过那些招牌上的字经不起细看,远看像日文,凑近了只是一堆笔画拼出来的假文。
Seedream 生成出来的图更像一张货真价实的游戏截图:左下角是血条,右下角是弹药数,还有个状态小人,画面中间让出一大片湿漉漉的街道,纵深感很足。镜头是平视的,地面脏,积水里有颗粒,还有一团蒸汽。
这些元素都不喧宾夺主,反倒让人相信镜头后头真坐着一个在打游戏的人。
问题出在那把弯刃和右下一直划到腰间的大白弧线上,两者对不上,看着不像是挥砍的轨迹,更像有人在画面上随手补了一笔,逻辑生成这块出了大Bug。
2、光学逻辑与镜像测试
MiniMax 这张图里,镜子里确实出现了反写的「ΓЯ」,说明模型认得镜像字,这一点不容易。可同一组镜中标签里又夹着一个正写的「R7」,一正一反,自相矛盾。壶嘴方向倒是对的,实物朝右,镜中朝左。
画面有柔光,几乎没有影子,物体跟台面接触的地方偏浮;白色几何体、金属壶、红酒的质感都细,留白舒服,色调也高级。
Seedream 这边,前景立方体上的「R7」是正写,镜中两处都是反写的「ΓЯ / 7R」,字形干净,没出现乱码。
文字进了镜子必须左右翻转,这属于超纲难点,它过了。这也对应上官方主打的「复杂字形还原」,以及第三方实测的 19/20 vs 12/20。
图里有一块白色亮窗,台面上落下清晰的硬投影,镜子里也反射到同一块亮窗,光源、影子、镜像三者对得上。
3、多轮编辑
SD 5.5 这次更新号称百次编辑主题细节不丢失,我们测了几轮,细节确实保持得住;GPT image 2.5 每编辑一次噪点就多一层,这方面国产模型占优。
文字与贴图结合
1、外刊报纸与图解小字MN胜
Seedream 官方把文字结构列为核心升级,给出严重文字崩坏率 0.4%、轻微 1.7%,并明确说在“文字结构、文生图真实感”上领先 GPT Image 2.5 Sunburst、Nano Banana 2.1。
要检验一个模型的文字崩坏率,外刊海报和图解小字是更合适的考题。
实测中,SD5.5 生成的这张外刊报纸版式、格局都有设计感和复古味,单词量不少,却没出现崩坏,标点也没乱用错用,文字结构这个核心升级点体现得很充分。
这道题借了 Seedream 官方自己用过的蓝闪蝶图解母题,不过改成纯文生图,图解小字没有崩坏,没有错别字,复杂字形的还原更准。
蓝闪蝶图解这一项,看的是Seedream 5.5直出的效果。
同一个外刊报纸的题目,MiniMax H3-Image走的是做旧路线。报纸做成19世纪风格,文字部分处理得挺机灵——字号往大了做,所以也没崩,只有底部偏小的那圈字母发虚。好处是放大之后够清楚,像素够高。
外刊报纸,MiniMax H3-Image直出。
还是蓝蝶这个案例。图解加小号字,差别一下就出来了:汉字崩坏,有晕化,文字还原不准。不过这次升级本来就没把这块当重点,也说得过去。
有意思的是,放到同样倍数,Seedream 5.5的字没崩但糊了,而MiniMax H3-Image照样清晰。一张图就把两个模型各自的侧重摆出来了。
蓝闪蝶图解,MiniMax H3-Image直出。
2、复杂拼贴:一轮交付的压轴题
这一轮MiniMax完全交不了货。它“分区但不融合”——整张图没有统一光源,元素像剪贴上去平铺着,报纸文字干脆退化成网点噪点。两张照片都归到不可交付。
左右滑动查看 →
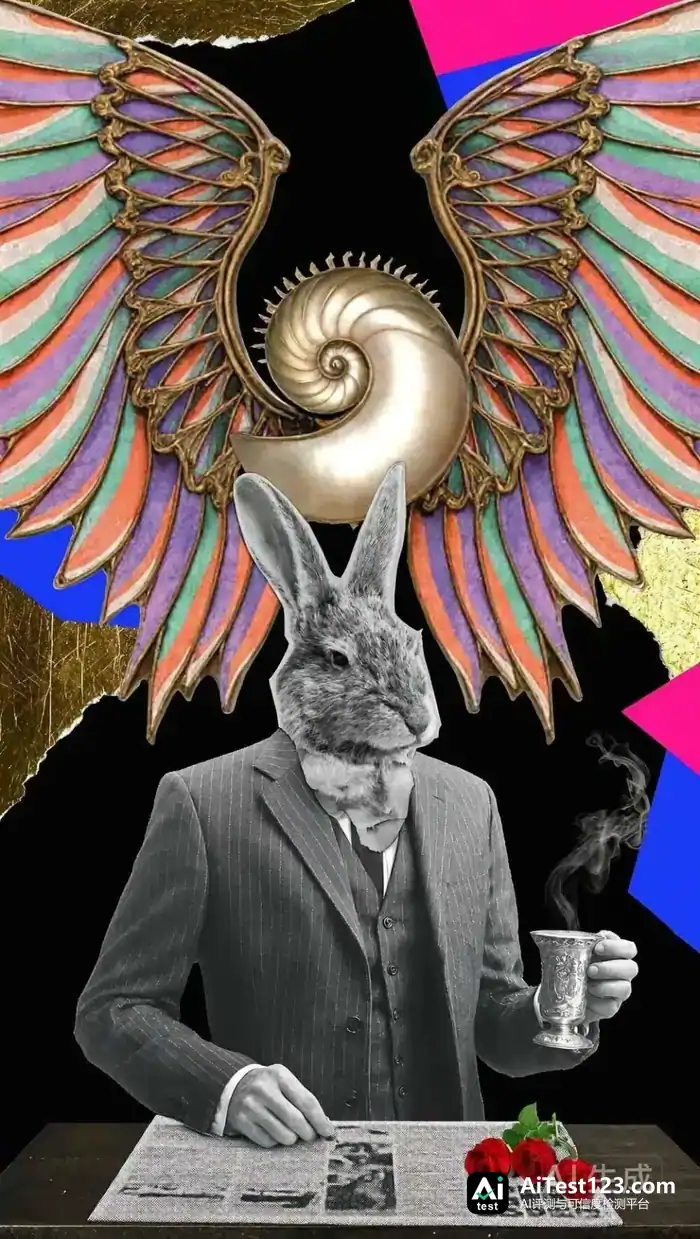
复杂拼贴,MiniMax H3-Image。
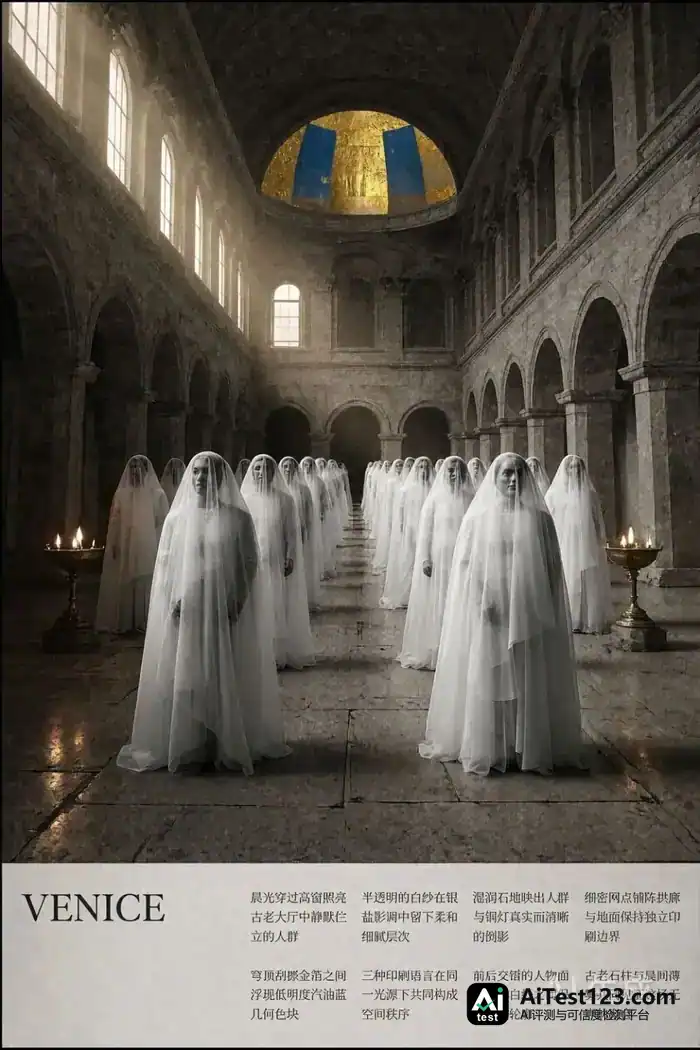
换成Seedream 5.5,我们让它画一座6世纪石造大厅的上层回廊俯瞰,低饱和、暗调电影写实,希腊神话味很足。
复杂拼贴,Seedream 5.5。
这张里元素更多,还添了光环、提灯、圣杯、花瓣、玻璃器。打光统一,有投影,也有前后遮挡;白色蒸汽是半透的,方向合理;金属、金箔、羽翼各是各的质感。
最能说明问题的是报纸标题,“环球周报”四个中文清清楚楚,正文排版整齐,里头的小字还原度也高。拼贴这么复杂,中文还是扛住了。
整张图设计感强,视觉冲击力也够,属于能交付的那类。
复杂拼贴,Seedream 5.5。
世界知识都有进步空间
Nano Banana刚出来那阵,靠世界知识生成任意时刻、任意地点的真实图像,着实轰动过一阵。
照现在看,国产模型在这些地方都还差得不少,生成NBA海报甚至还在胡编乱造。
1、运动镜头都不过关
即梦这张图用的是低机位广角,地板映出人影,标准NBA高光海报的构图,第一眼冲击力明显更足。
毛病出在14号反复出现,人太多了,后面那群人的脸都扭了。
运动镜头,Seedream 5.5直出。
MiniMax 那张图的问题一眼就能看出来:构图和审美都差点意思,人物的排列像一条直线上的点。
更关键的是,两个模型都没有世界知识储备,也索引不到对应的比赛信息。换成 2025 年的 Nano 模型,你指定一场比赛,它能把那场比赛的经典瞬间还原出来。
一旦涉及多人物,MiniMax 的逻辑性和审美就顶不住了。这个水平,够不到 2025 年前沿图像模型的门槛。
运动镜头 · MiniMax H3-Image 直出
2、历史镜头还原不够细节
这张是《持械入宋》的剧照图。这部百亿爽剧,号称涉及的历史文化细节不少。
《持械入宋》原剧照
SD 5.5 生成的图里,敞开的城门、夯土墙体、沿街民居、马匹、货车和来来往往的百姓,都照实还原了。只是站位排得太齐,中间还特意空出一条视觉线。
剧照还原 · Seedream 5.5
军事装备的处理也偏克制。现代士兵的战术背心、枪械、背包跟身体比例更协调,端枪的姿势也更自然。
右侧宋军的甲胄和布衣有明显区别,更接近地方驻军装备可能存在差异的样子。《宋史·兵志》里写着,宋代军队分禁军、厢军、乡兵、蕃兵等不同力量,边境防御并不是全靠装备统一的正规军。
问题也有:画面里的守军没戴兜鍪之类的防护装备,长枪上的红缨也看不出宋代专属的特征。
换成 MM H3 生成的图,军事装备的细节刻画就成了亮点。
剧照还原 · MiniMax H3-Image
左侧三名现代士兵的沙漠迷彩服、战术背心、弹匣袋、护膝和通信设备都比较齐全,可装备显得臃肿,部分枪械的携行方式也不够自然。
右侧宋军穿着札甲、手执长枪,甲片上的铆钉和金属纹理十分清楚。
但对照北宋《武经总要》记载的甲身、披膊、吊腿、兜鍪等防护结构,图中士兵大多用布巾裹头,头颈没有防护,甲胄形制也更像影视剧里常见的通用古装铠甲,看不出宋军装备的时代特征。
建筑这边,夯土城墙、厚重木门、木轮货车和麻袋,把北宋西北边城的氛围搭了出来。《武经总要》对宋代城防里的瓮城、女墙、城壕等设施记载很细,画面里却缺了这些有辨识度的防御结构。
写在最后
本次测试中,SD5.5 主要是在即梦里调用,MM H3 主要走 MiniMax Design。
产品化程度上,即梦确实做得更成熟,这一点占了优势。
可即梦也有几个基础的 bug:每次输入提示词和参考图后,输入框里还留着提示词和参考图,很容易让人以为没提交成功。按理说提交完输入框不该是空的吗?
当然,这次测评的重点还是两个图像模型之间的较量。
四个维度测下来,两个模型的特点已经很清楚:
从这四个维度看下来,Seedream 5.5 的强项在于审美与构图、文字结构以及逻辑自洽,遇到复杂题目时,它更可能一次就交出能用的图。
至于 MiniMax H3-Image,真实感、细节密度、放大后的清晰度是它的优势,另外它还开放权重,价格也更低。
怎么选
说到底,选哪个得看需求:想好看、要带字、想直接放进设计流程,就选 Seedream 5.5;想要真实摄影感、要开源部署,MiniMax H3-Image 更合适。












