港科大(广州)与欧拉万象发布SLA模型:真机任务成功率33.9%

资讯 AI 应用前沿 全文 3391 字 · 约 9 分钟读完 配图 5 张 分类机器人RoboDojo

香港科技大学(广州)与欧拉万象联合推出 SLA 模型,通过在持续预训练中加入空间监督,让机器人在物体移动、桌面升降等动态场景下表现更好。在 RoboDojo-Real 真机榜单中,SLA 以 33.9% 的完整任务成功率位居第一,比 π0.5 高出两倍多。文章拆解了其技术思路:不依赖完美的三维标注,而是用冻结的三维感知

所属频道 机器人与具身智能

当目标被挪走,机器人还能抓得准吗?

设想这样一个画面:机械臂正要抓住桌上的苹果,忽然有人把苹果往旁边推了一下;又或者抓取途中,桌面本身在慢慢升降。传统机器人策略碰上这种场面,往往直接崩掉。原因在于,它们多数是在静态、固定的数据分布里“背题”,现实世界只要稍稍偏离训练时的设定,动作就容易走样甚至失败。
图片

问题也就随之而来:假如把对空间关系的理解真正嵌入机器人基础模型的持续学习过程,它面对现实中的这些变化,能不能表现得更稳?
图片

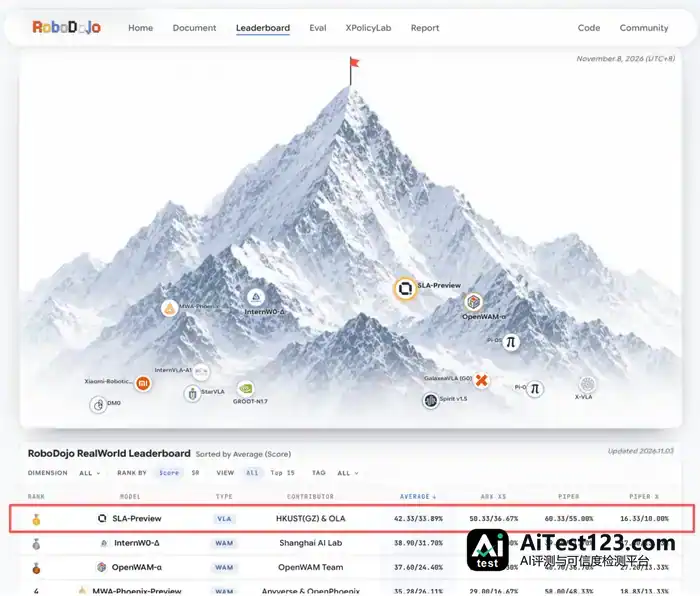
香港科技大学(广州)与欧拉万象(OLA Dimensions)近期联合发布的 SLA(Spatial-Language-Action Model,空间—语言—动作模型),正是奔着这个问题去的。成绩相当直白:在公认的硬骨头 RoboDojo-Real 公开真机评测中,SLA-Preview 平均拿到 42.3 分、完整任务成功率 33.9%,排在榜首。此前的强力基线模型 π0.5 成功率仅有 12.8%。SLA 不只分数更高,成功率还高出 21.1 个百分点,约为 π0.5 的 2.6 倍。

图片

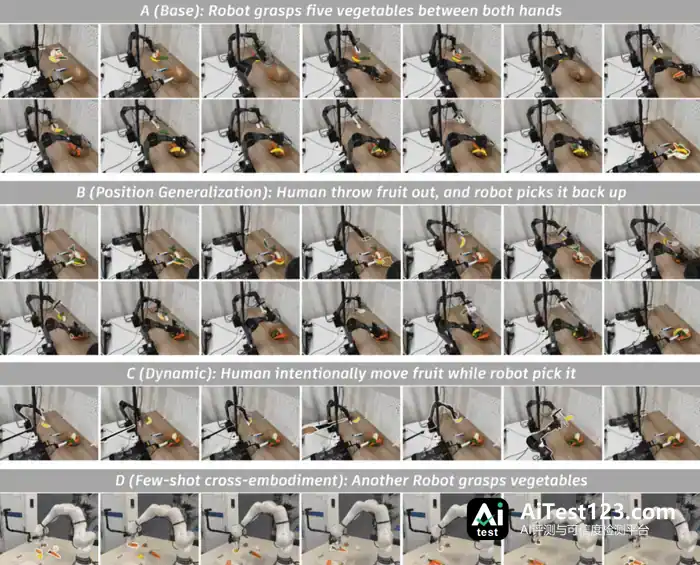
到了动态干扰测试,这个差距被拉得更开。果蔬抓取实验里,物体位置一旦被扰动,SLA 的成功率为 82%,π0.5 只有 52%;目标在移动中受到持续干扰时,两者分别是 76% 和 42%。即便在桌面不断升降、手表高度时刻变化的极端条件下,SLA 仍守住 78% 的成功率,对手则只有 44%。
图片

支撑这些数字的,不是简单堆参数,而是一套重新思考“机器人如何理解空间”的路线。
图片

为什么现有的 VLA 模型搞不定动态场景?

眼下的视觉—语言—动作模型(VLA)已经相当能打。它们接过了大规模视觉语言模型的知识,既能听懂指令,也能看懂图像里的物体。认出“这是一个杯子”,对它们来说轻而易举。

可“认出杯子”跟“把夹爪准确移到杯子旁边并抓起来”之间,横着一道巨大的鸿沟。后者要处理距离、朝向、遮挡关系,还有夹爪运动轨迹之间的复杂几何约束。物体位置偏了一厘米,接近路径可能就得整个重写;抓取角度变了一点,手腕朝向也要跟着调。

过去对付这个问题,常见做法是在后训练(Post-training)阶段引入深度图、点云这类几何信息。听着合理,现实却不太给面子:真实机器人数据往往参差不齐。有的带深度信息,有的没有;相机标定状态各不一样;大量公开示范数据甚至只有 RGB 图像,深度图直接缺失。

倘若空间学习非得依赖整齐完整的三维标注,那海量异构机器人数据就只能闲着。SLA 换了个走法:不把几何数据直接喂给策略网络,而是在训练期间将空间信息“对齐”进 VLA 自身的中间视觉表征。

展开来说,SLA 继承并扩展了 π0.5 的架构。它请来一个冻结的三维感知模型 OmniVGGT 当“空间老师”。这位老师读取多视角 RGB 图像,借助样本中已有的深度或相机标定信息,提取高质量空间特征。另一边,VLA 模型学习预测动作时,会被要求让自身的中间视觉特征去模仿、对齐这位“老师”的空间特征。

空间监督就这样悄无声息地进入了动作生成所依赖的表征层。模型学“怎么动”的同时,也把“在哪里”一并学了进去。

针对不同场景、纹理和相机视角,SLA 还会对多个层次的视觉特征做自适应汇聚。消融实验的结果是:这套多层自适应融合方案在 RoboTwin 的 Clean2Random 设置下拿到 72.3% 的成功率,比最优的固定单层方案高 5 个百分点。

另有一个细节:训练期间,系统会按一定概率随机丢弃部分样本的机器人状态输入。做法看着有点自虐,目的却是逼策略更多依赖当前图像信息,而不是死记示范轨迹里那些固定状态模式。真正部署时,庞大的“空间老师”、对齐投影器和选层门控都会被拿掉。也就是说,推理阶段既不需要额外的深度或相机标定输入,也不增加计算负担。空间能力已经内化进模型权重。

六类数据大杂烩,怎么统一“动作语言”?

空间对齐的方法有了,接下来是数据规模。SLA 想证明空间理解能像语言能力那样,靠海量数据持续预训练获得。

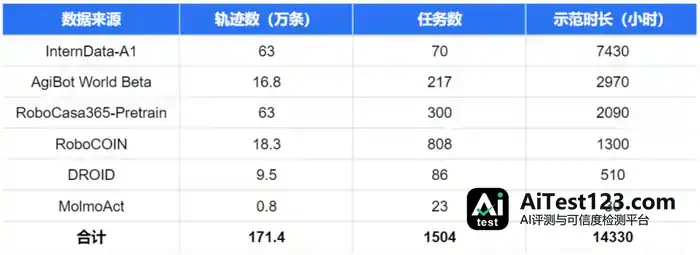
团队把 InternData-A1、AgiBotWorld-Beta、RoboCasa365-Pretrain、RoboCOIN、DROID 和 MolmoAct 六类来源的数据汇到一起。这些数据集覆盖真实环境与仿真环境,单臂、双臂机器人都有。筛选之前,总量约为 171 万条轨迹、14,330 小时的示范。

可这么多数据直接一股脑扔进模型训练,行不通。不同品牌的机械臂,关节数量和排列方式完全两样。同一组关节数值,放到不同机器人身上,物理含义差得远。不加处理直接混合,模型学到的很可能是一团乱麻。

SLA 的办法是统一“动作的物理含义”。团队用末端执行器位姿来描述状态和动作,并统一坐标系约定:单臂以臂基座为原点,双臂以两臂基座中点为原点,坐标轴统一指向前、左、上。这样一来,不管底层硬件是什么,移动方向、旋转和夹爪动作都有了可比较的标准。

旋转表示同样是个坑。直接拿欧拉角相减,在角度环绕边界容易冒出离群值。SLA 改用 SO(3) 复合求相对旋转,再以旋转向量表示,配合逐通道归一化,把这个问题解决掉。

另外,仿真数据里大量重复轨迹,团队做了下采样和异常过滤。关键在于,持续预训练阶段,他们刻意没有碰后训练用到的特定数据集,以免下游评测出现数据泄漏风险。

这一阶段预训练动用了 48 张 NVIDIA H100 GPU,跑了大约 110 小时。这笔算力投入,换回一个具备通用空间表征的基础模型。

数据越多,空间能力越强吗?

空间理解若真能算作基础能力,就应当遵循 Scaling Law(缩放定律)——喂的数据越多,本事越强。

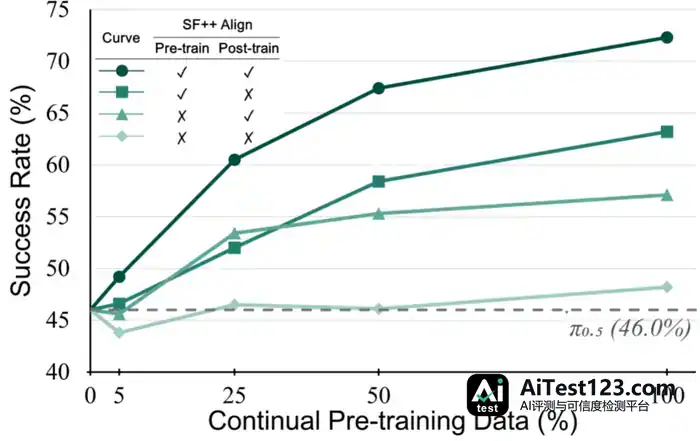
为验证这一点,研究者设计了一组对照实验:先从混合数据集里按任务抽样,再分别以 5%、25%、50% 和 100% 的数据量做持续预训练。与此同时,两个变量被严格控制住:持续预训练阶段用不用空间对齐,后训练阶段用不用空间对齐。

答案相当明确。两个阶段都上空间对齐时,成功率随数据规模一路走高:49.2%、60.5%、67.4%,全量数据下最终落在 72.3%。无论处在哪一档数据规模,这种“双阶段对齐”的组合都压过另外三种设置——只在预训练对齐、只在后训练对齐、两处都不对齐。

具体看全量数据这一档:仅预训练阶段对齐,成功率为 63.2%;仅后训练阶段对齐,是 57.1%;两个阶段都不做,只有 48.2%。这组数字支撑了 SLA 的核心主张——空间表征可以先在广泛的机器人经验中借助持续预训练习得,随后在下游具体任务适配时得到进一步强化。

SLA 的表现不限于 RoboDojo-Real。RoboTwin 2.0 的 50 个任务里,它的平均成功率达到 79.2%,随机化场景(Clean2Random)下比 π0.5 高出 26.3 个百分点;RoboCasa-Panda 的 24 个厨房任务中,平均成功率为 68.4%;到了 LIBERO-Plus,面对相机、光照、背景等多重扰动,加权成功率也有 87.4%。

这些数字当然没法捏成一个通用的“无敌指数”。各评测集各有侧重,有的考长程操作,有的考抗干扰。但趋势摆在那里:加了空间监督,模型遇上未知变化确实更沉得住气。

局限与未来:还没到终点

成绩好看,SLA 却并非万能药。研究团队自己就点出了短板:任务不同、本体不同,差异依然明显。眼下的验证集中在特定的抓取和放置任务上,更复杂的长程操作、开放世界任务,以及规模更大的真实部署,都还需要时间检验。

SLA 的价值在于趟出了一条可走的路:承接现有 VLA 模型强大的语义能力,再用持续预训练和空间对齐,把机器人的空间几何直觉一点点培养起来。原本“空间能力怎么形成、怎么随经验扩展”是个黑盒问题,如今变成了能逐项测试、逐项优化的工程问题。

盯着具身智能的人,这个方向值得持续关注。说到底,机器人终究要在混乱、动态的物理世界里干活,只会“聊天”远远不够,还得会“看路”、会“动手”。

相关资源:

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 港科广与欧拉万象推出SLA:RoboDojo真机榜平均得分42.3分登顶

    把空间理解放进基础模型的持续学习过程,机器人能否更好地应对现实中的变化?机器人伸手抓取果蔬时,有人把目标挪走了。原本放好的物体,又被扔回桌面。另一组实验里,桌面不断升降,夹爪需要跟上目标的高度变化。同样是抓取和放置,空间关系一变,已经学过的技能还能不能继续用?图 1 SLA 真机操作视频香港科技大学(广州)与欧拉万象(

    来源 腾讯网
  2. 灵光连接器增至47项:接入微信ClawBot、QQ机器人等六大服务

    11月12日,灵光开放生态再次扩容,新增支持微信 ClawBot、QQ机器人、瑞幸咖啡、有道云笔记、滴答清单、腾讯新闻等六大连接器。连接器拓宽了灵光的能力边界,此次扩容让灵光的服务覆盖即时通讯、知识管理、任务协同等高频场景,外部连接服务增加到47项。 本次生态扩容后,灵光通过微信 ClawBot 和QQ机器人连接器,打

    来源 AI 开发者社区
  3. 蚂蚁灵波开源触觉模型LingBot-Touch:三类传感器统一成触觉Token

    这两天,Claude Fable 5.2的消息大家都看到了,真机演示了拧瓶盖、解魔方、画画等任务,一气呵成,直接把双臂泛化成功率拉到64.9%,是Astra的两倍还高。 同一时间,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,把磁触觉、视触觉、压阻式三类完全不同的传感器信号统一成同一套“触觉Token”,供不

    来源 AI 行业观察
  4. 灵光连接器扩至47项:接入微信ClawBot、QQ机器人、瑞幸咖啡等

    11月12日,灵光开放生态再次扩容,新增支持微信 ClawBot、QQ机器人、瑞幸咖啡、有道云笔记、滴答清单、腾讯新闻等六大连接器。连接器拓宽了灵光的能力边界,此次扩容让灵光的服务覆盖即时通讯、知识管理、任务协同等高频场景,外部连接服务增加到47项。 本次生态扩容后,灵光通过微信 ClawBot 和QQ机器人连接器,打

    来源 AI 行业观察
  5. AMD Ross Agentic AI Assistant:MCP协议直连Vivado,告别Tcl门槛?

    AMD在2026年推出了Ross,一个基于MCP协议的FPGA开发AI助手。它不是简单的聊天机器人,而是能直接调用Vivado执行Tcl脚本、检索官方文档并分析时序报告的智能体。本文梳理了Ross的四大核心组件,对比了VS Code插件与独立MCP Server两种部署路线,并详细记录了在WorkBuddy中配置本地M

    来源 AI 应用前沿
  6. OpenCode四Skills工作流:从需求到代码,AI开发如何变得可控

    本文介绍如何利用 OpenCode 的 Skills 机制,通过“毒蛇产品经理”、“UI 提示词生成”、“UI/UX 设计智能”和“全栈开发”四个模块化技能,构建自动化的 AI 开发工作流。以音乐机器人项目为例,展示如何从模糊想法快速落地为高质量代码,解决 AI 编程中常见的上下文丢失和 UI 塑料感问题。

    来源 AI 应用前沿
  7. Microduck机器人实测:用OpenAI模型教它走路,还能追猫

    一只巴掌大的塑料鸭子,在客厅里摇摇摆摆地追着我的猫跑。借助一个 OpenAI 模型,我教会了这台叫 Microduck 的小机器人走路,甚至让它兼职当了一回“猫咪管家”。这场家庭实验让我意识到:教机器人做事的方式,正在从写代码变成说话,而真正的机器人革命,或许会从最不起眼的玩具开始。

    来源 AI 科技快讯
  8. 北京:建立具身智能机器人企业上市“一对一”服务机制,培育优势龙头企业

    IT之家 11 月 11 日消息,为加快推动北京市具身智能机器人产业高质量发展,北京市经济和信息化局今日印发《北京市具身智能机器人产业高质量发展行动方案(2026-2028 年)》。 IT之家注意到,该《行动方案》提到建立具身智能机器人企业上市“一对一”服务机制,培育优势龙头企业。在整机、关键零部件、具身智能模型和数据

    来源 AI 行业观察
  9. 连文昭回国创业:源络机器人进实验室,自主科研闭环还有多远?

    2023 年,连文昭决定离开硅谷,回国创业。这个决定背后,是他在机器人领域十多年的积累。连文昭曾先后在 Vicarious 从事通用人工智能研究、在 Google X 任资深研究科学家、在 Figure AI 任技术总监,并是 Figure AI 的初创成员之一。经历了从通用人工智能探索到机器人模型、软硬件协同的不同阶

    来源 腾讯网
  10. 杰克科技人形机器人“艾妮”进厂:裁片抓取不超3秒,缝纫仍靠缝纫机

    (本文作者为 具身志,钛媒体经授权发布)文 | 具身志10月29日,江苏昆山晨风时尚产业园的一场人机协同缝纫大赛上,人形机器人“艾妮”展示了一项看起来简单的本事:从布料中准确抓取单张裁片。对于熟练工人,这不过是每天重复无数次的操作。但服装面料又软又薄,有时两层布会粘在一起,有时刚刚摆正,又发生了褶皱和偏移。...

    来源 腾讯网
  11. OpenAI模型驱动Microduck:几十美元玩具学会追猫

    一只巴掌大的塑料鸭子,在客厅里摇摇摆摆地追着我的猫跑。借助一个 OpenAI 模型,我教会了这台叫 Microduck 的小机器人走路,甚至让它兼职当了一回“猫咪管家”。这场家庭实验让我意识到:教机器人做事的方式,正在从写代码变成说话,而真正的机器人革命,或许会从最不起眼的玩具开始。

    来源 AI 行业观察
  12. 李飞飞Atlas亮相CoRL:AMD 82亿美元收购押注了什么

    2026年11月11日,李飞飞在奥斯汀机器人学习大会(CoRL 2026)发表主题演讲,正式展示Atlas世界模型,并与AMD CEO苏姿丰完成收购后首次公开同台。Atlas被定义为统一像素生成与三维场景重建的自回归帧生成模型,核心价值在于为机器人训练提供合成环境。AMD以82亿美元全股票收购World Labs的交易

    来源 AI 科技快讯
  13. 李飞飞Atlas亮相CoRL:AMD 82亿美元收购World Labs押注什么

    2026年11月11日,李飞飞在奥斯汀机器人学习大会(CoRL 2026)发表主题演讲,正式展示Atlas世界模型,并与AMD CEO苏姿丰完成收购后首次公开同台。Atlas被定义为统一像素生成与三维场景重建的自回归帧生成模型,核心价值在于为机器人训练提供合成环境。AMD以82亿美元全股票收购World Labs的交易

    来源 AI 行业观察
  14. xAI遭多起集体诉讼:Grok被指生成非自愿色情图像,涉未成年人

    人工智能技术的迅猛发展在带来生产力飞跃的同时,也正在将整个行业拖入复杂的法律与伦理泥潭。近日,埃隆·马斯克(Elon Musk)旗下的人工智能公司 xAI 正在美国多地遭遇多起集体诉讼。多名年轻受害者指控称,xAI 旗下的聊天机器人 Grok 被滥用并用于生成她们的非自愿色情图像,其中甚至涉及未成年人。 从初中毕业照到

    来源 AI 开发者社区
  15. 软银领投Agile Robots 5亿美元融资,人形机器人2026年拟产2000台

    Agile Robots 本轮融资 5 亿美元,由软银集团领投,英伟达、日立等跟投,累计融资已约 20 亿美元。公司计划借助新资金扩大美国等市场业务,并在慕尼黑启用的人形机器人工厂预计 2026 年生产约 2000 台。CEO 陈兆芃称人形机器人效率超越人类的转折点越来越近。#机器人# #人形机器人#

    来源 IT之家
  16. 李飞飞苏姿丰对话:机器人如何成算力新引擎?

    在CoRL 2026机器人学习大会上,AMD董事长兼CEO苏姿丰与World Labs创始人李飞飞对话。苏姿丰表示AMD已组建机器人研究团队,布局仍处早期,并预计未来几年物理AI尤其是机器人市场可能达数千亿美元。双方还讨论了模型路线、算力需求及向公共部门开放算力。

    来源 凤凰科技
  17. 豆包工作上线Kimi 3.1 Pro等模型:限时额度优惠怎么用?

    为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。在简单小额任务免费的基础上,豆包工作将推出全新限时优惠活动。此外,豆包工作已针对豆包 2.1 Lite和Deepseek V4

    来源 TechWeb
  18. 豆包工作接入Kimi 3.1 Pro等模型:新增额度倍率标注,推出限时优惠

    为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。在简单小额任务免费的基础上,豆包工作将推出全新限时优惠活动。此外,豆包工作已针对豆包 2.1 Lite和Deepseek V4

    来源 TechWeb
向下滚动自动加载更多






