Claude Opus 5.5领跑WorkflowArena:长程任务完全解决率仅36.95%
Einsia AI发布WorkflowArena基准,评测大模型在软件工程、法律等领域的多智能体编排能力。结果显示,即便最强的Claude Opus 5.5,面对复杂长程任务的完全解决率也不足37%。研究还发现,擅长执行任务的模型未必擅长编排,而优秀的编排策略能让弱模型性能显著提升。不同模型呈现出“谋定后动”与“小步快
从单兵作战到团队指挥
以往聊起大模型,大家盯的多是它单枪匹马能写出多漂亮的代码、画出多精美的图。 Claude Code、Codex 这类框架冒出来之后,规则就变了。模型不再只是闷头干活的“执行者”,它们已经能在运行时拉起子智能体、自己写调度脚本。

任务怎么拆、上下文怎么分、中间结果在哪儿校验——这些原本由工程师硬编码进多智能体系统的逻辑,如今交给模型临场拍板。
变化随之带来一个问题:碰上真实的、环环相扣的长程任务,大模型究竟能不能把这一群智能体组织好?
现有评测多数只盯最终结果成不成,或者干脆在预设好的协作结构里测模型。核心难点被绕开了:要是连“怎么分工”都得模型自己想,它还搞得定吗?
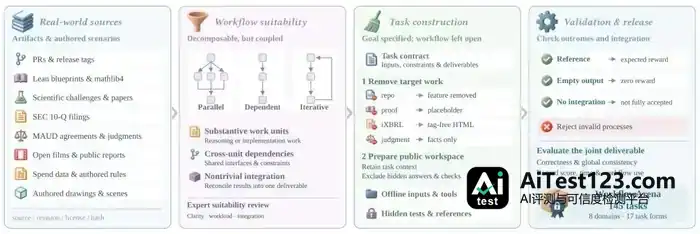
针对这一点,Einsia AI 旗下的 Navers Lab 推出了 WorkflowArena,一个专测大模型多智能体编排能力的基准。它收录 145 项长程任务,覆盖软件工程、企业运营、科学研究、数学推导、金融、法律、内容设计与 3D 制作 8 大专业领域,并对 9 个主流前沿模型的 25 种推理配置做了全面测试。
不规定路径,只看交付结果
设计思路很直接:不给模型任何预设的工作流模板。
每道题都是一份真实的专业交付物。有的要求改一个开源代码库并通过回归测试,有的要复现一项科学实验结果,还有完成一套 Lean 形式化证明、编制一份涉及多个主体的合并报表、分析一起有多名被告的案件,或者在 Blender 里照图纸搭出一座完整的建筑群。
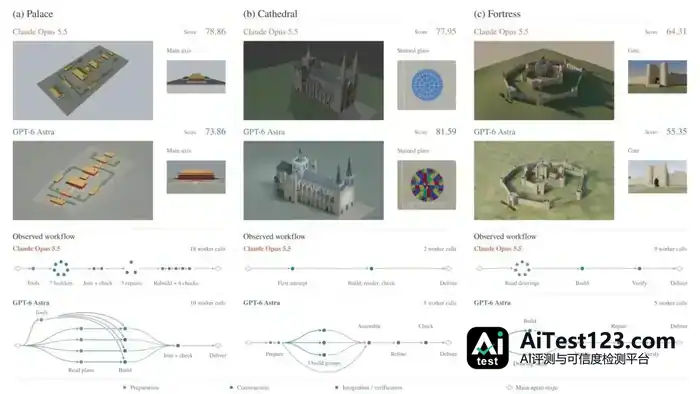
这些任务都强耦合:代码改动不能只动一处,财务数据得在不同主体间对账,法律结论要在多份文书里保持逻辑一致,3D 场景的各部件要严丝合缝。单独做对某一块没意义,整合起来通过验收才算成功。
评测时,模型拿到的是一个空白的“指挥台”。
- 自主决策:分工不分、怎么分,模型自己定。它可以亲自上手,也能通过 Workflow 工具调度多个子智能体;每个子智能体该知道哪些信息,全由主模型交代。
- 共享预算:主智能体和所有子智能体共用同一份推理预算,规划、调度、返工烧掉的 Token 都算在里面。模型因此必须在“想得周全”和“控住成本”之间做取舍。
- 黑盒判题:判题器和标准答案对模型不可见,评分只看最终交付结果,跟用了多少子智能体、调了多少次工具无关。不过每一次调度记录都会完整留存,供后续分析。
这样的设置让 WorkflowArena 不只能回答“做得怎么样”,还能看出“是怎么组织起来做的”。
没有全能选手,最强者也仅及格
评测采用严格的“完全解决率指标”:交付物满足全部验收标准才算真正解决,各部分都做对但整合失败的提交一律判失败。
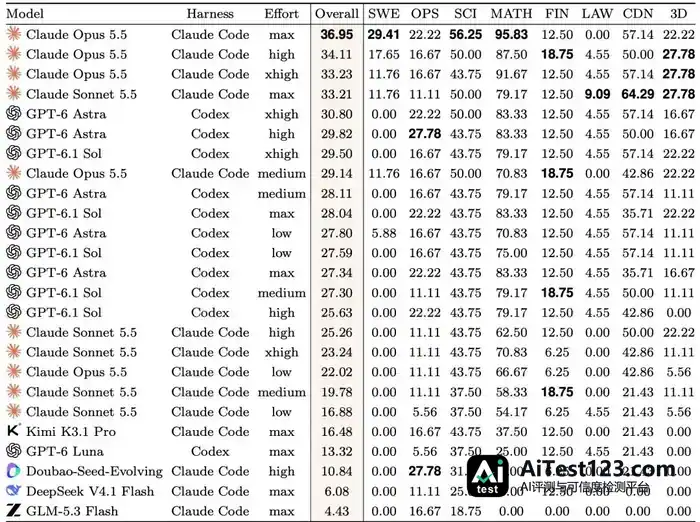
结果有些令人清醒:榜首的 Claude  Opus 5.5(max)平均完全解决率只有 36.95%。
换句话说,即便是当前最强的系统,面对这些复杂长程任务,也有超过六成的概率没法完整交付。通吃所有领域的系统,一个都没有。
领域之间的差距也很大。
- 形式化数学已接近饱和,Claude Opus 5.5 解决了 95.83% 的任务。
- 软件工程最高只有 29.41%。
- 金融最高 18.75%。
- 法律最高仅 9.09%。
Claude Opus 5.5 在软件工程、科学与数学三项上排在最前,Claude Sonnet 5.5 则在法律和内容设计上更占优,GPT-6 Astra 与 Doubao-Seed-Evolving 在企业运营任务里并列第一。不同模型在不同领域互有胜负。
通用能力行不行,和具体领域里的编排能力强不强,并不是一回事。法律任务要面对大量非结构化文本之间的逻辑冲突,眼下的模型处理起来仍然吃力。
两种截然不同的编排哲学
WorkflowArena 把每一次调度细节都记了下来,各模型在“怎么把多智能体组织起来”上的风格差异因此看得相当清楚。
数据里呈现出两种很不一样的流派:
1. Claude 系:“谋定后动”
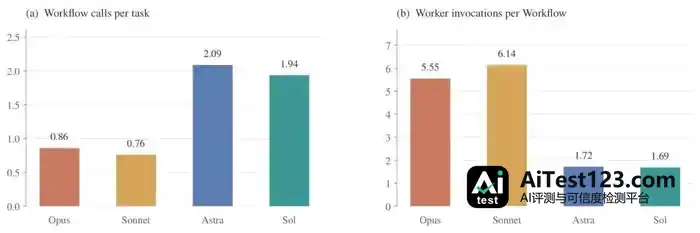
Claude Opus 5.5 和 Claude Sonnet 5.5 走的是调用次数少、单次规模大的路子。两者平均每题分别只调用 0.86 次和 0.76 次 Workflow,可每次平均调度 5.55 个和 6.14 个子智能体。Sonnet 那边有 30% 的工作流涉及 9 个以上子智能体。
这套做法好比开工前先开一场详尽的项目会,角色全部安排妥当,再分头行动。
2. GPT 系:“小步快跑”
GPT-6 Astra 和 GPT-6.1 Sol 正好反过来。它们平均每题调用 Workflow 2.09 次和 1.94 次,频率更高,但每次只调度 1.72 个和 1.69 个子智能体,约 99% 的工作流子节点不超过 4 个。
这更像敏捷开发,边做边看,碰上问题再临时拉人帮忙。
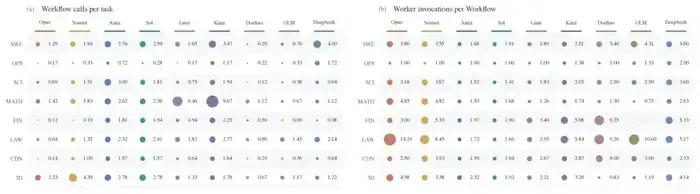
风格差异还会随任务领域上下浮动。法律任务里,Claude Opus 5.5 每个工作流平均调度 14.29 个子智能体,想一口气把所有关系理清;GPT-6 Astra 只有 1.73 个,更靠串行推进。到了数学任务,Kimi K3.1 Pro 每题调用 Workflow 达 9.67 次,每次却只调度 1.74 个子智能体,迭代频率极高。
调用勤,不等于协作摊子大;摊子大,也未必效率就高。真正要紧的是哪种方式跟任务本身的结构更合拍。
会做题不代表会带队
有个发现挺有意思:自己本事大,未必带得好团队。
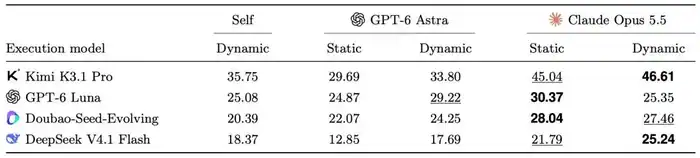
研究团队做了个迁移实验:执行模型固定(比如 Kimi K3.1 Pro、DeepSeek V4.1 Flash 等),只换负责写工作流的“编排者”(Claude Opus 5.5 或 GPT-6 Astra)。编排者不能直接改文件,只能下指令。
结果有些出人意料:
- Opus 编排出来的工作流,让所有执行模型都变强了。Kimi K3.1 Pro 在 Opus 编排下得分从 35.75 涨到 46.61,提升近 11 分;DeepSeek V4.1 Flash 也从 18.37 分升到 25.24 分。四个执行模型平均提高 6.41 分(静态模式)。
- GPT-6 Astra 的编排效果就不太理想。它自己在全部任务上的平均得分有 77.29,远高于那些执行模型,可它编排的工作流交给别人跑,静态模式下平均分反倒降了 2.53 分,动态模式下也只提升 1.34 分,Kimi 和 DeepSeek 的成绩还被它拉低了。
这个结果说明,多智能体编排能力并非任务完成能力的附带品,它需要单独衡量,也值得单独优化。
好的编排者知道怎么把复杂任务拆成可执行的原子操作,并给每个子智能体配上恰到好处的上下文。这种“元能力”,目前看 Claude Opus 5.5 掌握得更好。
烧钱不一定有好结果
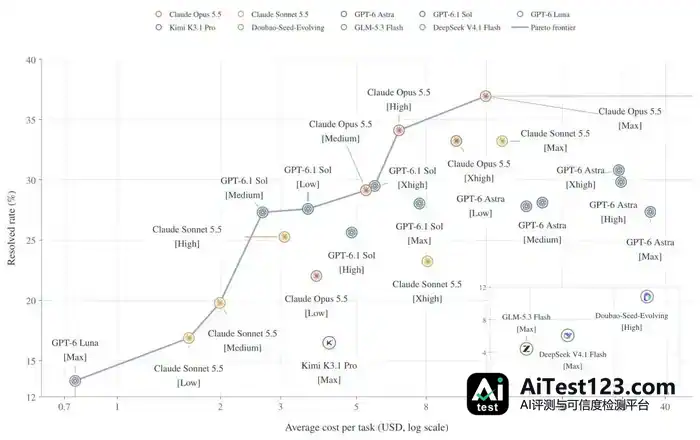
把完全解决率和每题平均推理成本摆到一处,性价比地图就出来了。
各系统的编排成本能差出数十倍:最省的配置每题不到一美元,最贵的要几十美元。GPT-6 Astra 每题的花费是 Claude Opus 5.5 的好几倍,解决率却一直没赶上后者。
推理强度调高,成本会猛涨,收益却不大。同一个模型身上,真正决定上限的是编排水平,不是烧掉多少 Token。
3D 建造任务可以说明问题。模型要照着施工图纸,在 Blender 里把建筑搭出来:
- 宫殿任务中,Claude Opus 5.5 把 7 个子智能体派出去分头建造殿宇,再组装修复,拿到 78.86 分;GPT-6 Astra 先打基础、再统一组装,得分 73.86。到了大教堂任务,Claude 选的是两次整体建造,得分 77.95;GPT 按区域分给三个子智能体再整合,得分 81.59。这一项上,GPT 的分区域策略更管用。
- 要塞任务里,两边都只用一个主建造者。差别在动工之前:Claude 先派 7 个子智能体研读图纸,得分 64.31;GPT 边建边审图,得分 55.35。
编排方式没有放之四海而皆准的答案。能不能编排好,取决于对任务结构理解得够不够深。并行有时更高效,串行有时更稳妥;前期舍得投入资源做规划(比如研读图纸),后期返工就能少一些。
下一步:异构多智能体系统
WorkflowArena 的结果说明,眼下的大模型在多智能体编排上还有很大的提升余地。只靠堆模型参数、加推理步数,边际效应已经在递减。
一个可能的方向是异构多智能体系统:让擅长规划和编排的强模型(如 Claude Opus)当“项目经理”,让擅长特定领域执行、或者成本更低的模型当“执行员工”。
从“一个 Agent 完成一件事”走到“一个 Agent 组织一群 Agent 完成一件事”,系统智能的竞赛才刚开局。WorkflowArena 留下的完整工作流记录,也为研究怎么优化这种“组织力”备下了宝贵的数据基础。
对开发者来说,设计多智能体应用时,不能只盯单个模型的能力,还得花时间打磨工作流的设计逻辑,或者引入专门的编排层。复杂的长程任务面前,组织得好比个体强更重要。