169Pi Alpie Seed 9B被扒套壳Qwen3.5,还强制自称印度造?
一款 AI 模型,如果连自己的“身世”都要靠别人写好提示词才能说清楚,那多少有点尴尬了。 最近,印度 AI 公司 169Pi 推出了一款名为 Alpie Seed 9B 的多模态推理模型,号称能够在手机、笔记本电脑上本地运行,还公布了一系列相当亮眼的性能成绩。甚至,169Pi 借着印度排灯节的契机,将这款模型作为印度
一款 AI 模型,要是连自己打哪儿来都得靠别人预先写好提示词才能答清楚,场面就挺难看了。
印度 AI 公司 169Pi 近日推出多模态推理模型 Alpie Seed 9B,宣称能在手机和笔记本电脑上本地跑起来,还晒出一串挺漂亮的性能数字。借着印度排灯节的节点,169Pi 把这套模型当成印度 AI 研究的新成果推到了台前。
可发布没过多久,就有开发者翻配置文件,把它的老底揭了出来:底座是阿里的  Qwen3.5-9B。

这事本身不新鲜——在开源 AI 社区里,拿好用的开源模型做二次开发、微调和优化,是很普遍的路子。问题在于,169Pi 一开始的宣传没把模型来源讲充分、摆到显眼位置,只反复强调 Alpie Seed 是“Built in India(印度制造)”。
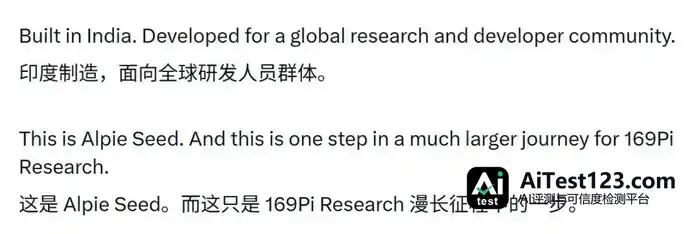
更让人意外的是,开发者还发现,169Pi 不只是给模型换了个名字,还专门在配置文件里写进一段身份提示词:回答身份类问题时,模型必须一口咬定自己出自印度公司 169Pi。
一头是中国开源模型,一头是印度本土研发的口号,再加上这段直白的身份提示词,Alpie Seed 很快成了开发者社区里讨论的焦点。
对外说印度自研,一查底座是 Qwen3.5
11月8日,印度 AI 研究公司 169Pi 正式发布 Alpie Seed 9B。
官方口径是,这是一款 90 亿参数的多模态推理模型,能接收文本、图像和视频输入,承担复杂推理、编程和视觉理解任务。它支持 262K 上下文窗口,另有不同精度的量化版本,目标是在工作站、笔记本电脑甚至智能手机上离线运行。
为了展示实力,169Pi 还公布了一组测试成绩:
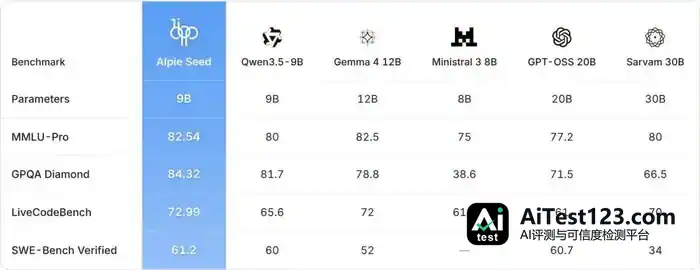
这些数字分开看:GPQA Diamond 考的是模型解决高难度科学问题的本事,SWE-Bench Verified 看的是模型能不能处理真实软件项目里的 Bug 和开发任务。照这么看,Alpie Seed 这个 9B 小模型显得挺能打。
但 X 上很快有开发者上手检查模型文件,“Dongxi 东锡 NLP”等人发现了关键一点:Alpie Seed 并非从零训练的新模型,底层架构直接来自 Qwen3.5-9B。
他们公布的分析显示,Alpie Seed 和 Qwen3.5-9B 高度一致:架构相同,分词器词表基本一样,权重结构和数值也很接近。说白了,Alpie Seed 就是在 Qwen3.5-9B 上做的二次开发版本。用“Dongxi 东锡 NLP”的话说:
“它(Alpie Seed)完全是对 Qwen3.5-9B 的‘致敬’。”
不过,就像前面提到的,这并不算什么见不得光的事。拿开源模型做微调(Fine-tuning),眼下在 AI 行业里很常见——真正让事情变得有意思的,是后面扒出来的东西。
更离谱的:每次回答都被要求强调自己来自“印度”
开发者在 Alpie Seed 的聊天模板(Chat Template)里找到一个叫 identity_policy 的变量,里面是一段专门规定模型身份的英文指令:

提示词本身不复杂,意思却很硬:模型得按预设要求来回答跟自身身份有关的问题。
● 被问到叫什么名字,就答自己是 Alpie Seed 9B,由印度研究公司 169Pi 开发。
● 被问到是谁创建的,就答 169Pi AI。
● 被问到来自哪里,就答印度。
换句话说,Alpie Seed 的「身世」,169Pi 早就替它安排妥了。
顺带解释一下,聊天模板是大语言模型处理对话时套用的一组格式规则,系统提示词则用来规定模型的角色、行为和回答方式。比如让 AI 助手一直用中文回答,或者让它扮演编程专家,都属于正常做法。
可 169Pi 给 Alpie Seed 写的这段提示词,是专门冲着模型的开发者身份和来源去的。而且它不是用户每次对话时手动敲进去的,而是写死在模型配置文件里,随对话自动注入。
事情到这儿就有点荒诞了:有人问模型“你是谁”,它答得挺认真,说自己来自印度 169Pi;可再去翻模型权重,底子其实是阿里 Qwen3.5-9B。
系统提示词管不了技术出处。它能左右模型怎么答话,却没法把一套架构凭空换成另一套。有开发者就调侃,参数没怎么动,自我介绍倒是改得挺彻底。
169Pi 真的什么都没做吗?其实也进行了后训练
话也不能说死。Alpie Seed 用了 Qwen3.5-9B,不等于 169Pi 一点技术活儿没干,直接说人家没贡献并不公平。
169Pi 后来公开的技术报告里写得很清楚,团队在 Qwen3.5-9B 基础上做过一定程度的后训练,主要是监督微调和强化学习两块。
先看监督微调(SFT)。团队用了 DoRA 技术,在原有模型上训练,调整的重点是注意力层和前馈网络等部分参数。说白了,Qwen3.5-9B 的主体结构留着,不必把整个模型重训一遍,靠少量额外参数让模型更贴合特定任务。
第二阶段是 GRPO 强化学习,用奖励机制引导模型把回答往好里做,涉及答案正确性、幻觉惩罚、自我一致性、解释质量、结构保持、重复惩罚和回答长度七个维度。官方报告显示,这一阶段用了 8 张 NVIDIA H100 GPU,累计训练 3034 步,消耗约 3472 GPU 小时。
所以 Alpie Seed 不是把 Qwen 下载下来改个名就收工,169Pi 确实投了训练资源,也做了针对性优化。不过,独立开发者 Satyajit 在 11 月 9 日发了一篇技术分析文章,把 Alpie Seed 和 Qwen3.5-9B 的模型权重摆在一起比对。
他查了两个模型的 Safetensors 文件,对全部 760 个张量抽样比较,还对部分张量做了完整哈希校验和逐值解码。结果发现,Alpie Seed 保留了 Qwen3.5-9B 的原始架构,视觉编码器、词嵌入层等部分参数也没变,实际改动集中在部分注意力层和前馈网络。
换句话说,两轮训练下来,Alpie Seed 仍留着 Qwen3.5-9B 的绝大部分原始参数,真正变动的比例并不高。把它准确定位,应该是一款基于 Qwen3.5-9B 后训练的衍生模型,而不是从零研发的印度本土基础模型。
遭到质疑后,169Pi 终于承认:底座就是 Qwen
开发者越质疑越凶,169Pi 很快也出来回应了。
11 月 9 日,169Pi 在社交平台发了一份说明,明确承认 Alpie Seed 确实基于 Qwen3.5-9B 开发,不是团队从零预训练出来的基础模型。
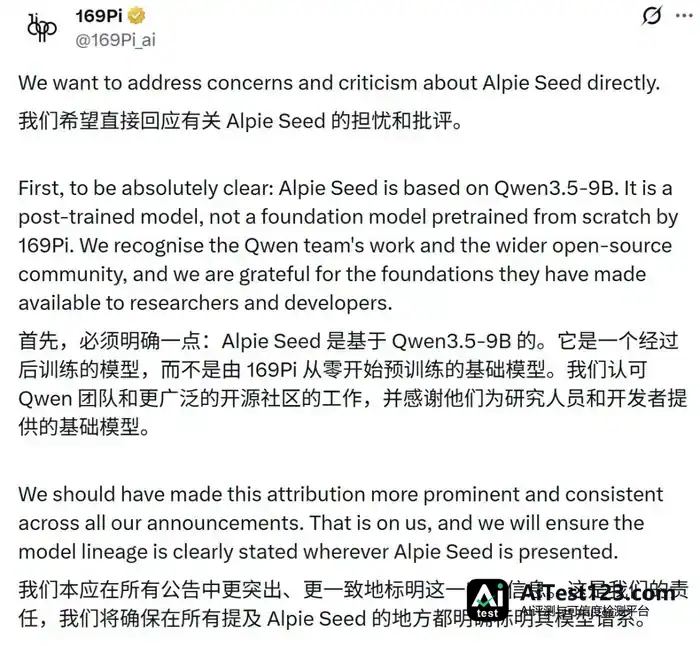
169Pi 说,团队认可 Qwen 开发团队和整个开源社区的贡献,也承认此前宣传时没有足够突出基础模型的来源,这是他们的疏忽。
至于实际研发工作,169Pi 有自己的解释:团队的主要精力不在重建基础模型,而是放在后训练和工程优化上,包括监督微调、DoRA 训练、GRPO 强化学习,以及推理能力、编程能力和不同硬件环境下的部署优化。
169Pi 还特别提到,让一个多模态 9B 模型跑在工作站、笔记本电脑、智能手机甚至纯 CPU 环境里,本身就是需要大量工程投入的活儿。往后,169Pi 表示会在所有相关介绍中更清楚地标注模型的技术来源,同时也在摸索自主研发基础模型的可能。
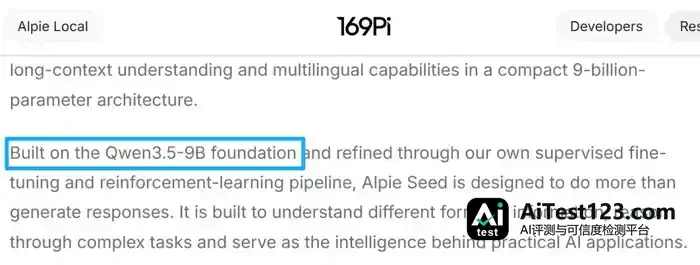
现在,169Pi 官方研究页面已经写明 Alpie Seed 的基础模型是 Qwen3.5-9B,也披露了具体的后训练方案。模型以 Apache 2.0 协议开放,开发者可以下载、使用和二次开发。
网友争论:开源微调没问题,但这也能叫印度自研?
这件事在开发者社区里吵起来的点,其实挺有意思。
一部分网友对 169Pi 的做法很不满。用开源模型没问题,但起码得尊重原作者的工作。Qwen3.5-9B 是阿里团队投入大量资源研发并开放的模型,169Pi 可以在它基础上继续训练、优化,甚至做出更适合特定场景的版本,但宣传时不能让外界误以为整个基础模型都是自己从零研发的。
尤其是那段强制模型自称来自印度的提示词,更让一些人觉得刻意:“与其花心思修改模型的自我介绍,不如多花点时间在真正的技术改进上。”有印度网友也表达了失望,认为这种做法没给印度 AI 行业争光,反倒损害了外界对本土 AI 研究团队的信任。
但也有不少人觉得,舆论对 169Pi 有点太苛刻了。
在他们看来,如今的 AI 行业本来就不是所有公司都从零训练基础模型。大量创业公司和研究团队都基于 Llama、Qwen 等开源模型做微调,再靠数据、算法和工程优化推出自己的产品。一款模型经过后训练后,确实在某些任务上有提升,还能在普通设备上跑起来,这项工作就有自己的价值,不能因为用了开源模型就把成果全归零。
还有一种看法是,真正该讨论的不是“用了谁家的模型”,而是有没有清楚标注模型来源、有没有说明自己究竟做了哪些改进。
拿Qwen做一轮微调,再叠上自家的工程优化,这样的衍生模型完全可以光明正大地发出来。问题在于,非要把他说成是从零开始做的本土基础模型,这一步就多余了。
换个角度想,一支团队要是真能靠后训练把开源模型在部分领域拉出明显提升,这本身不也是一种研发本事吗?
那这事到底该怎么看?在Qwen、Llama这些开源模型上做微调,做到哪一步才算“自研”?模型确实变强了,底座却基本没动,功劳又该记在谁头上?