普林斯顿造AI科研试验场:1000篇论文能跑起来?
一个属于 AI Scientist 的世界。
AI Scientist 已经能读科研文献了,可要接着别人的研究往下做,光看懂论文远远不够。人类科学家会从论文里找出问题、借来方法,再搭实验去验证新想法;AI Scientist 同样需要一个能真正跑实验、检验想法的研究环境。
这样的环境得留住论文里的研究问题,还得给出能跑起来的方法和判断改进的标准。问题是,现有的研究环境多半靠人工挑任务、用过去的竞赛题或固定的模拟世界,很难同时做到大规模铺开、持续更新,并用真正跑起来的计算实验来检验研究成果。
普林斯顿大学团队因此提出了 Scientist World,把研究论文变成可执行的环境。AI Scientist 在其中提出新方法、做实验,再把实验结果和原论文的复现结果比一比,看自己改进多少。

论文链接:https://arxiv.org/abs/2611.08478
论文里写道,首批发布包含 1000 个经过独立验证的环境。团队还保存了 AI Scientist 的研究轨迹:跨不同模型、推理档位以及 Improve 和 Innovate 两种模式,所有保留尝试累计约 6400 小时的端到端运行时间。每次尝试都留下研究想法、修改过程、实验日志、分数和完整的开发历史。
Scientist World 要衡量的,是能跨不同问题反复做出发现的研究能力。人类科学家常常在阅读中生出疑问,提出解释,再设计实验;实验失败后,还得弄明白为什么失败、调整方案、重新验证。换到另一个问题上,这套判断照样得管用。照团队的理解,解出一道题不代表有科研能力,持续面对新问题并作出发现,才是研究的关键。
于是 Scientist World 从文献里同时提取两类资源:研究问题给出探索目标,已有方法和实验结果给出出发点。每篇论文都能成为一处继续做研究的场所。
要完成这一转换,先得把论文里的实验重新跑起来。团队设计了一条无需人工介入的多 agent 流水线:系统先实现论文中的方法和评估程序,尽量复现论文的核心科学主张,并在允许的小误差范围内达到报告结果;随后把研究问题整理成任务,明确什么样的结果算科学进步,同时排除走捷径或利用评分规则拿高分的做法。
任务设计完成后,系统把环境打包,使其能在不同机器上运行,最后交给独立 agent 验证。

进入环境的 AI Scientist 由此拿到一项开放的研究任务,以及一套能实际执行的评估方式。它提出的新方法,会和原论文的复现方法比较。衡量改进程度的指标叫“前沿归一化改进量”(Frontier-Normalized Improvement,FNI):以论文方法的复现版本及其复现分数为零点,再按固定前沿模型组的分布对改进幅度做归一化;FNI 大于 0 就表示超过了复现后的源方法。
这套自动转换流程也承担着扩展研究环境的任务。人工逐项搭任务,很难快速覆盖大量主题,而 Scientist World 能从文献中持续生成环境。团队把它设计成持续吸收新文献,让评估环境不断更新,避免固定基准随时间老化。目标在于评估模型能不能开展研究,而不只是回忆见过的东西;不过他们并未进一步证明这种机制已经消除了数据污染,或显著降低了模型对已见题目的依赖。
环境建好之后,AI Scientist 的用法主要分两种。改进模式下,模型拿到论文的研究思想和已经复现的方法,在此基础上找更好的方案。创新模式下,模型拿不到论文的源代码或复现方法,得从空白的方法目录起步;问题说明、目标与约束、可见评测器和数据接口仍然看得到,方案要自己构思、自己实现。
两种模式呈现出不同的能力分布。在论文选取的 10 个低计算成本环境中,模型在 Improve 和 Innovate 两种模式下的排名并不完全一致。擅长沿着已有方法改进的模型,未必同样擅长从问题出发提出新方法。沿着已有思路推进和独立提出方案,相关,但有区别。
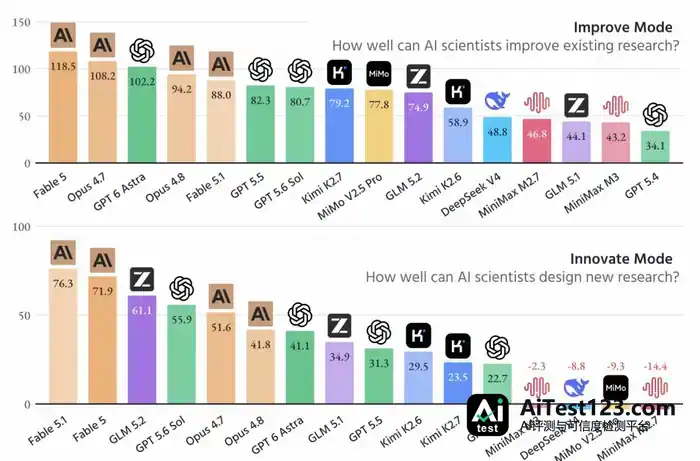
另外,Scientist World 保存每次研究的完整轨迹,把决策和真实实验测出的结果对应起来。想法怎么提出、实验怎么做、失败后怎么改、最后拿到什么结果,都成了数据的一部分。约 6400 小时的记录里有成功,也有没奏效的尝试。这些记录随环境一同发布,还会进一步用于训练。
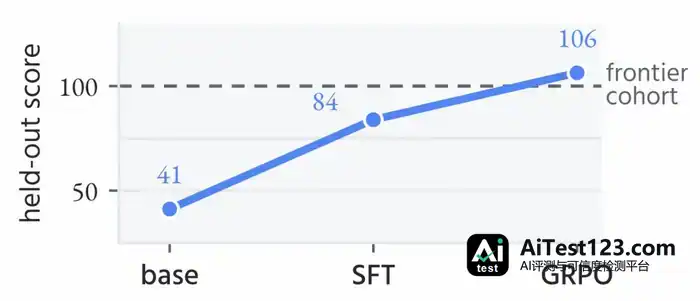
团队接着用这些研究轨迹训练 Qwen3-8B。训练奖励由实际执行实验得到的分数构造,而非语言模型评委主观打分。评估时,由一个固定的前沿执行模型负责把这些想法实现出来,再看实际效果。
在 10 个留出论文环境中,他们让固定的 GPT-5.6-Sol xhigh 执行不同版本模型提出的 ideas,比较最终实验结果。经过训练后的 ideas,其 FNI 中位数提升到约 106.3,接近论文设定的前沿参照锚点。这个实验控制了执行模型和执行条件,所以观察到的差异主要反映 idea 来源或研究质量的变化,而不是 Qwen3-8B 自己跑完了全部实验流程。在固定执行器、提示词、采样参数和实验预算的条件下,他们把性能差异解释为不同 idea 来源及其研究质量带来的差异。这个结果可以作为科研构思质量的一个操作性指标,但不能直接证明模型具备一种独立、普适且唯一由构思能力决定的科研能力。
到这里,同一套环境承担了三项用途:评估 AI Scientist 能不能推进真实研究,保存科研过程形成数据集,以及充当以实验结果为奖励的训练场。
Scientist World 把已发表论文中的研究记录变成了可运行、可评分的环境。同一套环境,既能评估当下的 AI Scientist,也能训练下一代 AI Scientist。更多技术细节,详见原论文。