清华江瑞课题组发布ProtCell:3.8亿细胞数据,S5000完成预训练复现
ProtCell 基于 3.8 亿细胞、98 个数据集预训练,可精准映射细胞状态,为虚拟细胞构建提供支撑。摩尔线程 MTT S5000 复现预训练,指标仅与国际平台差 0.2%,验证自主算力承载力#AI4S#
所属频道
模型发布
11 月 14 日消息,据摩尔线程公众号,清华大学自动化系江瑞课题组近日推出面向单细胞蛋白组的基础模型 ProtCell,论文《ProtCell:a foundation model for single-cell proteomics》也一并完成。预训练与评估动用了 98 个公开数据集、约 3.8 亿个细胞。这个模型能精确刻画细胞状态,还能推断没测到的蛋白表达,为药物研发和前沿“虚拟细胞”构建打下关键底座。
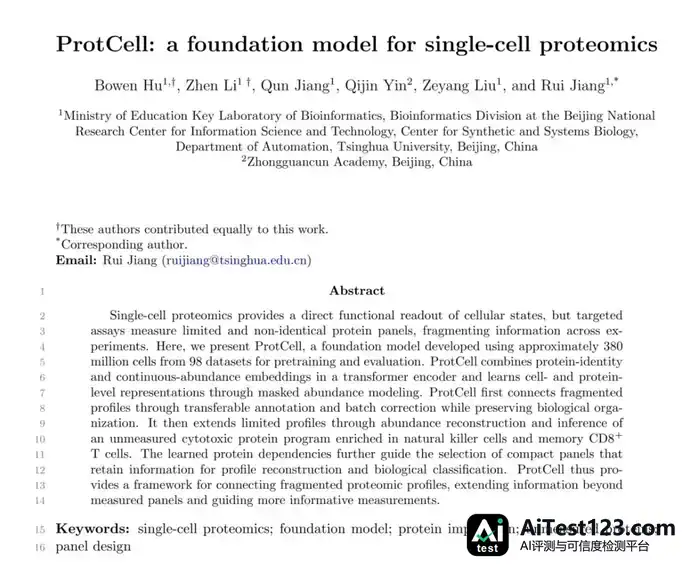
论文还提到,团队用摩尔线程旗舰级 AI 训推一体智算卡 MTT S5000 跑通了 ProtCell 的全流程预训练复现。主要定量评测指标跟国际主流 GPU 平台相比,差距只有约 0.2%。这验证了摩尔线程全功能 GPU(Universal GPU)和 MUSA 全栈软件生态能够承载前沿生命科学基础模型。
公开信息显示,“虚拟细胞”要做的是用 AI 在计算机里搭出细胞的运行模型,既描述细胞当下状态,也精准预测细胞在药物、基因编辑等干预之后的动态变化。这一方向已是全球 AI4S 竞争的核心战略高地。
国际上,顶尖科研机构和科技巨头正砸下数十亿美元、投入万卡级算力集群争抢这一领域。国内,《国务院关于深入实施“人工智能 +”行动的意见》已将「人工智能 +」科学技术排在重点行动首位。虚拟细胞研发依赖的基因组、蛋白组等核心数据,高度关系国家生物遗传资源安全,把先进算力基座做到自主可控因此格外重要。
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。