LLaVA-1.5算错菜单价格,西工大DGP重构视觉与语言层连接
很多多模态大模型在处理细粒度视觉任务时容易翻车,比如算错菜单总价。西北工业大学和港科大研究发现,问题可能出在视觉信息进入语言模型的方式太僵化。他们提出的DGP方法,让语言模型的每一层都能根据当前语境,动态选择最合适的视觉层特征。实验显示,这种方法在LLaVA-1.5等主流架构上均能提升性能,且无需大幅增加计算成本。
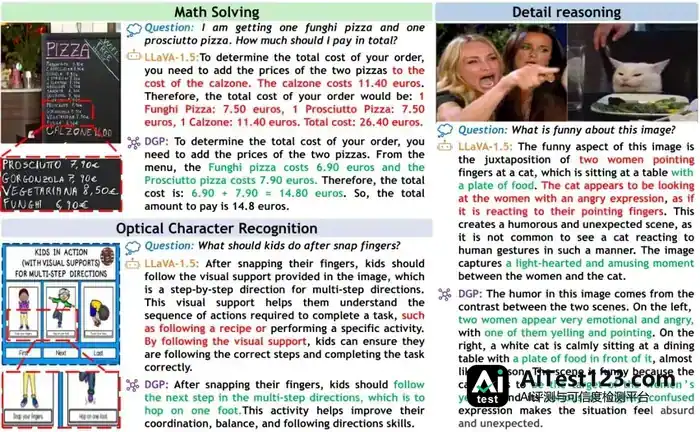
一道菜单加法题,把多模态模型的短板摆上了台面。
设想这样一个场景:让AI看一张餐厅菜单图片,然后问它,一份Funghi披萨(6.90欧元)加一份Prosciutto披萨(7.90欧元),总共多少钱?
听起来不过是小学一年级的加法。可当时主流的开源多模态大模型LLaVA-1.5给出的答案让人哭笑不得:26.40欧元。价格读错了不说,它还凭空编出一份根本没点过的Calzone(意大利折叠披萨)。换成新方法DGP之后,模型把两个价格都读对了,算出的总和是14.80欧元。
一个简单的案例,指向一个长期被忽视的问题:多模态模型的瓶颈或许既不在语言模型的推理能力,也不在视觉编码器看不清,而出在两者之间的“接线方式”上。
为什么“只看一次图”不够用?
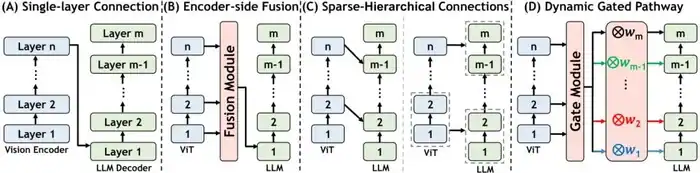
眼下大多数多模态大模型(MLLM)走的是一套固定流程:视觉Transformer(ViT)先提取图像特征,一般只拿最后一层或倒数第二层的输出,经投影层转成视觉Token,再一次性注入大语言模型(LLM)的输入端。
这相当于让LLM在开始读题之前,只扫了一眼图片的“总结摘要”。之后不管LLM内部有多少层网络在做复杂的语义推理,它们依赖的视觉信息始终是那份固定不变的“摘要”。
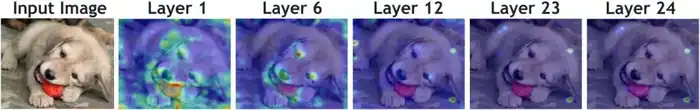
问题在于,ViT不同层级所编码的信息粒度差别很大,这一点被这套做法忽略了。

- 浅层盯的是边缘、纹理、颜色这类局部细节。要认菜单上的小字价格,或者分辨猫的表情,浅层信息就派得上用场。
- 深层则偏向全局语义、物体关系和抽象概念。要理解一幅画的创作背景或场景含义,深层信息更管用。
一旦所有LLM层都被迫使用同一份深浅特征混在一起的视觉表示,“错位”就出现了:管细粒度识别的语言层可能拿不到足够的纹理细节,管宏观理解的语言层又可能被过多噪声干扰。
已有的改进思路有两条。一条是在视觉端把多层特征融合成一个向量再送进LLM;另一条是人工预设某几个视觉层连到特定的语言层。前者仍然让所有语言层共享同一份信息,后者灵活性不足,应对不了千变万化的具体问题。
DGP:让每一层语言模型按需“翻阅”视觉资料库
围绕这一痛点,西北工业大学与香港科技大学的研究团队提出了DGP(Dynamic Gated Pathways,动态门控路径)。
DGP的思路并不复杂:视觉信息不该被当成一次性灌进去的静态数据,而要变成一个随时能翻查的动态资料库。LLM每层处理当前问题时,都有权自己决定“这一层视觉特征我要不要看、看多少”。

1. 全层连接,动态路由
过去要么只接单层,要么按预先定好的方式对接,DGP把这两道限制都拆了。LLM的每一层都能访问ViT的所有层。不过把所有视觉层直接相加并不行,那样只会把噪声带进来。
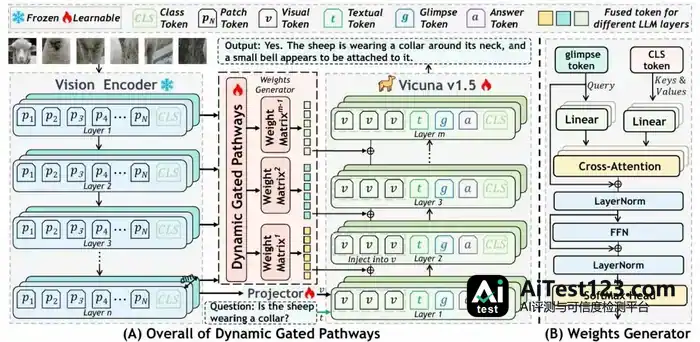
动态路由机制就是在这里派上用场的。LLM每一层都会结合当前图像内容、问题文本和该层自身的语义状态算出一组权重,再由这组权重决定从ViT哪些层取多少信息。
举个例子:
- 比如LLM浅层碰到“菜单上写了什么价格”这类问题,路由机制可能给ViT浅层更高的权重,好拿到清晰的文字边缘和纹理。
- 换成LLM深层在琢磨“这幅画表达了什么情感”,路由机制则可能更多去调ViT深层的语义特征。
这些连接关系没有预先写死,而是可学习的,并且随输入样本和问题不同而动态变化。
2. 技术实现:Glimpse Token与门控融合
实现层面,DGP加了一个可学习的“Glimpse Token”(瞥视令牌),位置在图像和问题之后、答案生成之前。自回归注意力机制让它能把前面的上下文信息都捕捉进来。
每个LLM层拿自己对应的Glimpse Token状态当“查询(Query)”,去检索ViT各层的“键值(Key/Value)”。ViT各层的[CLS]标记在这里充当该层信息的摘要。
模型通过一个共享的多头交叉注意力模块,加上每层独立的路由MLP,为每个ViT层算出一个权重。接着用这些权重对ViT各层对应位置的Patch特征做加权求和,融合后的视觉特征再经门控残差连接注入当前LLM层。
训练初期模型容易偷懒,只盯住某一层视觉特征。为此研究人员在预训练阶段加了熵正则化项,鼓励它去探索不同的视觉层;到了后续指令微调阶段,正则化关掉,让模型针对具体任务形成更专一的偏好。
实验结果:不只是刷分,更是纠错
研究团队在LLaVA-1.5(7B和13B版本)、Qwen3-VL-2B以及LLaVA-NeXT等多个主流架构上都验证了DGP的有效性。
全面超越基线
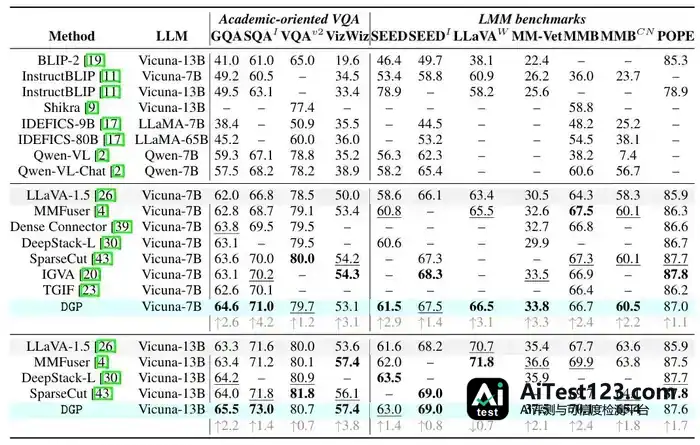
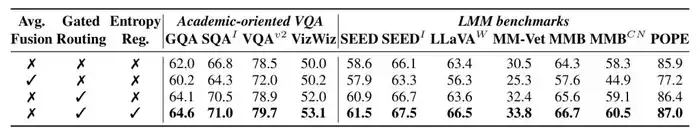
在LLaVA-1.5-7B上,DGP把11项基准测试指标全部拉高了:
- SQA-I(科学问答):66.8升到71.0,涨4.2分。这说明模型处理需要细粒度视觉理解的科学图表时,能力明显增强。
- MM-Vet(综合多模态评估):30.5升到33.8,涨3.3分。
- VizWiz(面向视障用户的问答):50.0升到53.1,涨3.1分。这类任务里多是模糊、低质量的真实世界照片,对底层视觉特征依赖极高。
- LLaVA-Wild:63.4升到66.5,涨3.1分。
更关键的是,这种增益能跨架构通用。在Qwen3-VL-2B和LLaVA-NeXT上,DGP同样带来稳定提升。比如Qwen3-VL-2B上,SQA-I从85.3升到86.9。
代价可控
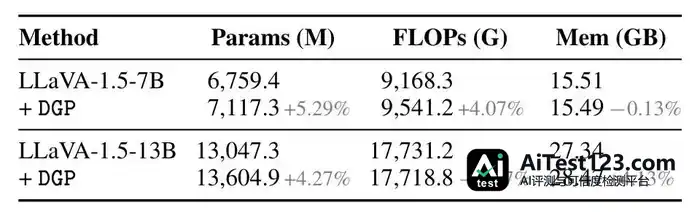
上了动态路由,计算量会不会爆炸?数据显示额外开销相当有限:7B模型上参数量只增加5.29%,FLOPs(浮点运算次数)增加4.07%,峰值显存几乎不变。对追求效率的工程落地来说,这个性价比可以接受。
消融实验:证明“动态”的价值
为了确认DGP的提升真来自“动态路由”,而不只是“看了更多层”,研究人员做了个关键对照:不学权重,直接把ViT所有24层特征平均融合,结果会怎样?
结果很糟。MM-Vet 从基线的 30.5 掉到 25.3,MMBench 从 64.3 降到 57.6。把不同粒度的视觉特征不加区分地混在一起,会彼此严重干扰,最后变成噪声。
加上动态门控路由之后,性能才回升,并且超过了基线。这组对照说明,重点不在看多少层,而在看得准不准。
可视化分析:模型是否真在“思考”该看哪里?
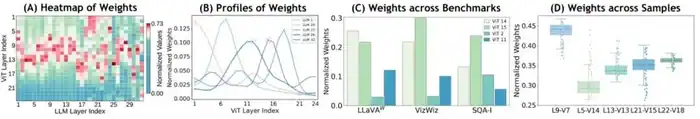
研究人员分析了DGP学到的路由权重,看到一些有意思的现象,说明模型确实会随任务需求调整视觉关注点。
- 语言层深浅不同,偏好也不同:LLM浅层更爱选ViT的浅中层特征,到了深层则更多调用中深层特征。这跟认知规律对得上——先处理细节,再整合语义。
- 任务不同,偏好也不同:VizWiz(真实场景问答)任务里,模型更依赖浅层纹理;换成需要高层推理的任务,深层特征的权重就更高。
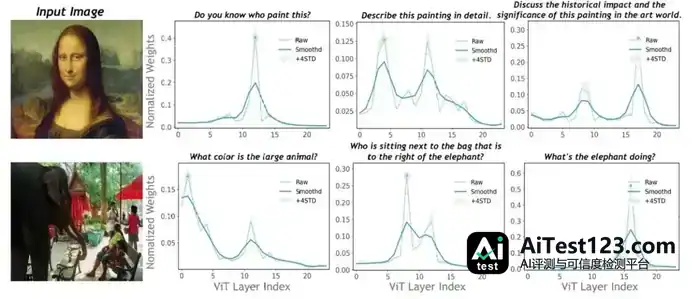
- 同一张图、不同问题,路由也不一样,这是最直观的证据。问图中物体颜色时,权重偏向保留局部细节的浅层;问场景含义时,权重很快转向深层。遇到“详细描述图像”这类综合问题,权重分布更均匀,多个层级都被覆盖。
再看融合后的空间特征图,DGP生成的特征主体轮廓比固定单层或平均融合更清楚,背景噪声也更少。LLM拿到的视觉信号质量更高,后续推理出错的概率随之下降。
局限与展望
DGP表现不错,但谈不上终极方案。现有研究主要围绕7B-13B规模的模型展开,放到30B以上的超大参数模型,或者更复杂的视觉编码器组合里,扩展性和效率都还要再验证。
计算增量虽然不大,可模型层数和图像分辨率一路往上走,全层动态连接的内存占用和通信开销可能变成新瓶颈。后续工作或许得找更高效的路由算法,或者改用稀疏化的连接策略。
结语
DGP带来的最大启发,可能不是基准分数涨了几个百分点,而是它换了一种设计多模态模型的思路。
以往我们习惯把视觉编码器当成黑盒,指望它输出完美的特征向量,再把担子全压到语言模型身上。DGP给出的答案是:视觉与语言之间不该是一根僵硬的管道,而应是一张灵活的神经网络。
真正强的多模态智能,不是让模型不分轻重地吞下所有像素,而是学会在合适的时机、用合适的粒度,看见真正重要的信息。人读书也是这样,不会盯着每个笔画,也不会漏掉关键细节,而是在宏观理解和微观辨识之间来回切换。DGP正是朝这个方向迈出的一步。