VAST发布V·STAR人才计划:三类研究任务向年轻研究者开放
薪资+期权不限!实习生也能训核心模型
薪资和期权都不设上限,实习生也能参与训练核心模型。
听雨 发自 凹非寺 量子位 | 公众号QbitAI
AI行业还在为顶尖人才付出高薪,不过评判标准已经变了:实际贡献越来越被看重,潜力本身不再够用。
年轻研究者因此卡在一处两难:企业要的是已经拿出成果的人,可参与核心项目的机会若在减少,代表作又能去哪里完成?
人才竞争由此多了一层含义。企业筛的是谁已经做出成果,年轻研究者 meanwhile 也在掂量:谁能给自己的下一项成果创造条件。能不能进核心项目、能不能参与技术路线的判断,能不能拿到与任务匹配的数据、算力和协作支持——一份人才计划对成长的承诺能不能兑现,就看这些。
人工智能公司VAST(三启万物)半年不到就拿到约50亿元融资,近日它发布了新一期V· STAR顶尖人才计划,请年轻研究者聚焦三类明确的研究任务:
3D生成基础模型、三维理解与智能体、世界模型。

它要找的人,得能参与定义问题、提出技术判断,并把探索推进成实际成果。
这些方向都指向同一件事:让AI从生成内容,走到构建可交互的世界。会写代码、能生成图像和视频,离构建一个持续运行的环境还差得远。三维对象要能被编辑和操控,智能体要理解空间并执行任务,世界则要维护状态与规则,让每一次行动都产生可以延续的结果。
这些还没解决的问题,正是VAST想和年轻研究者一起推进的研究前沿。
3D打开新的研究空间
过去大家看AI做3D,容易先看颜值:像不像,精不精致,转一圈有没有露馅。如今Agent开始接手项目,要求很快升级:模型能否导入引擎?部件能不能单独控制?想改一条腿,是否得把整个角色重新生成?
大语言模型在规划、编程和调用工具上越来越熟练,但精细三维对象仍需要专业能力。10月30日,Kimi官方发布的3D创作教程就提到,面对人物、动物、怪兽和复杂道具等适合网格建模的任务,Kimi会整理提示词与参考图,调用VAST旗下AI 3D基座模型Tripo等完成生成。
这样的协作已经长出了不少优秀作品。独立开发者Sac用Claude、Tripo与Blender组成工作流,仅花16天,就把《小王子》里的星球做成了可以探索的3D场景。开发者@thebuggeddev则将Codex与Tripo结合,制作了可在网页上查看和操作器官模型的3D人体解剖应用,后来被OpenAI联合创始人兼总裁Greg Brockman转发。
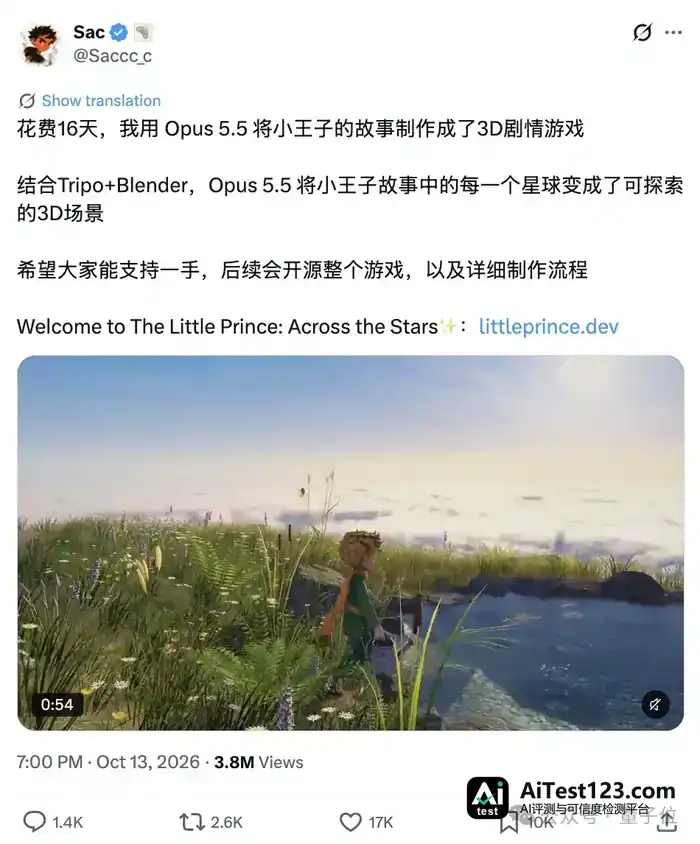
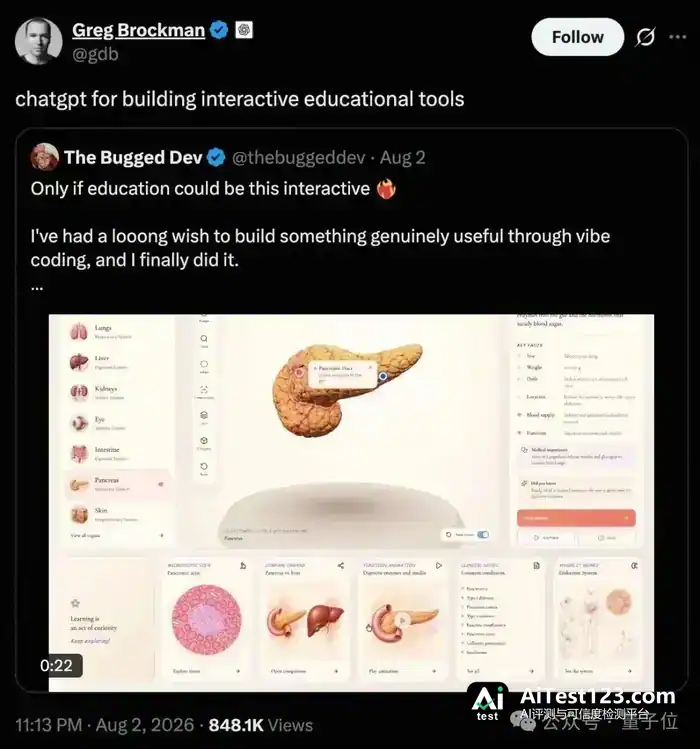
这些项目里,大语言模型负责组织流程、编写程序,Tripo提供三维资产,创作者把它们组合成可以体验的作品。一项能力接入另一项能力之后,研究问题也随之变化:生成出来的东西,怎样才能被下一步继续使用?
曹炎培是VAST的首席科学家,他做过一个相当直观的实验:先用Tripo P2.0生成一只机械蜘蛛,再借助模型产出的部件结构,让LLM给各个独立部件起名、编写运动逻辑并反复调试,最后把动画控制做到了部件一级。
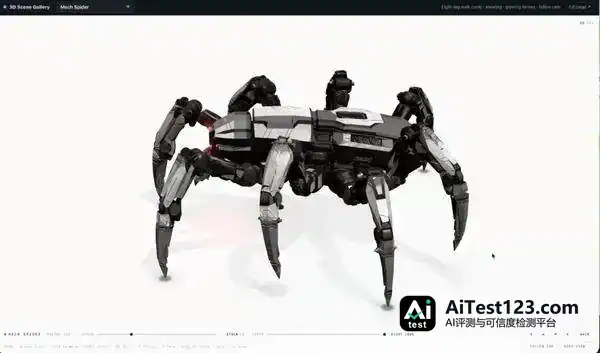
到了这一步,几何结构清不清楚、部件切得合不合理,直接决定代码能不能找准要控制的那个对象。蜘蛛的“腿”在数据里也得是一条真能操作的腿,光让观众看着像是不够的。
更复杂的项目,还会涉及同一个对象在多轮操作中的连续性。
要把自家猫搬进游戏里,脸型、花纹、体态都得留住,还得为后面的绑定和动画准备一套合适的结构。
反过来,角色动作已经做好了,只想换件外套,那就得改动指定区域,同时尽量不碰脸部特征、身体比例和原有动作。
哪些能改、哪些该留、改完还能不能接着用——这些正是VAST想靠3D原生智能啃下来的问题。
团队的办法是专门做三维训练,让模型去学形体、拓扑、部件之间的关系,还有修改前后对应的规律。制作环节里的一部分试错,就这样被提前到训练阶段,生成出来的对象也更容易被认出来、被操控、被继续改。
从三维表征走到世界模型,VAST一路上做过几次关键选择
一个AI模型看着挺像样,真进了制作流程,网格结构可能还得花不少工夫收拾。
碰上编辑、细分和动画形变,四边面拓扑通常更好处理。问题是手工重拓扑太费时间,交给自动处理又可能丢细节。
创作者刚为生成速度高兴完,就得给后续整理重新排期。
Tripo P系列模型底层的Nexus框架,想的就是让这件事在生成阶段就解决掉。它把顶点与拓扑生成拆开,用扩散模型由粗到细搭顶点,再用新的编码方式表达拓扑关系,做到无需预先排序的原生网格生成。
这套触及3D生成本质的范式,也拿到了国际顶会的认可。今年7月,Nexus相关论文被国际图形学顶会SIGGRAPH收录;同时,基于P1.0的实时演示获得SIGGRAPH 2026 Real-Time Live!的Best in Show奖项。
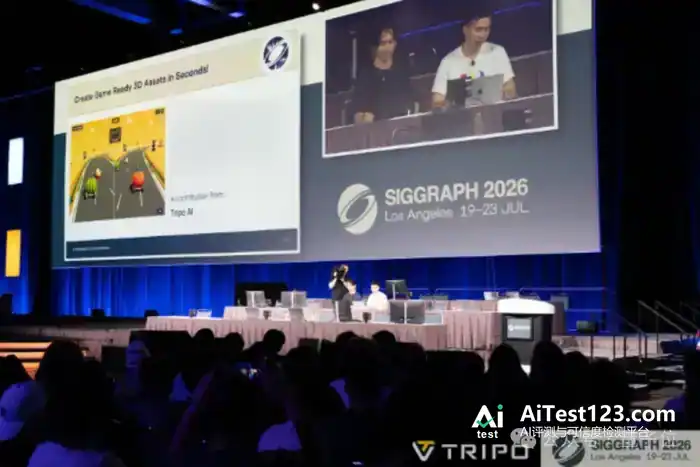
今年8月推出的Tripo P2.0,进一步支持原生四边面拓扑,数秒内就能生成以四边面为主、面数可控、部件拆分更合理的三维对象。
这些特性各有各的用处。生成快,Agent就能多试几轮;面数可控,方便适配网页和移动端的性能预算;拓扑规整,后续编辑与动画制作的障碍会少一些;部件清楚,独立控制也更容易展开。

资产好不好用,得放进完整工作流里看。
再往前一步,就是世界模型。
今年初,动作条件视频模型火了一阵:给一张图片,再用键鼠操作生成后续画面。VAST团队也觉得有意思,不过他们先问了个更本质的问题:这东西要怎样才真正有用?
拿游戏来说,角色还剩多少血、技能冷却有没有结束、一扇门有没有被打开,这些都得持续维护。总不能玩家扭个头,世界就把刚才发生的事全忘了。
10月,VAST开源了一款实时交互式渲染器EdenLive,它能面向任意视觉参考进行渲染。这是该团队在世界模型方向上交出的最新成果。
EdenLive第一次在实时生成的前提下,同时做到任意视觉参考输入、任意画风生成、长时连续生成。官方测试显示,单张GPU上,EdenLive能以超过24 FPS的速度生成720P画面,并支持分钟级连续生成。
EdenLive为什么能突破?答案在它对底层结构的解耦:上游交互引擎负责维护世界运行的状态和交互规则,下游实时生成模型负责高保真的画面呈现。
放进游戏原型里就直观了:Agent参与搭建程序与交互逻辑,三维场景提供空间结构,视频模型持续生成更丰富的画面。
玩家一边操作,画面一边更新。要解决的事情,也从“生成一张漂亮截图”,延伸到了“让整个体验持续跑起来”。
EdenLive这条路线,其实是VAST对世界模型长期探索的延伸和验证。
其实VAST对分层解耦这条路线公布得很早。6月上线的世界模型项目Project Eden里就写明了:底层负责维护世界状态,把物体属性、交互规则和动作后果都记下来;中间层将状态转换为当前视角所需要的布局、几何与事件约束;最上面的生成式渲染器则根据这些条件把画面生成出来。
世界状态不必依附于镜头存在,画面生成也有了明确的依据。
提出这个选择的时候,它并非不言自明。EdenLive核心贡献者之一Zion记得,团队内部为此来回争论过好几轮:视频模型那条路看上去更端到端,一旦拆开,会不会让人觉得不够新、像是在躲开更硬的骨头?
争论到最后,大家还是回到目标本身——他们想做的,是一个规则清晰、能持续交互的世界。照这个方向走,显式状态就值得下功夫。
Project Eden发布之后,Code World Model、AgentGarten等工作也在试同样的分工:状态交给代码、引擎或智能体维护,画面则交由视频模型生成。李飞飞团队提出的“三层”世界模型架构,以及谷歌新发布的世界模型Genie 4,路线同样与Project Eden形成呼应。
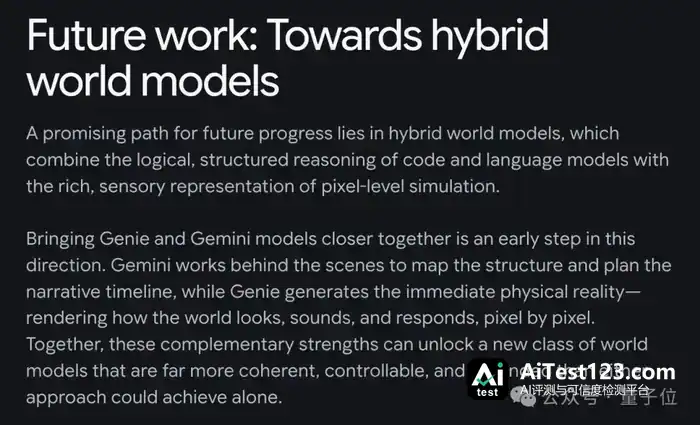
△Genie 4把“代码和LLM负责逻辑结构化推理,生成模型负责渲染和表征”这条路线写进了未来规划
能做到分钟级的连续实时生成,已经是不小的突破。接下来要解的题目是:更长时间里的一致性、更精准的控制,还有实时性和计算成本之间怎么取舍。
让年轻研究者自己定义问题,主导属于自己的代表作,这也是这次V·STAR开放3D生成基础模型、三维理解与智能体、世界模型三个研究方向的用意。
这类工作既要不同背景的人碰在一起交流,也要研究者在没有定论的时候自己拿主意:现有路线的短板在哪?哪些问题值得重新定义?要不要试一条不一样的解法?对年轻人来说,能想出点子只是第一步,更关键的是有没有机会自己去主导验证。
Tripo P系列核心贡献者Ronnie很早就到VAST实习,毕业之后正式加入。P系列最早的起点,就是他在实习期间做出的一次路线判断。
那时候,大语言模型做得风生水起,不少研究者试着用自回归的方式生成原生网格,也拿出了有生产价值的结果。可Ronnie注意到,把三维网格硬生生转成序列会丢信息;生成要求越往上走,这种表达方式的短板可能越明显。
于是他提出:能不能换条路,用扩散模型来做网格生成?
当时行业里几乎没人碰这个方向,也没有成熟路径可抄。想法提出来后很快得到内部支持,Ronnie得以继续把实验推下去。
“我们有很多试错和成长的机会,”他回忆说,“可以自己做一些out of the box的探索。”
一开始,他并没有想着要做出一条旗舰产品线。可从看出旧方法的局限,到提出替代路线,再到一步步验证,这项研究探索最后长成了Tripo P系列。
他得到的不只是参与项目的机会,更是让自己的技术判断去影响模型方向、把它做成代表作的空间。
让他印象最深的一次反馈,发生在今年3月的旧金山游戏开发者大会(GDC)。一位路过的游戏开发者看完P1.0演示,对它的能力感到惊讶,说此前没见过类似的东西。
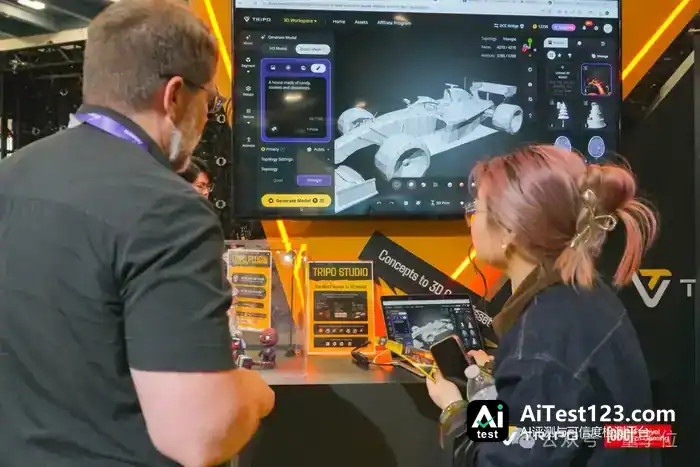
△GDC上P1.0广受欢迎
对研究者来说,这种反应很实在:自己在实验里反复琢磨的东西,真的让另一个人看到了新的创作可能。后来,开发者把模型接进不同的Agent,做出团队压根没设想过的作品,这份成就感又往前推了一步。
要让这样的探索发生,光给年轻人空间还不够,还需要什么支持?EdenLive核心贡献者之一Zion的经历,给出了另一份回答。
他早年在VAST实习过,后来去大厂的大模型团队实习了半年,也拿到了大厂人才计划的留用机会,结果校招时还是回到了VAST。
他没把这选择简单说成“大厂和创业公司哪个更好”。对他而言,要紧的是能不能探索自己关心的问题,以及探索所需的条件跟不跟得上。
回到VAST以后,数据、基础设施和算力支持都够充足,他也慢慢把自己的研究目标定清楚了:交互与仿真。
被问到再选一次还会不会来,他说:“我应该会比当时更加坚定。”
他的理由很实在:“当时期望的东西,在这不到一年里确实都得到了回应。”
关键判断不只在选路线时出现,实验做完之后同样要做:哪些该接着推,哪些要调整,哪些先放一放。
Zion试过把LLM或VLM Agent和3D生成结合起来搭场景。可当时的基础模型就算看出物体朝向不对,也很难把它稳稳转正。验证了一阵,这个课题被暂时搁下。
团队的做法是先拿有限资源去验关键假设,成立就继续投,不成立就重新讨论。允许试错,也允许研究者根据证据改自己的判断。
主导自己的研究,不等于一个人扛下所有问题。
VAST算法团队成员R想要的伙伴是“high capability、low ego”:能力强,也愿意把心思放在一起解决问题上。还在读博的实习生Stewie,已经参与到核心模型从数据到训练的完整流程。
他的感受是,同伴愿意分享理解、一起拆难题,人才密度高带来的也可以是支撑。
这些经历对应着V·STAR想提供的研究条件:入选的人能从零推动项目,参与定义重点技术方向,并拿到配套的数据、算力与协作支持。
待遇上,薪酬不受传统校招职级与薪资的限制,特别优秀者上不封顶,另有长期期权激励。
评价人才时,团队更看重一项研究有没有实质推进问题,研究者能不能讲清楚:为什么值得做,为什么选这条路线,实验又怎样改变了自己的判断。
这也回应了开头那个难题:企业看重成果,人才计划就不能只等年轻人带着代表作来,还得给出让代表作在这里长出来的条件——让他们进入核心项目,做出重要判断,有资源和伙伴一起完成验证。
从3D生成到世界模型,不少问题还没有定论。VAST希望新加入的年轻研究者不只参与找答案,也能一起决定下一步该问什么。
2027届本科、硕士、博士毕业生是V·STAR校招的对象;实习岗位则对非应届在校生开放,年级不限。可选的工作地点包括北京、杭州、上海、深圳,以及海外远程。
投递邮箱:vstar.talent@vastai3d.com
(文中Ronnie、Zion、R、Stewie均为化名)

—完—
@量子位 · 追踪AI技术和产品新动态
深有感触的朋友,欢迎赞同、关注、分享三连վ’ᴗ’ ի ❤