Cloudflare Auto Router 公测:便宜模型省的钱,够修错吗
Cloudflare Auto Router 仅根据最近几轮对每个请求的风险等级进行评分。
 Cloudflare 近日借 AI Gateway 上线了 Auto Router 公测版。用户只要把模型指定为
cloudflare/auto,分类器便会替每个请求挑一个模型。公告里最抓人的,是一份让 Cloudflare 自家路由器落败的基准测试。
路由流程分两步走。第一步由 AI Gateway 搭起候选模型池:把处理不了当前请求格式的模型剔出去,再套上凭证、计费配置、访问控制和支出限制。第二步,一个多头分类模型在 Cloudflare 边缘 GPU 上经 Workers AI 跑起来,给 14 类任务分配概率,同时从复杂性、歧义性、风险程度、对先前上下文的依赖程度四个维度,对请求打 1~5 级分。评分矩阵最后把这些结果和基准测试数据拼在一起,公开公式是:“效用 = 预期质量 - 自适应成本惩罚”。
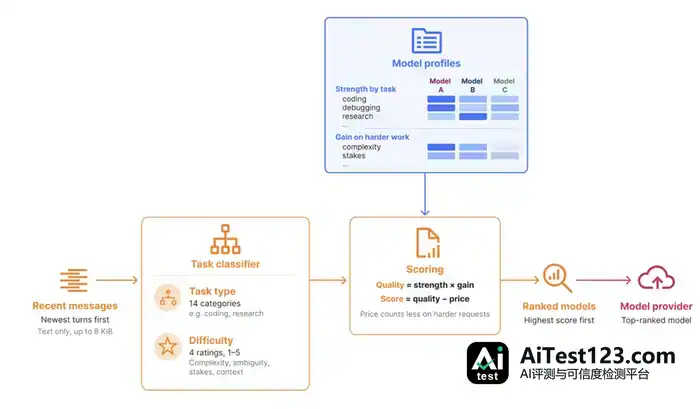
Auto Router 判断一个请求,只看最近几轮对话,文本上限 8KiB。接着它按候选模型在各任务上的能力打分,也按处理难题时的预期收益打分;任务越难,价格在评分里占的分量就越轻。
做智能体工程的 CTO Jacques B 在 Cloudflare 的一则 LinkedIn 帖子下,点出了真正该看的指标:
要是还得有人额外搭上一小时去修结果,那便宜的模型根本没省下什么。
Cloudflare 给出的恰恰是这个数字。测试共 97 个任务,每个模型采样三次,另做了 1 万次 Bootstrap 重采样。
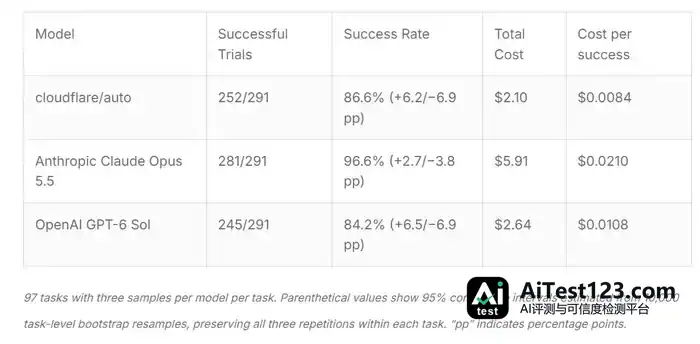
可靠性提升约 10 个百分点,成本压到原来的三分之一左右。站哪一边由团队自己定,而多数路由产品连这个选项都不给。
从业者质疑最狠的,是分类机制本身。参与过银行和医疗平台开发的技术负责人 Igor Pyrin 说,风险评分只吃一份偏重最近几轮的精简上下文:
一场较长的智能体会话里,用户可能很早说过“这是客户退款”,后面只补一句“继续执行”。我会让应用自己维护跨轮次的风险标签,拿它判断请求能不能走
cloudflare/auto。一句简短的收尾指令,不该悄悄把底层操作的风险等级降下来。偏偏真正提交操作的那一轮,常常是整段对话里看着最便宜的一轮。
文档另外补了两条。其一,响应里会带上cf-aig-routed-model 和 cf-aig-routing-reason,后者可能给出cost_optimal_within_pool 或 pinned_by_turn这类等值信息,事后可以审计模型是怎么选的。其二,能通过cf-aig-allowed-models 和 cf-aig-allowed-providers请求头对单个请求限定模型池,但眼下没法把它存成路由配置文件——Adam Natad 在发布讨论里提的正是这个需求。
信这些数据之前,还有一点要核实:当前默认模型池列了 Claude Opus 5、Sonnet 5、Fable 5,以及 GPT-5.6 Luna、Sol、Terra 和 Grok 4.5。表格里当作两项基线的 Opus 5.5 和 GPT-6 Sol,反倒躺在必须靠上述请求头才能调用的可选模型列表里。Cloudflare 称模型池“可能会随时间变化”,所以这也许只是配置漂移,不是有意为之。但想复现该基准测试的团队,还是得确认自己的网关到底选了哪些模型。
会话处理也有成本。没有会话 ID,同一段对话里的请求可能被分给不同模型,提示词缓存也就复用不上。同样出于这个原因,Cloudflare 加了一项随上下文长度增长的模型切换惩罚——新模型可能要重新生成推理 Token,而这按输出价格计费。
Reddit 上,评论者 reachjalil 干脆把这套前提推翻了,认为自动路由器“最终会让你花更多的钱,却得到更低的智能”,还说结果真要紧的话,直接用更强的模型反倒便宜。评论者 yangqi 回帖说,计量单位该是任务,不是请求。reachjalil 后续的回复又戳中一个 Cloudflare 自己也认的问题:分类这件事本身也更适合交给大模型做,而且路由权重会过时,“尤其是在模型不断变化的情况下”。文章指出,路由权重取自基准测试结果,新模型得手动加进评分矩阵。
公测期间 Auto Router 免费,之后怎么收费还没公布。目前它不支持 WebSocket,只支持 Chat Completions 和 Responses API。
路线图里还有cloudflare/auto-best。它用的是同一套分类器和模型池,但不做成本取舍,直接挑预期质量最高的模型。