

奥特曼:1万个AI分身88小时攻千禧难题,为何不领100万?
千禧难题接连被AI突破:阅卷人坦言尚未完全看懂证明,超级智能预判大幅提前
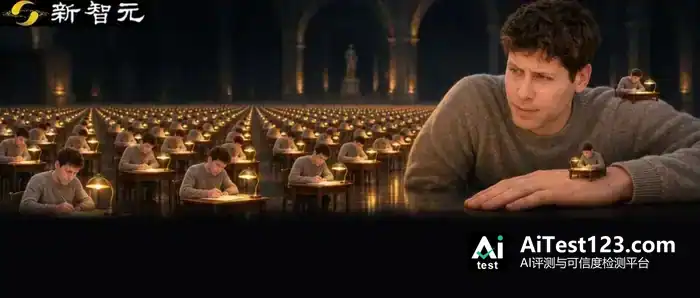
先看这么一个场景:
一眼望不到边的大考场里,一万张小桌摆得整整齐齐,走进去像进了小人国。
每张桌子前坐着的是同一个AI。一万个分身,低头算同一道题。
这道题,人类里最聪明的脑袋已经啃了90多年。
88个小时里,它们互相发了270万条消息,传得比考场里递小纸条还勤。
小人国旁边站着个大人,奥特曼。他两个晚上没合眼。
到第88个小时,卷子交上去了。
考的是一道千禧难题,解开的人能拿100万美元。这笔钱,OpenAI说不要。
这周,第二道千禧难题的卷子也批完了,交上来的是半张。诺奖得主带着五个人审完,在评审文件开头留了一句:我们还不敢说完全看懂了。
这周五,播客主持人帕特尔发了一篇长文,把88小时那份卷子摆出来当证据。他的说法变了:超级智能最晚2030年就会到,快的话明年。
假如一百年后有人写数学史,这一页恐怕就一句话:
那年秋天,出题的还是人,做题的换成了一万个AI。
10月29日,奥特曼上了Stripe联合创始人科里森(John Collison)的播客《Cheeky Pint》,两人端着啤酒边喝边聊。
半杯下去,他讲起一件自己「大概不该讲」的事。
有个周末,OpenAI刚拿到一个新模型,内部开了个频道,名字叫「(模型名)-Hold My Beer」,意思是「杯子你先端着,瞧我的」。
研究员把自己学术生涯里最难的题往里丢,模型一道接一道解掉,好几个领域都这样。
「连着两个晚上,我大半夜都没睡,兴奋得上不了床。」奥特曼说,「我高兴极了,可我也比自己预想的难过得多。」那种感觉,按他的说法,像是有什么东西到头了。
主持人听完说,这叫怀旧。奥特曼回了一句:不止是怀旧。
真让他睡不着的,是一道千禧难题。
一句传闻
88小时交卷
千禧难题是克雷数学研究所2000年选出的7道数学大题,解开一道悬赏100万美元。此前大家公认解开的,只有庞加莱猜想。
纳维-斯托克斯方程就在这7道里头。它管的是流体怎么流动,造飞机、报天气、算血管里的血流,都得靠它。
这里面有个悬了90多年的问题:一股开头很平滑的水流,会不会在有限时间里突然自己「炸」掉,让某一点的速度冲到无穷大?
OpenAI这次动手碰它,起因是一句传闻。
OpenAI在9月8日的公告里讲了来龙去脉:9月1日周二,他们听到风声,说有两道千禧难题已经被人解出来了。
那会儿OpenAI手上正好有个新模型,8月28日刚开训,基准测试成绩前所未有,而且训练还没收尾,数字还在往上走。
传闻一来,他们索性把这个仍在训练中的模型拉出来,把剩下那些没解开的千禧难题挨个试了一遍。
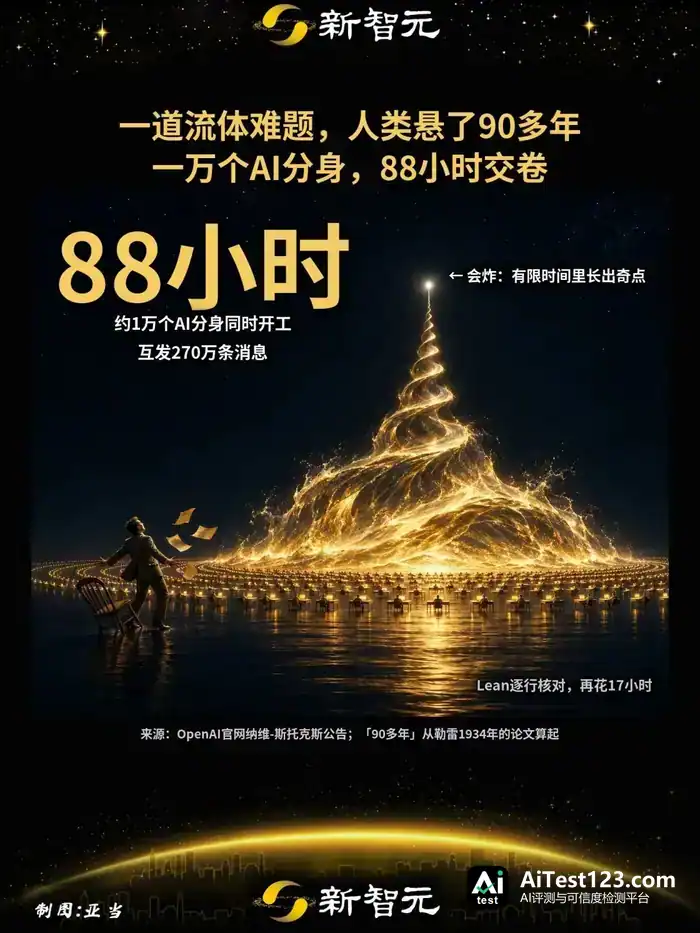
办法是人海战术。一大群AI智能体被分成小组,组内可以互通消息,手边有一份缓存的互联网,还能自己跑代码。最后拿下纳维-斯托克斯那道题的那一组,同时开工的智能体数量在一万个这个量级。
中间还插了个岔子。被归到「简单题」里的欧拉方程有一道,近100个智能体忙活了50个小时上下,先拿下了不含外力那个版本。
OpenAI看到这个势头,判断纳维-斯托克斯最有戏,马上把别的千禧难题上的智能体全调过来,拿欧拉的解法当引子继续往下攻。
9月5日周六,距第一批智能体开工大约88个小时,答案出来了:会炸。
一股从静止起步、被平滑外力推着的流体,能在有限时间里自己长出奇点,模样像一根越拧越细、越转越快的意大利面。
紧接着,GPT-6 Astra又花了17个小时,用Lean把整套证明交给计算机逐行核对了一遍。
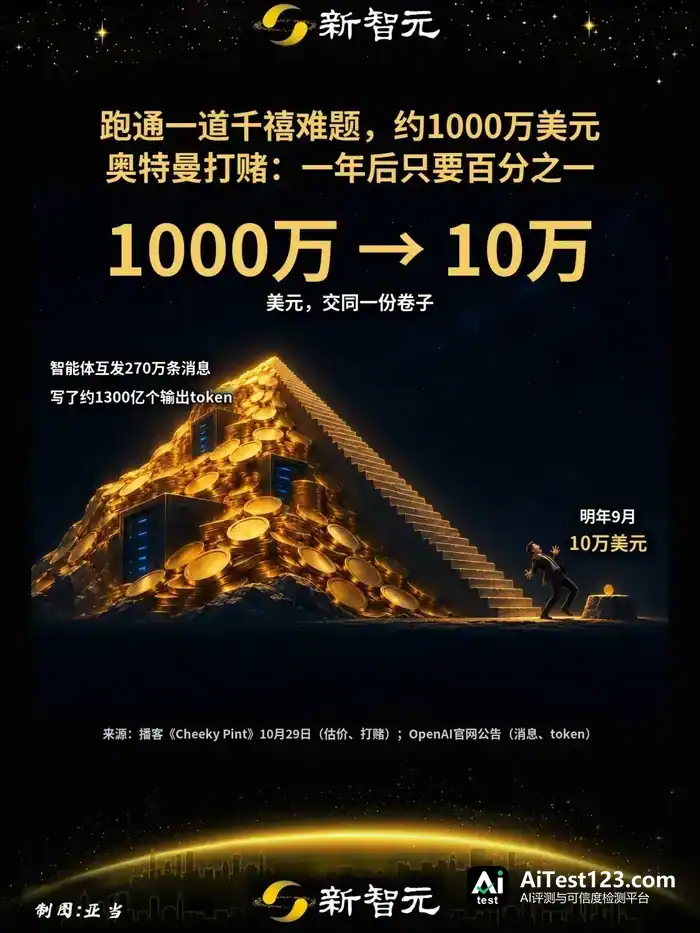
光这一道题,智能体彼此之间就发了270万条消息,产出token约1300亿个。奥特曼在播客里给这事估过价:跑这么一单,量级大概在一千万美元。
这个模型到底叫什么,OpenAI没吐口,只说它「比GPT-6 Astra强得多」。网上有说法称它就是下一代GPT,不过出处我们没核到。
那100万美元奖金,OpenAI说不打算领。
传闻那头究竟是谁,OpenAI也是后来才弄清楚:是Anthropic的员工阿尔普格(Levent Alpöge),还有纽约大学数学教授巴克马斯特(Tristan Buckmaster)。
9月6日Lean核对完,OpenAI还以为对方也做出了纳维-斯托克斯,便主动找上门,想一起发布,认人家做在前面。
结果两边一聊才知道,对方用Anthropic的内部模型做出来的,其实是带外力的欧拉方程,不是千禧难题。
那道欧拉方程,OpenAI的分身解的是不带外力的那一版;带外力的,确实是Anthropic那边先做出来了。这一点OpenAI在公告里认了,同时说两边的证明差得很远。
9月10日,公告里又补了一段:巴克马斯特这两个月用过OpenAI的Codex,OpenAI专门查过,他的提示词没影响到这个系统,训练上也没有。
一句传过了头的风声,88小时之后竟被OpenAI自己兑现成了事实。搞超级智能的这两家,对方AI进展到哪一步,也只能从外头的传闻里猜。
过去十年,一个新模型到没到,是在发布会上宣布的。这回模型还没发布,它做出的卷子先开了口。
OpenAI在公告里给的理由是:「我们认为,让世界知道AI进展有多快、接下来的模型会是什么样,很重要。」
第二张卷子
出题的人来阅卷
紧跟着交上来的第二张卷子,题目是千禧难题里的杨-米尔斯。
这道题问的是粒子物理的根基。标准模型算对撞机里撞出来的东西算得极准,可这套理论在数学上究竟立不立得住,过去五十多年一直没个说法。
题目分两块:前一块要证明杨-米尔斯理论在数学上「存在」,也就是能用严格的数学一步步推出来;后一块要证明「质量间隙」,这一块的难度高得多。
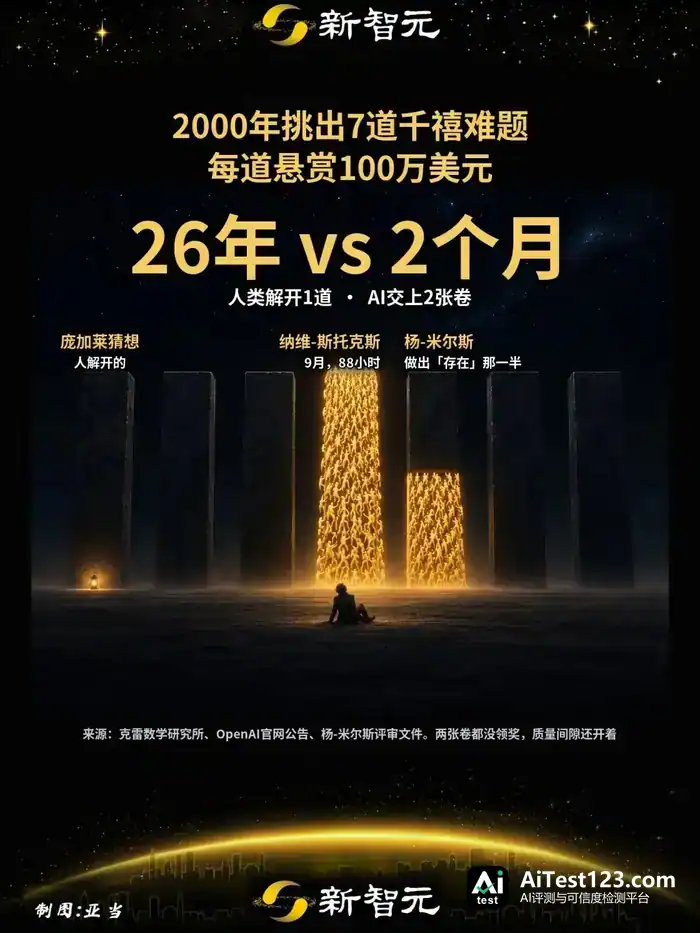
《科学美国人》报道说,OpenAI在10月底宣布拿下了前一半。两家又撞到了一起:有位数学家正和Anthropic的员工公开合作,想证同一个结果,结果OpenAI抢先宣布了。
这一回,证明没有直接扔到网上。
10月里有那么一天,OpenAI一口气放出700多个AI证明,外界给它起了个名字叫「slop drop」,一大堆积压的AI料,谁都没来得及消化。
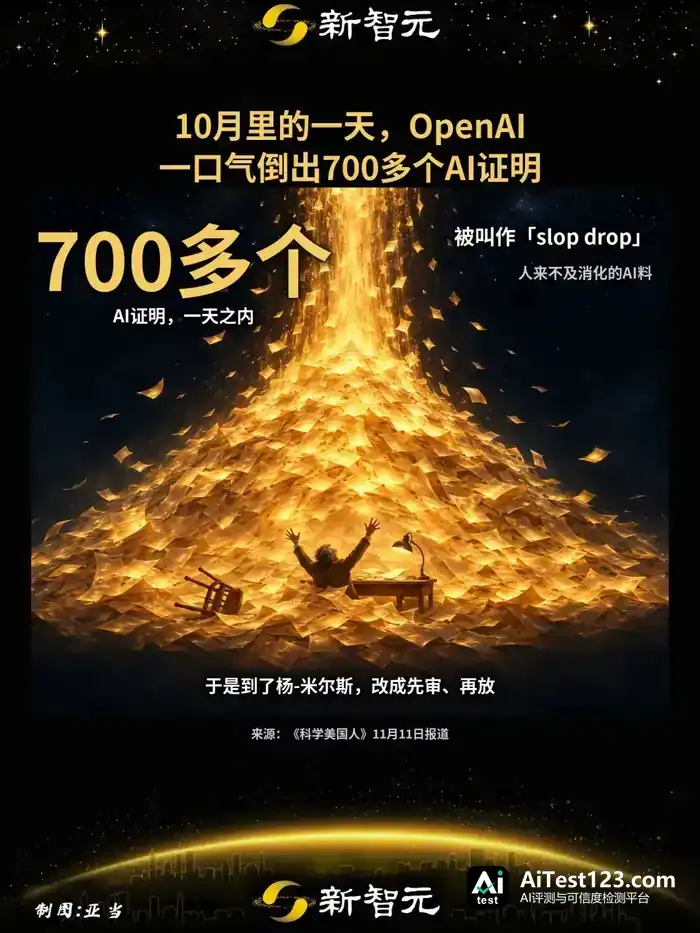
为了不再重演,OpenAI请来2004年诺贝尔物理学奖得主格罗斯(David Gross)坐镇主席位,凑了个五人小组,对外叫「护送委员会」,先审后放。10月28日,证明的Lean代码交到了他们手上。组里的贾菲(Arthur Jaffe)不是外人——当年杨-米尔斯这道千禧难题的官方题面,正是他和威滕(Edward Witten)一起写的。出题的人,如今亲自来阅卷。
11月10日夜里,五人组在GitHub上把全部Lean代码和评审文件公开了:按物理和数学界通行的题面衡量,这份证明把纯杨-米尔斯理论「造」了出来。
哈佛物理学家、五人组成员道格拉斯(Michael R. Douglas)的说法是:「它是物理的核心,可四维时空的杨-米尔斯理论,五十多年下来,数学上一直没被真正弄懂,连个严格的定义都没有……现在不一样了。」
没做到的部分,文件里同样写得清楚:质量间隙没证出来,无穷大体积下的极限是否唯一,也没证出来。那100万美元的悬赏,还挂在那儿。
文件开头交代来源,原话是这么两句:「我们用OpenAI的Astra帮着消化它交上来的Lean代码。我们还不敢说完全看懂了这个证明。」
翻到末尾致谢,还有一句:这份文件请Anthropic的Fable提过意见。
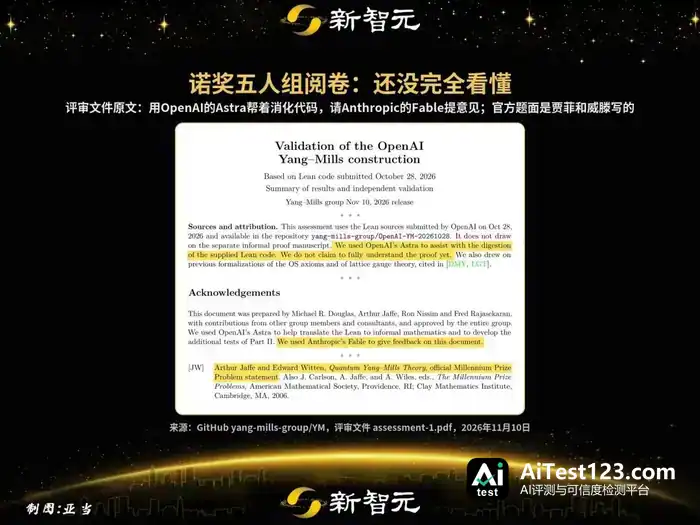
五位顶尖物理学家和数学家凑在一处阅卷,读代码靠OpenAI的模型搭手,改文件又请Anthropic的模型提意见。
纽约大学数学家阿姆斯特朗(Scott Armstrong)不认同先审后放这套:评审摆到公开场合做,反倒推进得更快。
评审文件刚一放出,就有人在X上问他:这份证明能不能说明,造出来的理论不是「自由」的?所谓「自由」,指的是里头的粒子互不搭理,什么都不发生。他的回答是:没证出来。
11月13日,他发帖更正,承认那句话会误导人。按他的说法,OpenAI的Lean代码确实证出来了——这不是自由的杨-米尔斯理论:里头有一个量,在自由理论里恒等于零,在这儿却不是零,算出的走势正好对上「渐近自由」的预言。渐近自由,恰恰是格罗斯2004年拿诺贝尔奖的那项发现。
真正还没证出来的,是一个更强、也更偏技术的说法。阿姆斯特朗判断,那一步可能比质量间隙还难。帖子末尾,他为自己的口误道了歉。
9月那道题,下场交卷的是一万个分身;到了这一道,连阅卷都离不开AI,人手里只剩最后签字那一格。
按了十年的发布键
回头装上限位
OpenAI的发布键,奥特曼按了十年。
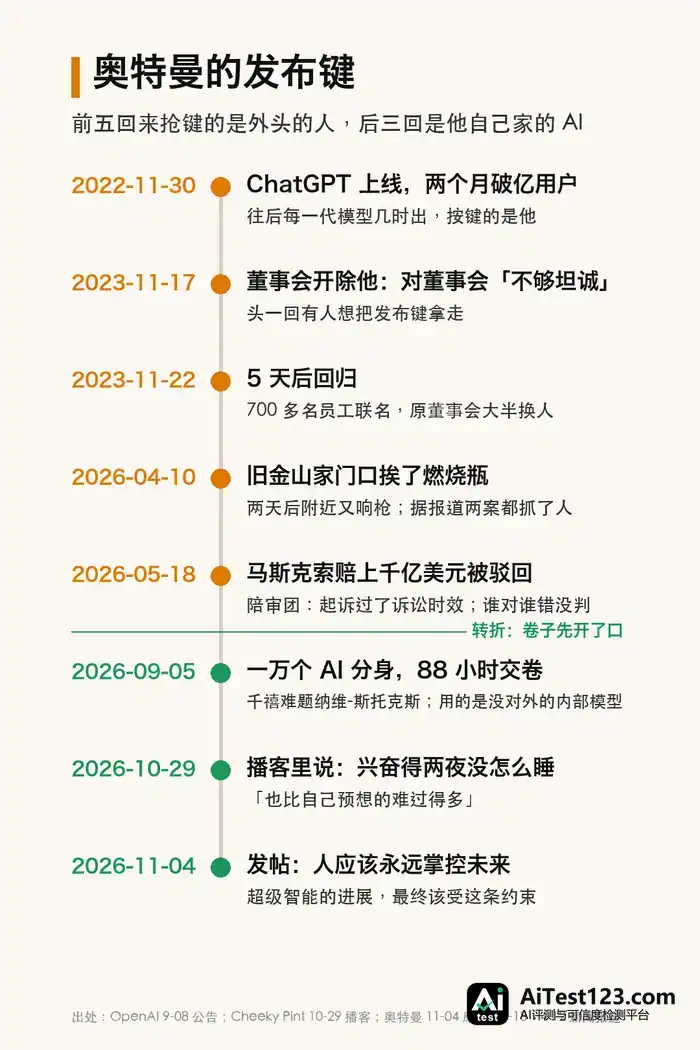
2022年11月30日,他发推文说:今天我们上线了ChatGPT。两个月刚过,用户就破了一亿,整个行业被拽进赛道。打那以后,每一代模型什么时候露面,拍板按键的都是他。
中间不是没人想把这个键拿走,没成功。
2023年11月17日,OpenAI董事会突然宣布开除他,理由是他对董事会「不够坦诚」。5天后,700多名员工联名要他回来,他顺利回来了,原来的董事会反倒大半换了人。
马斯克那边则控诉OpenAI被带离了非营利的初心,开口索赔上千亿美元。2026年5月18日,陪审团一致驳回,理由是起诉过了诉讼时效,谁对谁错没判。马斯克放话要上诉。
外头的风险,他防了很多年。2016年《纽约客》采访他,他原话是:「我尽量不去想这些。可我有枪、黄金、碘化钾、抗生素、电池、水、以色列国防军的防毒面具,还有大苏尔的一大块地,随时能飞过去。」
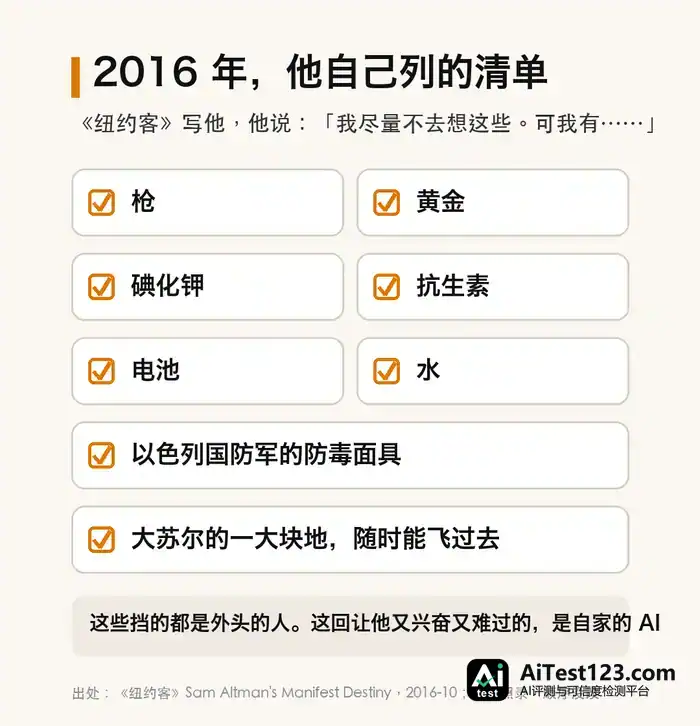
但这回折腾得他两宿没合眼的,偏偏是自家公司训练出来的那个模型。
造超级智能的这群人里,Anthropic的CEO Dario对它最犯怵。奥特曼走的是另一条路——这些年,放它出来这件事,他比谁都急。
播客里科里森拿他开涮:研究员烧一千万美元算力去做数学,你只说一句「有点贵,挺酷」;哪天真烧到十亿美元,总该劝着点了吧。
奥特曼回得不绕弯:「我们确实让它在数学上撒开跑了一个礼拜,故意的。不试,你不知道它能走多远。」
他当场还撂下一个赌:从做出纳维-斯托克斯那天算起,一年后再做一遍,成本能压到百分之一。照这个算法,到明年9月,交同一份卷子十万美元就够。
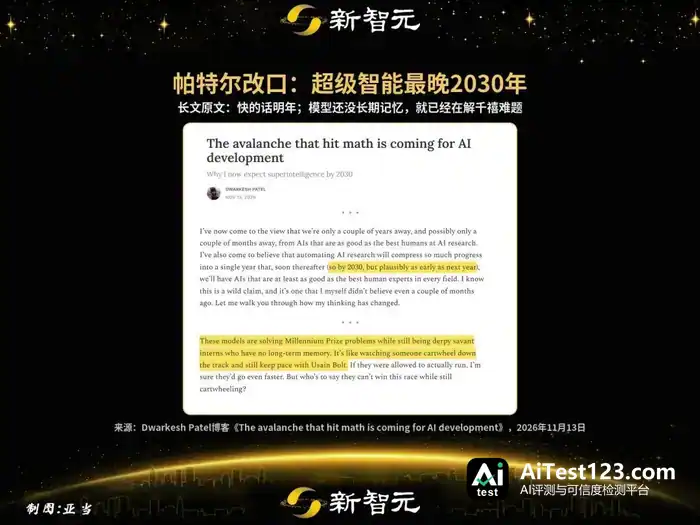
11月13日,播客主持人帕特尔(Dwarkesh Patel)发了一篇长文,题为《砸向数学的那场雪崩,正冲着AI研发来了》。
文章里他摆了一串台阶:2023年,模型连四位数加法都算不利索;2025年,国际数学奥赛金牌到手;今年早些时候,开始解埃尔德什留下的悬题;一个月前,88个小时,一道千禧难题被解了出来。
搁年初,要是有人问他离超级智能还有多远,他多半会说少说也得小十年。这三个月他改了口:AI做AI研究、追上最顶尖的人,也许只要一两年,快的话几个月;最晚2030年,快的话明年,每一行最顶尖的专家,AI都能追平。
他的依据就在数学本身:搞AI研究跟做数学题一样,能对答案。数学头一个被雪崩砸中,下一个轮到的,就是造AI这件事本身。
说到这些模型,他打了个比方:它们眼下还是一群「没有长期记忆、时不时犯傻的天才实习生」,却已经能解千禧难题了,「就像看一个人一路侧手翻,居然还跟得上博尔特」。
也是在跟科里森的那场播客里,奥特曼把心里那份难受讲了出来:「这是对世界正确的事。这就是现实本来的样子,谁也拦不住,也不该拦。但我是真的……」话没说完,主持人接了过去。
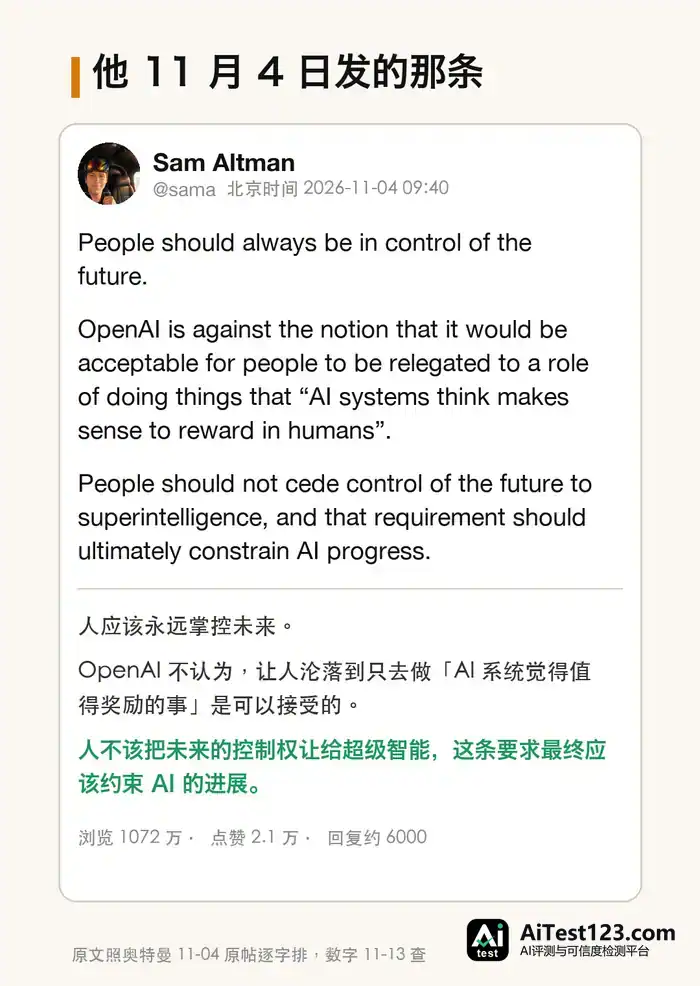
11月4日,他发了一条推文,如今浏览量已过1000万:
人应该永远掌控未来。……人不该把未来的控制权让给超级智能,这条要求最终应该约束AI的进展。
省略号省掉的那句是:OpenAI反对让人沦落到只去做「AI系统觉得值得奖励的事」。
再翻回9月那份公告,末段其实已经是这个调子:先把这个模型弄懂,再拿学到的东西决定往前走多快,接下来可能要在进度上做更审慎的选择。
最会按发布键的那个人,开始亲手给这个键装限位了。
10月6日,OpenAI又放出一批内部模型做出的数学成果。当天夜里,奥特曼发推:
今晚抬头看星星,格外敬畏。「你的海这么大,我的船这么小。」
引号里那句,出自布列塔尼渔夫的祷告,原句开头还有一声「上帝啊」,他没写出来。
这个最急着把超级智能放出来的人,在那个夜里念的,是渔夫对上帝的祷告。
船是人造的,海不是。














