稳准智能连获数亿元A轮A+轮融资,LDM路线跑出四轮连融
投资界获悉,数据基模公司稳准智能连续完成数亿元的A轮与A+轮融资。其中,A+轮投资方包括鼎晖投资、上海国投先导、徐汇科创投等一线机构;A轮由国科投资与和玉资本联合领投,高鹄资本担任独家融资顾问。至此,稳准智能自成立以来已连续完成四轮融资,此前还获得雄安基金与东方富海等知名机构的连续加注。 虽然一级市场融资迎来降温,但稳
数据基模公司稳准智能已接连完成数亿元A轮和A+轮融资,投资界获悉了这一消息。A+轮背后站着鼎晖投资、上海国投先导、徐汇科创投等一线机构;A轮则由国科投资与和玉资本联合领投,高鹄资本出任独家融资顾问。算上此前雄安基金、东方富海等知名机构的连续加注,这家公司成立至今已走完四轮融资。
一级市场融资在降温,稳准智能的份额却照样抢手。投资界了解到,有的机构上一轮没拿到份额,这一轮早早做了预定;还有一家极少出手的头部基金,这次直接锁定了大笔份额。
逆势拿到钱,稳准智能首席科学家崔鹏感触很深。在他看来,这既是头部基金集体下注一条由中国团队自己定义的技术路线,也意味着LDM(Large Data Model,数据大模型)从过去坐“冷板凳”走到了聚光灯下。
全球都在追LLM,LDM走的却是另一条路:盯住实体经济中海量的结构化工业、科研数据,做出一条有别于通用大语言模型的原创技术路径。
稳准智能是国内LDM赛道的开创者,如今开始走到台前。技术圈之外的人可能不了解,其新一代“极数”数据大模型LimiX-2在TabArena、TALENT、BCCO三项结构化数据基准的综合评测里,参评模型第一的位置都被它拿下。英伟达甚至在官方技术文章中把LimiX-2直接列入性能对比,拿它作参照来介绍新模型的推理效率。
在投资人眼里,这支清华师生团队的轮廓越来越清楚:LLM之外,他们另开LDM这条技术路线,补的是中国基础模型体系面向科学发现与产业复杂决策的能力。因果学习领域的重要学术会议和科研论坛上,这支团队如今都是绕不开的代表性力量。他们开辟的原创技术路线,也正被越来越多产业投资人关注和布局。
清华师生联手雄安国资给第一笔钱
多数投资人对稳准智能的印象,是团队色彩类似智谱——出自清华计算机系的师生创业。
先说说首席科学家崔鹏。2005年他考入清华大学计算机科学与技术系读博士,研究方向锁定人工智能与大数据分析,2010年博士毕业后留校任教。十余年间,国家杰青、国际计算机协会(ACM)杰出科学家、IEEE Fellow等头衔先后落到他头上,2018和2024年两次获得国家自然科学二等奖,顶级国际会议和期刊上发表论文200余篇,国内外顶级奖项拿了不少,学术引用量超3.4万。
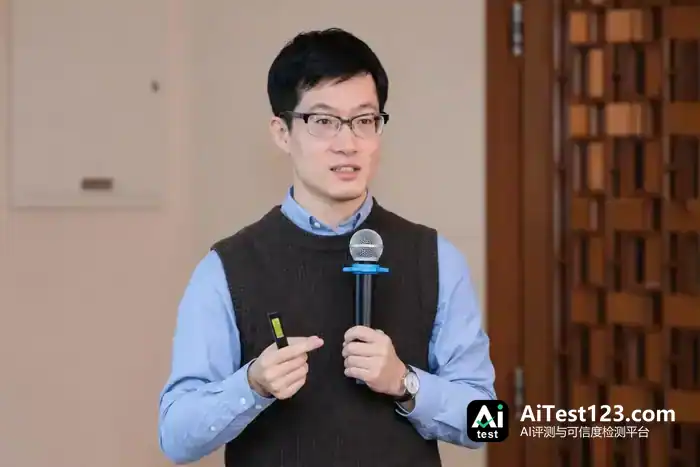
稳准智能首席科学家 崔鹏
做研究,他偏喜欢企业特别关心、学界却不太关注的方向。在清华,崔鹏给组里学生的建议是别往热点里挤,“一个方向如果很多人挤在里面,大概率只能做细碎的增量,没有条件去想底层、颠覆性的问题。”因果研究就曾是这么一张冷板凳。
2016年起,崔鹏牵头的课题组把精力投向因果与人工智能的融合,在国际上首次提出并发展了因果启发的稳定学习理论方法体系,主攻模型在未知环境中的泛化问题——十余年扎下去,为稳准智能创业铺好了技术理论的地基。
2022年起,各领域AI研究提速,冷板凳也有坐热的一天,注意到这里的人多起来了。2022年,崔鹏与美国科学院院士、斯坦福大学教授Susan Athey在《Nature Machine Intelligence》发表观点论文,系统阐述稳定学习如何连接因果推断与机器学习;2024年,团队又与国家蛋白质科学中心(北京)的研究人员合作,在同一期刊发表稳定生存分析研究,把因果启发的稳定学习进一步用到生命科学,也为团队面向科学数据的建模积累了依据。
学术上的阶段性目标一个个完成,常年盯着实体产业痛点的崔鹏发现,AI版图上有个缺口越来越显眼——
大语言模型对应语义空间,具身智能对应物理世界,可实体产业里最庞大的结构化数据空间,一直缺一个通用基座模型来呈现其中的规律和因果关联。结果就是大量表格、传感器时序、工艺台账只能“一个场景一套算法”“一张表一模型”“一个项目一个模型”。变量增删任何一个,算法团队都得重新设计算法、训练模型,耗上数周甚至更久,交付重、复用差、费效比高。
企业很关心这件事,学界却太冷门,肯投时间精力的人不多。
崔鹏决定自己下场。
2024下半年起,他带着学生正式筹备创业。崔鹏在脑子里用四个维度把创业团队拼起来:vision、depth、execution、distribution,对应公司愿景(战略方向)、技术深度、执行交付和商业化拓展。
vision由崔鹏自己扛;技术能力突出的博士后张兴璇出任CTO;另一名博士后何玥任COO。实验室里最难长出来的是distribution,得会和人打交道,还得有marketing sense,于是他找来了2018年毕业的博士、曾联合创办幂律智能的张天扬出任CEO。
2024年10月,稳准智能在雄安新区正式注册成立。雄安是央国企总部疏解的主要承载地,石油化工、能源、冶金领域的大型企业总部正大批集聚于此。公司落子雄安,从一开始就与中国实体经济最核心的那批资产站在了同一片土地上。
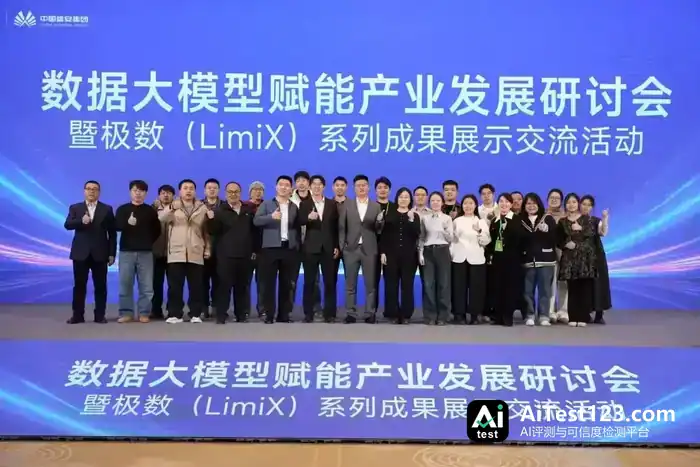
第一个下注的是雄安科技创新天使基金(雄安科创基金)——双方2024年秋天开始接触,从尽调、谈估值到最终交割打款只花了两个月,稳准智能也成了雄安科创基金投资的第一个项目。这笔2000万元天使融资,是团队初创阶段启动研发的首笔资金。
融资局面就此打开:稳准智能陆续拿到过亿元的Pre‑A轮和A轮融资,投资方包括东方富海、国科投资、和玉资本等。直到近日,数亿元A+轮融资完成,稳准智能估值在两年内翻了几番。
率先押注A轮的国科投资,专注AI、智能制造等领域。国科投资表示:“我们特别期待LimiX能成为国内工业及科研领域的核心基座大模型之一,为国家‘人工智能+’战略提供重要支撑。”它还提到,“早期押注这支队伍,主要看重团队在因果理论领域全球领先的研究成果和积累,以及团队能创造性地将因果理论与大模型通用训练方法结合,通过不断scaling up提升模型的泛化能力。”
玉资本在前沿科技领域布局已久,也是这轮A轮融资的联合领投方之一。谈到为什么投,该机构在受访时表示:“稳准智能最吸引我们的地方,是它挑了一条更难走、却更契合中国产业条件的发展路径。团队在因果学习上攒了十余年,清华师生又在技术深度、工程落地和商业化上形成配合,几样加在一起,‘数据大模型’才有机会走到产业前面。他们有可能成为LDM赛道的规则制定者,也有机会在全球竞争中代表中国力量。”
打破纪录,中国原创基座模型登顶国际
崔鹏提起一个关键时刻:2025年,稳准智能正式提出LDM概念,“极数LimiX”基座模型也在那时上线。
LDM与大众熟悉的LLM同属通用模型,两者区别在哪?
通用性的来源是最根本的差异。他举例说,LLM是见多识广的经验模型,整个世界知识库都装在它脑子里;LDM则是洞悉因果的能力模型。预训练阶段只要让模型学会抓取数据背后的因果关系,它就能在任何场景中通用,完成预测和决策。
支撑这一点的是完全不同的训练范式。
预训练时,稳准团队用结构因果模型生成合成数据,覆盖不同的变量关系、生成机制与观测条件。模型靠恢复被遮蔽的数据来学习因果关系,依据已有信息推断未知量;专为结构化数据设计的架构,则同时建模变量之间与样本之间的关系。
这套训练方式的目标,是让模型获得可迁移的数据建模能力。遇到新任务,模型把当前数据作为上下文输入,不必重新训练任务专用模型就能给出预测,同一基础模型因此可以复用到不同领域。在模型数据荒漠时代,这是结构性优势。
他打了个比方:人对数字的敏感来自小时候做的各种数学题,题目不是真实数据,却让人形成捕获规律的能力。“能力模型不需要真实经验,经验模型才需要”。题目由浅到深、由易到难,模型自会涌现出更强能力。“我们相当于用奥数训练(模型),最后(模型实战)参加的是高考”。
2025年8月,LimiX正式对外开源。随后不少大厂下载做了实测,在关键故障诊断、新材料研发、设备维护、电力交易等场景里,这个通用模型的成绩压过了客户拿自己多年业务数据训练出来的专用模型。
LimiX开源之后,这条赛道一年内就热了起来。
2026年9月,新一代模型LimiX-2发布。TabArena、TALENT、BCCO三大国际结构化数据榜单上,它均拿下参评模型第一,呈“屠榜式”领先:同一个预训练模型,不针对具体任务更新参数,就能拿到分类、回归与预测SOTA。
同月,英伟达发布Kumo Tabular,官方技术文章直接把LimiX-2纳入性能对比,并以它为参照介绍新模型的推理效率。稳准智能的模型能力,已经成了国际头部技术企业的对标对象。
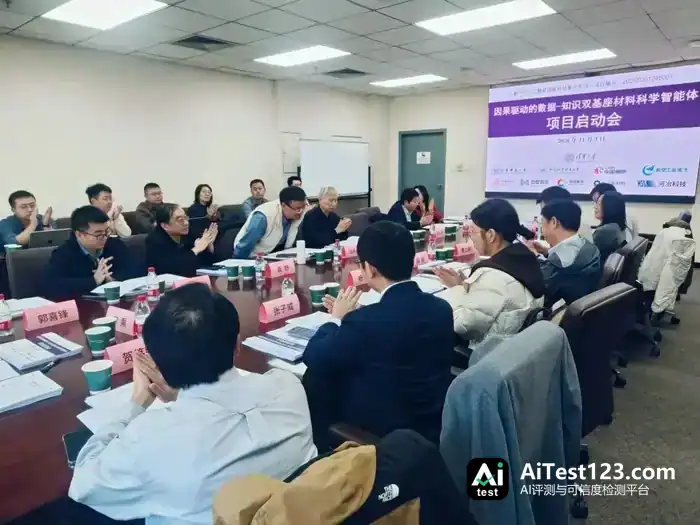
技术突破也开始进入国家科研体系。今年8月,稳准智能承担新一代人工智能国家科技重大专项“因果驱动的数据-知识双基座材料科学智能体”,把数据大模型与知识大模型的协同研发推进到材料科学这一关键任务中。
说到底,这是路径决定的。大语言模型已经把知识获取、文献分析和任务规划的能力抬上去了;科学发现还要再往前一步,要求模型直接消化实验和观测数据,找出定量关系,并且在研究条件变了之后仍然给出可靠的预测。会推理已有知识是一回事,能对未知数据建模是另一回事,两者得接上。这一步走不走得通,决定了人工智能能不能真正扎进科学研究里。
对中国来说,这项工作的意义在于形成能与既有大模型体系协同发展的原创基础能力,让人工智能进一步参与新知识的发现和关键技术的突破。
视角再放大些,这不只是稳准一家公司的创业叙事。中国AI立足完整工业体系的禀赋,走出了一条适配本土产业国情的创新路线,从技术跟随转向技术引领,也构建起与大语言模型互为支撑的另一极基座力量。
基础模型全球竞赛,赢下这一战
方向被验证后,各方力量急切涌了进来。
今年,结构化数据基础模型这条赛道明显热了起来。国内科技企业往同一个方向推,小米拿出了通用表格基础模型Xiaomi-TabLDM;蚂蚁的研究人员也参与提出RefineICL,去摸表格基础模型的上下文学习机制。
海外同样动作频频。今年5月,SAP收购TabPFN开发Prior Labs;6月,Google把TabFM装进BigQuery;此后英伟达买下Kumo、亚马逊推出Mitra……这些动作大多发生在稳准智能2025年8月开源之后。
这条过去鲜少被讨论的赛道,正吸引越来越多的创业者和投资人。
产业领域的进展更具突破性。目前,稳准智能已整体推进150多个场景的落地,并与国网北京客服中心、中网联合、中石油(北京)数智研究院、钢研国际新材料创新中心、东方国信、大唐数科、柳州钢铁、腾讯云等陆续达成战略合作。基础模型的价值,最终要在真实任务里建立。
崔鹏的看法是,大语言模型这一局,中国处在追赶的位置。可到了数据基座模型这一战,理论、开源基座和国家专项都是先从中国长出来的,再加上全球最完整的工业体系这个底子,中国手里是有牌的。
其实,这两条路线并非只能二选一,“双基座”说的就是这个意思。除了大语言模型,以LDM为代表的数据大模型同样占一席之地,地位与LLM对等,天花板还更高。分工上,一个管语义理解、知识调用,另一个管实验与产业数据分析、变量关系识别。科学发现也好,实体产业的复杂决策也好,都得靠两者配合才撑得起来。
某头部产业基金的相关负责人称,团队认可“LLM+LDM”双基座协同推进这一技术路线;在其看来,眼下加码结构化数据基础模型这一赛道,一方面贴合国内产业升级的实际需要,另一方面也能让原创技术与产业、科研场景结合得更深。
说白了,就是用原创的因果学习与数据建模方法,把中国基础模型体系面向科学发现、面向实体产业复杂决策的那块短板补上。
鼎晖VGC的判断与此相近。该机构认为,人工智能正由学习数据之间的相关性,转向理解数据背后的因果规律;工业与科学领域的许多问题都藏在结构化数据里,怎样从复杂数据中找出真正起作用的关键因素,并进一步支撑预测和决策,是下一代基础模型值得探索的重要方向。稳准智能以崔鹏教授团队十余年的因果学习研究积累为依托,走出一条技术特色鲜明的通用数据模型路线。LimiX在跨场景泛化、因果推理以及真实工业场景中的表现,让鼎晖VGC看到了数据大模型的长期潜力。
某基金负责人参与了最新一轮融资,他表示,国内AGI已出现“LLM+LDM”双基座协同发展的路线;上海、河北雄安等地在科学数据管理政策的完善程度,以及产业政策与产业生态的联动性上,具备独特的区域优势。他希望能有技术创新引领性的团队获得实战空间。
崔鹏把话讲得很直白:“大的核心逻辑,是通过LDM的加持,让中国AI赋能产业的能力得到系统性升级。”他预期,LDM很快就会等到自己的GPT-3时刻;而稳准智能的目标,是长成「LDM领域的OpenAI」。
放到更大的盘面看,这差不多是中国在基础模型领域弯道超车的一次历史性机会,也关系到我们以什么姿态加入这场全球竞争。
这场产业战役,赢面不小。