清华江瑞课题组发布ProtCell:在摩尔线程S5000上复现预训练

资讯 AI 行业观察 全文 608 字 · 约 2 分钟读完 配图 1 张 分类模型发布大模型医疗 AI

IT之家 11 月 14 日消息,据摩尔线程公众号,近日,清华大学自动化系江瑞课题组发布了面向单细胞蛋白组的基础模型 ProtCell,完成了论文《ProtCell:a foundation model for single-cell proteomics》。该模型汇集约 3.8 亿个细胞、98 个公开数据集用于预训练

所属频道 模型发布行业落地

11 月 14 日消息,摩尔线程公众号披露,清华大学自动化系江瑞课题组近日推出面向单细胞蛋白组的基础模型 ProtCell,论文《ProtCell:a foundation model for single-cell proteomics》同步完成。预训练与评估动用了 98 个公开数据集、汇集约 3.8 亿个细胞,该模型能精准映射细胞状态、推断未测蛋白表达,为药物研发和前沿“虚拟细胞”构建提供关键底座支撑。
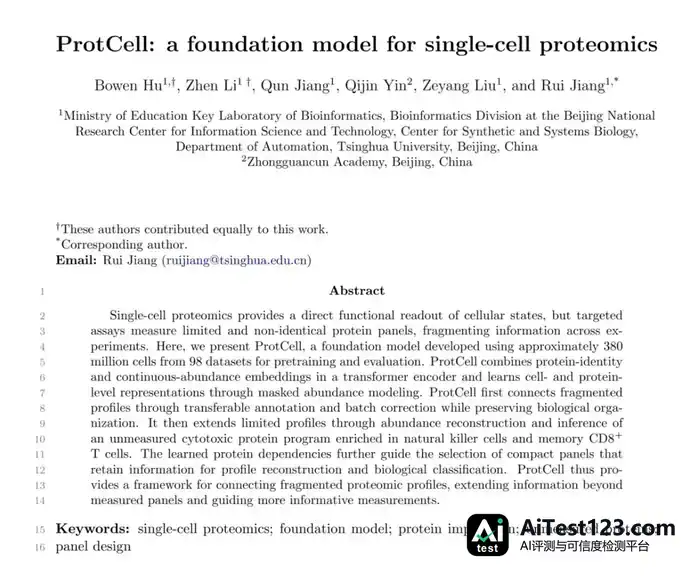
清华江瑞课题组发布ProtCell:在摩尔线程S5000上复现预训练(配图 1)

论文还提到,ProtCell 的全流程预训练复现已在该团队手中跑通,所用硬件是摩尔线程旗舰级 AI 训推一体智算卡 MTT S5000。主要定量评测指标与国际主流 GPU 平台相比,差距只有约 0.2%。这一结果说明,摩尔线程全功能 GPU(Universal GPU)与 MUSA 全栈软件生态能够承载前沿生命科学基础模型。

公开信息显示,“虚拟细胞”要做的是用 AI 在计算机里搭建细胞的运行模型:既描述细胞当前状态,也预测细胞在药物、基因编辑等干预下会如何动态变化。这一方向已是全球 AI4S 竞争的核心战略高地。

国际上,顶尖科研机构与科技巨头正投入数十亿美元、以万卡级算力集群竞逐该领域。国内,《国务院关于深入实施“人工智能 +”行动的意见》将「人工智能 +」科学技术列于重点行动首位。虚拟细胞研发依赖的基因组、蛋白组等核心数据,与国家生物遗传资源安全关联很深,自主可控的先进算力基座因此格外关键。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关 AI 工具

AI 导航
腾讯混元大模型 腾讯混元大模型由腾讯全链路自研,在文本和多模态模型性能方面表现卓越,处于业界领先水平。其混元 API 整合了… 大模型与开发平台 · tencent.com 快手可图大模型Kolors 可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型,能够根据用户的文字输入生成风格多样、画… AI 绘画生图 · kuaishou.com 盘古大模型 华为盘古ai大模型官网入口,1100亿密集参数,40TB海量数据精细训练而成 简介 盘古NLP大模型是一项基… 大模型与开发平台 · huaweicloud.com BlueLM蓝心大模型 蓝心大模型官网,vivolm,vivo自研的通用大模型 简介 蓝心大模型(BlueLM ),强大的语言理解能… 聊天对话 · vivo.com 云知声山海大模型 云知声山海大模型是一个多功能、跨领域的智能大模型,它通过集成丰富的知识库和先进的自然语言处理技术,为用户提供… 大模型与开发平台 · unisound.com 子曰” 大模型 子曰是网易有道推出的教育领域垂直大模型,包含基于子曰大模型研发的六大创新应用——“LLM翻译”、“虚拟人口语… 聊天对话 · youdao.com 曹植大模型 曹植大语言模型是国内首个垂直行业专用的自主可控的国产GPT大语言模型,由达观数据研发。这个模型可以准确完成多… 聊天对话 · datagrand.com 西湖大模型 西湖大模型官网,智商情商俱佳的多模态大模型 简介 西湖大模型是西湖心辰开发的多模态大模型,西湖大模型既具备通… 聊天对话 · xinchenai.com

相关推荐 按相关度与热度排序

全部资讯 →
  1. 语飞国际中文教育大模型发布:面向学习者、教师与机构提供智能服务

    IT之家 11 月 13 日消息,据央视新闻报道,11 月 13 日,2026 世界中文大会在北京开幕,会上发布语飞国际中文教育垂直大模型,为全球中文学习者、教师和教育机构提供智能化服务。 面向全球中文学习者,模型可提供即时反馈的学习评测、随问随答的个性化辅导;面向教师,支持在多轮对话中快速生成覆盖课前备课、课堂互动、

    来源 AI 行业观察
  2. 百度词元所上线首日:供应商增超100家,客户接入破1000家

    【环球网科技综合报道】11月14日,从百度获悉,百度词元所发布首日,新增申请入驻的供应商已超过100家,新增超过1000家客户接入。词元所在11月12日举行的百度世界2026上正式发布,百度创始人李彦宏将其称为“大模型的交易所”。据介绍,词元所一端汇聚模型和模型提供商,另一端服务企业和个人,让用户便捷地找到、购买和使.

    来源 腾讯网
  3. llama.cpp 1.0.0 发布:150+ 模型架构支持,离线跑大模型

    IT之家 11 月 14 日消息,开发者 Georgi Gerganov(X 账号为 @ggerganov)昨日(11 月 13 日)在 X 平台发布推文,宣布开源 AI 推理项目 llama.cpp 与底层机器学习引擎 ggml 的库版本迈入 1.0.0。 IT之家查询公开资料,Gerganov 是开源项目 llam

    来源 AI 行业观察
  4. 科大讯飞SparkAudio 1.0发布:99种语言202种方言,识别错误率17.17%

    当别人发来语音:“你可真行啊!” 如何理解这句话? 答案显而易见,这可能是一句夸赞,也可能是一句嘲讽。我们只要通过语气、音量和语境等信息很快就可以得出结论。但是如果想让机器也能充分理解这句“你可真行啊!”背后的含义,恐怕需要理解能力更上一层楼。现在,这个问题已经得到了真正解决。 近日,科大讯飞首个基于全国产算力训练的语

    来源 AI 开发者社区
  5. NVIDIA推Nemotron PII Japan:10万份日语合成文档,专攻隐私标注

    NVIDIA发布了包含10万份合成日语业务文档的Nemotron PII Japan数据集。该数据集覆盖金融、医疗等8个领域,提供精确的PII标注,旨在帮助开发者在不使用真实客户数据的情况下,训练和评估AI模型的隐私保护能力,特别是解决日文语境下实体识别和数值一致性校验的痛点。

    来源 AI 应用前沿
  6. IBM推LLMON标记语言:用结构化标签防住大模型提示注入

    IBM Granite团队推出LLMON,一种专为大语言模型设计的标记语言。它通过显式分离指令与数据,利用保留特殊令牌界定结构,显著降低提示注入攻击成功率。新版3B和8B预览模型在保持通用能力的同时,能精准识别执行块,忽略未绑定的干扰信息,为构建更安全的AI应用提供了新思路。

    来源 AI 应用前沿
  7. 中科院合肥团队研发肺结节AI诊断新模型M³Net,准确率更高成本更低

    IT之家 11 月 13 日消息,中国科学院合肥物质院健康所 / 合肥肿瘤医院科研团队近期联合国内外多家单位,在肺癌诊断研究方面取得进展,发展了一种基于胸部 CT 影像的肺结节 AI 辅助诊断新方法,研究结果发表在 Information Fusion 上。 肺癌是高发恶性肿瘤,早期筛查是提高治愈率和降低死亡率的关键环

    来源 AI 行业观察
  8. 大晓ACE-CaP-0:机器人自主学技能,成功率92.1%

    编辑|星奈媒体|AI大模型工场 机器人遇到新任务,难点不只是“怎么做”,还包括“该向谁学、如何验证”。通用模型已经具备任务理解、视觉推理和自主探索能力,也能根据执行反馈调整策略。但在真实操作中,每一步都要观察、推理和决策,探索一项新任务可能耗时数小时。即使模型生成了控制代码,也不代表机器人一定能成功操作:抓握角度、对齐

    来源 腾讯网
  9. 百度词元所上线:大模型交易有了验真与信用评级

    图文 | 躺姐在2026年百度世界大会上,让我感到惊喜和意外的发布,是词元所。词元所是百度推出的大模型交易平台,李彦宏在大会上把它称作大模型的交易所。它汇聚好的模型和模型提供商,让企业乃至个人都能便捷地找到、购买和使用大模型词元(Token),把“可信”变成模型交易的前置条件。平台的运行可以概括为“准入—监测—...

    来源 腾讯网
  10. 英伟达Alpamayo 2 Edge:2.45B骨干+0.2B专家,端到端智驾怎么跑?

    她叫Alpamayo 2 Edge,因果推理结合扩散动作,端到端输出闭环表现提升 48.9%。 作者丨郑佳美 编辑丨岑 峰 点开前,你以为老黄家的惊天大瓜又有了什么后续; 点开后才发现:这个“她”连人都不是。 她叫 Alpamayo 2 Edge。 英伟达11月10日刚发布出来的一款端到端自动驾驶模型。VLM 骨干约

    来源 AI 行业观察
  11. AI 时代,公司的「新厂房」长什么样?

    十年前的百度世界 2016 大会上,李彦宏曾站在台上提出「AI is the New Electricity」(人工智能是新电能),提前预判了人工智能浪潮。那时,很少有人能想到,走进写字楼,程序员用 Agent 写代码,运营用 AI 跑报表,连行政都在用大模型搭报销流程。不过,索洛悖论也再次产生。你去问企业管理者,十有

    来源 腾讯网
  12. ElevenLabs Scribe v3双模型:102语种转写与实时低延迟

    ElevenLabs发布两款新一代语音转文本模型Scribe v3和Scribe v3Live,分别面向预录制音频转写和低延迟实时语音应用,重点提升复杂语音环境下的识别能力,包括多人交谈、相互打断及背景噪声等场景。两款模型现已通过ElevenAPI和ElevenAgents平台向开发者开放。 ElevenLabs表示,

    来源 AI 开发者社区
  13. SpaceX星舰第15次试飞升空:双回收未全达成,飞船返航待验证

    【TechWeb】11月14日消息,美国中部时间2026年11月13日下午,SpaceX“星舰”(Starship)第15次试飞成功升空。此次任务使用超重型助推器 B22 号和飞船 S42 号,原计划首次实现助推器与飞船双双返回发射场并由发射塔机械臂实施空中捕获回收,同时部署 26 颗第三代星链卫星。 但任务并未完全按

    来源 AI 行业观察
  14. Edge0开源145B端侧模型:29GB内存跑起来,编程能力对标云端

    人工智能在端侧部署领域迎来了里程碑式的突破。开源项目 Edge0近日正式发布并开源了 Edge0-145B 与 Edge0-120B 模型,同时带来了一套统一的推理框架与部署工具。作为全球首个宣称可在个人电脑本地流畅运行的1450亿参数开源模型,Edge0-145B 成功将足以比肩云端前沿大模型的编程、推理与智能体能力

    来源 AI 开发者社区
  15. OpenAI董事警告:AI“接管”社会可能仅剩数月

    OpenAI董事会成员、AI安全研究者近日发出严厉警告:从AI的“奖励黑客”行为到潜在的人类灭绝,路径可能比公众想象得更短,社会被AI“接管”的时间窗口甚至可能只剩数月。随着大模型与自主智能体能力快速跃升,目标错位与对齐失败正从学术讨论变为迫在眉睫的现实挑战。

    来源 AI 科技快讯
  16. 40核老服务器无显卡跑通2.8万亿参数Kimi K3,傲腾内存成关键

    在人工智能参数规模不断膨胀的今天,动辄数万亿参数的巨型大模型往往需要依靠昂贵的高端显卡集群才能驱动。然而,近日有玩家在社区分享了一次极具极客精神的极限测试:他仅凭一台没有插显卡、搭载40核处理器的老旧服务器,竟然成功让月之暗面的2.8万亿参数大模型 Kimi K3运行了起来。 挑战硬件极限:巨型大模型遇上老旧服务器 作

    来源 AI 开发者社区
  17. DeepSeek-V4等6款模型:Blackwell指纹涉12000块GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 科技快讯
  18. 亚马逊云科技中国团队:AI落地为何个人提效企业不增效

    【TechWeb】11月13日消息,2026年AI正从“回答问题”走向“完成工作”。但对企业而言,把AI创新转化为业务价值,难点已不只是模型和工具,而是如何让AI真正进入核心业务流程、数据体系和组织的日常运行。 近日,亚马逊云科技中国团队分享了助力企业把AI创新转化为实际业务价值的实践和经验总结:AI规模化落地需要业务

    来源 AI 行业观察
  19. OpenAI解散独立机器人团队:具身智能并入通用模型体系

    11月13日,据外媒报道,OpenAI已解散独立机器人团队,原成员并入常规模型训练体系。内部判断认为,机器人只是通用模型的一类垂类任务,所需智能能力应在通用基础模型框架下统一解决。截至发稿,OpenAI官方尚未确认并披露相关细节。 这并非OpenAI首次调整机器人路线。2019年,其机械手解魔方项目Dactyl曾引发广

    来源 AI 开发者社区
向下滚动自动加载更多