文心八项测试拿两冠,字节10万亿模型仍无踪影
百度、阿里、腾讯在同一周交了卷,而Seed 2.1已经将近半年没更新了。
11月11日,久未发声的百度文心公布了一份评测结果。
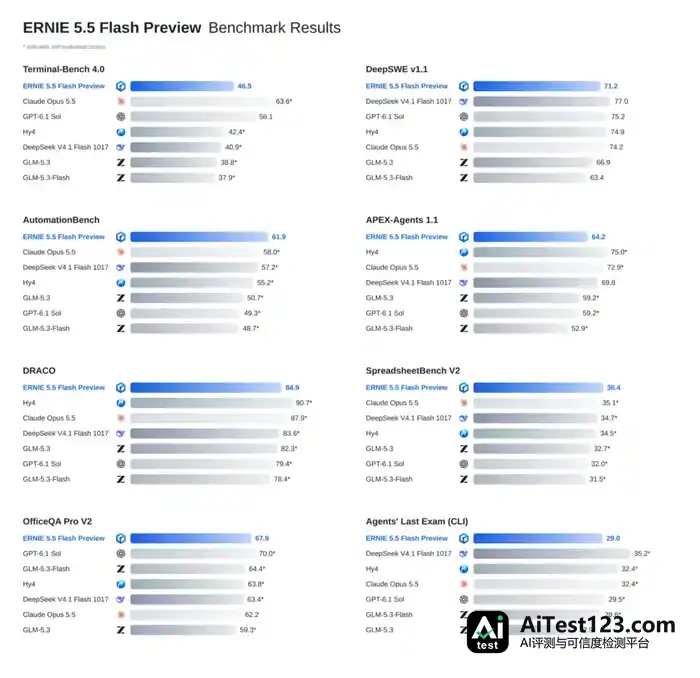
参评模型为ERNIE 5.5 Flash Preview,共八项基准测试,对照的是Claude Opus 5.5、GPT-6.1 Sol、腾讯Hy4、DeepSeek V4.1 Flash和智谱GLM-5.3系列。八项之中,它拿下两项第一。
这已是文心一周内的第三次出手。
11月5日开源基座模型文心5.5 Flash Base,11月9日公开自动研究系统ERNIE Evolve,11月11日又放出Preview。
停了将近一年的百度文心公众号,这几日也重新开始更新。
差不多同一时段,阿里把Qwen4-Max预览版开放了出来。
再早一周的11月4日,腾讯推出Hy4正式版,在Artificial Analysis的智能指数V5榜单上得35分,位列中国模型第二。
互联网时代的BAT三家,重新坐回了牌桌。
大模型走进日常之后,叙事权一度落到DeepSeek、月之暗面、智谱手里。BAT里的B,也被换成了字节跳动(ByteDance)。
可字节这边,Seed系列最新的还是6月23日发布的Seed2.1。
8月外媒曾报道,Seed团队正在预训练一个参数规模最高可达10万亿的模型。三个月过去,它没名字,没发布日期,也没拿出一张成绩单。
11月12日,澎湃新闻从多位知情人士处得知,张一鸣近期在一次面向AI团队的全员会上表示,字节有能力与OpenAI和Anthropic竞争,但要真正追平前沿技术,“最早也要到2029年或2030年”。
BAT真回来了吗?张一鸣那个10万亿模型又去了哪里?
BAT是怎么回来的?
今年2月的LMArena综合榜单上,文心5.0只排第17位,压在它前头的是字节Seed 2.0、智谱GLM-5和Qwen3.5。
那阵子百度基础模型团队把不少精力花在创意写作上,内部甚至喊出做“最强文科生”的口号;同期对手们拼的却是编程、长上下文和Agent。
百度8月18日公布二季度财报:归属于百度的净利润为23.19亿元,同比降68%,美股当天夜里跌幅12.73%。李彦宏在电话会上表态:“一路走来,过程中有尝试也有失误,但是我们要让文心具备竞争力的决心从未动摇。”他说,有信心推动文心“重新回到基础大模型的第一梯队”。
“重新回到”这四个字,等于承认了已经不在。
转机出现在7月1日。
1997年出生的复旦博士孙天祥空降百度,担任基础模型研发部负责人。国产初代类ChatGPT开源大模型MOSS正是由他主导。按《深网》的说法,这已是百度模型线近十个月里的第三轮大调整。
四个月后,文心开始接连出牌。
先亮相的是文心5.5 Flash Base,总参数280B,每个token激活14B,在33.5万亿token上从零预训练。百度把它与DeepSeek-V4-Flash-Base、腾讯Hy3-preview-Base、小米MiMo-V2.5-Base放进同一套框架测试,30项基准中24项第一。这也是百度时隔约16个月,再次开源千亿参数级模型。
Preview则是它的首个后训练版本。
AutomationBench得61.9分,SpreadsheetBench V2得36.4分,两项均列第一,都排在Claude Opus 5.5之前;OfficeQA Pro V2为67.9分,仅落后GPT-6.1 Sol;Terminal-Bench 4.0是46.5分,高于Hy4的42.4分,但距Claude Opus 5.5的63.6分仍有不小差距。
七个模型放在一起比,DeepSWE和Agents' Last Exam这两项,它排第五。
图下有一行小字注解:凡是打星号的,都是百度自己测出来的分。而对手那一栏的成绩,星号也占了大半。
百度官方的说法是“取得了具有竞争力的得分”,同时注明,这还只是后训练阶段的一个中间版本,“仍可能存在部分因训练不充分导致的能力缺陷”。
不过有两样东西是确定的。速度快、价格低:千帆平台上,单用户推理速度突破每秒200个 token,每百万 token 忙时输入2元、输出8元,目前还按五折走。另一样是开源,权重定在11月25日前以 Apache 2.0协议放出。2024年李彦宏曾说过,开源模型会越来越落后。
再说阿里。
11月11日上午10点,阿里上线Qwen4-Max预览版。价格没给,参数量没给,跑分也没给。
同一个文档页上另有一句:11月25日24点之后,该模型退役,这期间不做任何更改。意思很直白,阿里是在告诉外界,Qwen4-Max正式版11月26日发布。预热文案借的是《逍遥游》:“北冥有鱼,其名为__。”原文下一句是“鲲之大,不知其几千里也”。
能确定的规格只有几条,条条指向“大”。最大输出393216个 token,思考与答案共用这一额度,正好是上一代Qwen3.8-Max的三倍。思考强度分三档,默认 xhigh,出厂即按想得最久来设。
另外,Qwen4-Max只走Token Plan订阅,不开放按量付费。
Qwen4-Max传出的信号是“一力破万法”。预览版的思路就是这样:参数量和智能水平够高,模型就好用。
可Qwen的力气并非堆出来的,是省出来的。
9月22日云栖大会,刘大一恒首次以Qwen负责人身份公开露面。字母榜把那场演讲归结成一句话:每一份算力换多少智能。他给出的数字是,Qwen3.8-Flash对比Qwen3.7-Plus,激活参数减到1/3,训练成本降到1/9。
省法写在8月26日开源的Qwen3.8-Flash-Next模型卡里,阿里称其为“Qwen4所用模型结构的先导预览”。注意力每四层中有三层换成Gated DeltaNet,残差流由一条扩成4条,主模型之外再挂一张51B的Embedding查找表,优化器改用Muon。四处改动,讲的都是怎么省算力。
那省下来的算力去了哪儿?
现役旗舰Qwen3.8-Max总参数已达2.4T,Qwen4.5、Qwen5要扩到5到10T。模型卡里还有一句:“固定激活专家数量而持续增加专家总参数量,可稳定降低训练loss。”
刘大一恒压低每一分智能的成本,省出的钱全押在规模上。
他自己的说法是,Max系列追求智能天花板,降低使用门槛交给Flash、Plus。参数规模的扩展,仍是通向ASI的核心路径之一。
Hy4的成绩摆在那里,姚顺雨在模型圈的位置也不用多说。
Hy4总参数770B,不到Qwen3.8-Max的三分之一。Artificial Analysis榜单上它只比Qwen3.8-Max高1分,但每任务成本约0.78美元,只有后者的13分之一。
腾讯这一年发了四个模型:4月Hy3 preview,7月Hy3,8月Hy4 preview,11月Hy4。
马化腾5月这样形容自家处境:“原来一年前我们以为上了船,后来发现那个船漏水了,现在感觉站上去了,还坐不下去。”
BAT回来了。
张一鸣的10万亿模型去哪了?
前面提过,Seed2.1发布于6月23日。到11月12日,已经过去142天。
这142天里,腾讯、阿里、百度都没闲着,动作一个接一个。张一鸣身上的压力,显然不小。
其实年初还不是这个局面。
2月的LMArena榜单上,Seed 2.0的排名还在文心5.0之上。到了8月,第三方榜单给出的数字是:Seed2.1 Pro在全球大语言模型里位列第21。8月6日的年中全员会上,字节CEO梁汝波也松了口,承认大语言模型跟海外领先模型的差距有所拉大。
同样在8月上旬,10万亿的说法传开了。
按外媒的说法,字节正在预训练一个新模型,参数规模最高可能到10万亿,目前还在早期阶段,最终多大得看后续训练阶段才能定。
要知道,当时国内公开披露的最大模型是Kimi K3,2.8万亿参数;业内估算Anthropic的Mythos 5也不过8万亿。
有报道提到,这个项目整个训练周期预计3到6个月,最后发不发布还没定论。从8月上旬往后推,3个月就是眼下,6个月要到明年2月。
换句话说,它现在还没露面,谈不上迟到。
张一鸣还在全员会上讲过,Seed大语言模型用的预训练数据集,比顶尖对手小了几个数量级。
DeepMind在2022年的Chinchilla论文里总结过一条经验:参数翻倍,训练数据也得同步跟上。参数能堆,GPU能买——字节今年5月就讨论过把全年资本开支提到最高700亿美元。
偏偏数据这块补不上。
外媒此前报道,张一鸣在Seed全员会上明确表态,反对靠蒸馏外部模型来追赶,认为字节应当愿意“为长期目标牺牲一些短期利益”。Seed内部也用API检测和训练数据过滤两手,挡住第三方模型的输出流入训练集。
不抄作业,那就只能自己下功夫补课。
今年字节把散在各条业务线的数据团队拢到一起,新设了一级部门“AI数据与安全”,与Seed、Flow、抖音平级。
10月,影视飓风的Tim在内部交流中,演示了字节跳动还没官宣的世界模型。
该模型依托字节Seedance视频生成体系打造,能实现老电影自由运镜、虚拟场景实时交互、VR职业模拟等,主打云端渲染带来的沉浸式空间体验。
其实9月外媒就披露过,早已卸任日常运营的张一鸣,正亲自跨部门协调研发、算力与硬件团队,全程盯着这款实时世界模型的训练推进。
报道称,该项目被列为字节年度最高优先级之一,目标是做到50毫秒延迟、每秒20帧的交互效果,后续将适配Pico VR与抖音内容生态。
今年字节在世界模型和Coding等方向上的数据预算已达千万美元级,且还能继续追加。
不过字节的底子仍然稳,豆包依旧是国内用户规模最大的AI聊天应用,月活约3.24亿。
张一鸣此前在内部会议上说过,做模型得坚持长期主义、延迟满足感,不能拿别人的输出换一时的榜单排名。
那就慢慢等吧。