李曼玲团队发布EFE:用1156项任务考coding agent控制机器人

资讯 AI 行业观察 作者:学术头条 全文 2288 字 · 约 6 分钟读完 配图 7 张 分类合作智能体大模型

让机器人掌握一项新技能,通常有两条路径:人类为它编写程序,或者让它从数据中学习。如今,让由 LLM 驱动的 coding agent 直接控制机器人,成为了第三种可能。然而,coding agent 能否在物理世界的约束下可靠地控制多种机器人?现有基准尚未回答这个问题。 为此,华人科学家李曼玲、Ruohan Zhang

所属频道 模型发布智能体与 Agent合作与生态

想让机器人学会一门新手艺,一般就两条路:人给它写程序,或者让它自己从数据里学。现在多了第三种可能——让 LLM 驱动的 coding agent 直接去操控机器人。问题是,在物理世界的种种约束下,coding agent 能不能稳稳当当地控制多种机器人?现有的基准都还没给出答案。华人科学家李曼玲、Ruohan Zhang、石冠亚联合团队及其合作者(包括李飞飞、Dawn Song、Pieter Abbeel 等)为此提出了“具身的第一场考试”(Embodied First Exam,EFE)。这是一个统一、全面、agent 原生的评测框架,想弄清楚三件事:通用 coding agent 能解决哪些机器人任务、物理世界的约束会怎样影响它的表现、失败又发生在哪一步。
李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 1)

论文链接:https://arxiv.org/abs/2611.12177

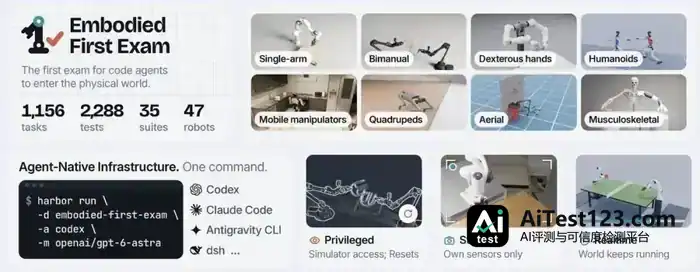
论文介绍,EFE 涵盖 35 个任务套件、共 1156 项任务,涉及 47 款机器人。其中 26 个套件由已有机器人基准改编而来,另外 9 个是新增套件,把评测范围从抓取和放置推到了空间谜题、灵巧操作、多机器人交互、动态全身控制,以及不同仿真环境之间的工程任务。
李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 2)

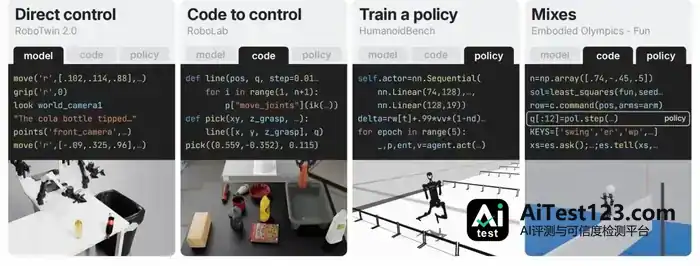
面对这些任务,agent 可以自己挑控制方式:直接输出动作、写控制程序,或者先训练策略再控制机器人。EFE 用一套统一的基础设施来支持不同模型与 harness 的组合,每次尝试的结果交给 agent 无法控制的验证器来判定。除了控制方式,EFE 还改动了 agent 观察环境和试错的条件。每项任务最多有 3 种评测设置,同一任务在不同设置下共用初始场景和成功判定规则。
李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 3)

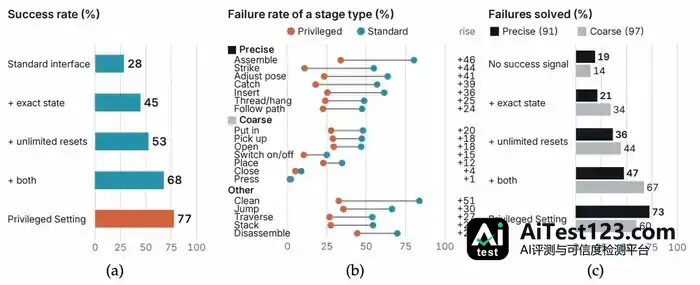
标准(Standard)设置下,agent 只能通过机器人传感器看环境,默认不能重置,不过仿真会在 agent 推理时暂停。实时(Realtime)设置保留了标准设置的约束,区别在于环境在 agent 推理期间照常运行。特权(Privileged)设置则把完整仿真状态和无限重置都开放出来,让 agent 能反复试错、搜索解法。团队把这一设置下的成功率看作近似上界,也把它当作生成训练数据的一条途径。

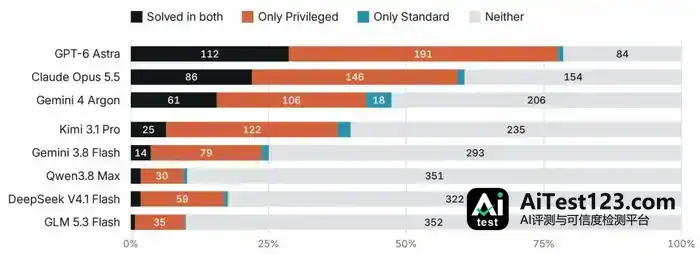
他们在 456 项高难度核心任务上评测了 8 个 coding agent。表现最好的是在 Codex 中运行的 GPT-6 Astra,标准设置下总体成功率 33.6%。团队又挑出同时具备标准和特权设置的 391 项任务做进一步比较:能访问完整仿真状态、无限重置环境时,GPT-6 Astra 的成功率达到 77.5%;只能靠机器人传感器观察、默认无法重置时,成功率降到约 30%。

李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 4)

李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 5)

围绕这个最强 agent 的控制实验,进一步拆开了状态信息和重置机会各自的作用。结果发现,增加无限重置比增加精确物体状态更能拉近两种设置之间的差距;两者同时给到,与特权设置之间的大部分差距就能补上。在需要精确操作的阶段,重置管用,只给精确状态则不管用。
李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 6)

环境如果在推理期间一直跑着,任务难度还会往上走。同一组 54 项任务里,标准设置下有 50% 的测试没有任何 agent 能解决;换成实时设置,这个比例涨到 63%。

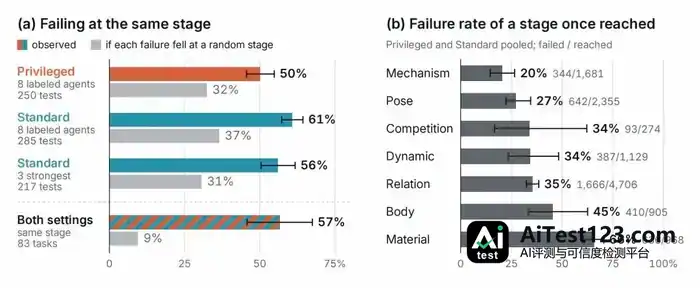
失败究竟卡在哪儿?团队按完成任务所需的世界状态变化把任务切成若干阶段。以把番茄放进关闭的冰箱为例,得先开门、再放番茄、最后关门。他们另找了一个独立的 coding agent,为 8 个受测 agent 在 427 项任务中的失败尝试逐一标出失败阶段。

结果看下来,同一个任务里的失败大多挤在相同阶段,而且常常就是第一阶段;特权设置和标准设置下的失败位置也基本对得上。需要改变材料、或者要挪动机器人身体的阶段,失败率最高。agent 能力越弱,就越容易在还没接触到目标之前就栽了。
李曼玲团队发布EFE:用1156项任务考coding agent控制机器人(配图 7)

图|上图为失败阶段的集中程度(按测试取平均);下图为两种设置下最常见失败阶段相同的任务占比,两种设置中该阶段都是第一阶段的任务已排除在外。

各个 agent 的本事也不完全重叠。标准设置下,最强的 3 个 agent 解出的测试有不小出入。harness 同样左右结果:换一个 harness,成功率最多能差 12 个百分点。

agent 挑的控制方式也会随条件变。标准设置里,它们基本直接操纵机器人;到了特权和实时设置,多数转为写控制程序。有个足球任务,在标准和实时设置中,系统一旦提供 GPU 和训练库,agent 就会去训练策略,而最后赢的也只有训练过的策略。

研究当然有局限。团队自己讲得很清楚:每个 agent 对每项测试只跑一次,阶段标签和控制方式标签都由 agent 生成,主要评测结果也全部出自仿真。只跑一次,没法分清哪种是反复出现的失败、哪种是偶发失手。仿真之外,真实机器人上表现如何,还得再测。

下一步,他们打算对每项核心测试多跑几次,把稳定复现的失败和单次运行的失误分开,并给不同 agent、不同设置之间的比较配上置信区间。实时设置里无人能解的测试占比最高,所以他们也会补充更多实时任务。

真实机器人评测同样在计划里。标准设置本就把 agent 的输入和操作框在机器人传感器读数和控制接口之内,只要任务结果能打分,这套接口就能直接搬到真实硬件上。他们已经演示过两个 agent 用真实机械臂玩电流迷宫游戏,接下来准备借这个接口,系统评估 agent 在真实机器人上的表现。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 腾讯押注WorkBuddy:Agent时代想抢操作系统级位置?

    Fast Reading 过去二十年,腾讯连接的是十亿级的人,现在要连接的,是企业里散落的工具、系统和数据。 不过,腾讯在Agent时代真正想争夺的,可能不是下一个微信,而是下一个操作系统级的位置。 连接,这张牌腾讯已经握了很多年。Agent时代,它终于有机会把它打向一场更深、更难,也更值得投入的硬仗。 过去二十年,一

    来源 AI 行业观察
  2. Muse登陆Apple Watch:个人Agent走进手表,AI硬件各寻出路

    北京时间11月10日一早,Meta宣布旗下Personal Agent产品Muse正式支持Apple Watch和Google Wear OS智能手表,一石惊起千层浪。 最直接的结果是,智能手表用户可以直接在手腕上通过语音、文字与Muse交流,交办任务、查看执行进度,Apple Watch还支持表盘快速唤醒。 Muse

    来源 AI 行业观察
  3. 荣耀700全系标配AI背屏:弱通知与AI Agent能否让背屏翻红

    手机行业断断续续试了近10年的背屏,在2026年终于等到了自己的黄金时代。 2026年11月9日,荣耀终端有限公司产品线总裁方飞发文,公布荣耀700系列全系搭载AI灵动背屏,就连入门定位的荣耀700S都…配备,同时荣耀也放出了完整的新机图片,部分线下门店甚至直接摆上了真机。 图片来源:荣耀 有一说一,作为一款还没发布的

    来源 AI 行业观察
  4. 蚂蚁灵波LingBot-Touch开源:近5000小时触觉数据,任务成功率最高90%

    蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的触觉感知。

    来源 TechWeb
  5. 蚂蚁灵波开源LingBot-Touch:近5000小时触觉数据预训练

    蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的触觉感知。

    来源 TechWeb
  6. 荣耀杨杰AICon演讲:ADD资产驱动开发如何让AI Coding端到端交付

    当 Agent 真正进入企业流程,哪些工作可以交给 AI ?50 + 实战案例揭晓答案! AI 正在从回答问题的辅助工具,走向理解目标、调用系统、完成任务的工作承担者。当 Agent 真正进入企业流程,问题不再是 “如何把 AI 做出来”,而是哪些工作可以交给 AI、结果如何验收、权限、成本与风险如何收住。随着大模型向

    来源 AI 行业观察
  7. openJiuwen发布ADF:让物理设备成为Agent可调用的能力

    今天的 Agent 已经可以写代码、查资料、调用 API、操作软件。当 Agent 逐步走出屏幕,会发生什么? 想象一下: 你不再需要分别操作门锁、空调、灯光和扫地机器人。家庭 Agent 可以理解家中设备的功能,在获得授权后按需组合调用;当某个设备临时不可用时,还能寻找替代方案,继续完成日常任务。 走进一间会议室,你

    来源 AI 行业观察
  8. AI Agent文件任务:交付可靠性成新难点

    (本文作者为 科技新星球,钛媒体经授权发布)文 | 科技新星球过去一段时间,AI产品的能力竞争主要围绕模型展开:参数规模、推理能力、上下文长度,以及生成文本和代码的质量。但当AI进入实际工作流程,评价标准正在发生变化。用户不再只问AI能不能写一段Python代码,而是会提出更具体的要求:把一个目录里的表格整理好,提..

    来源 腾讯网
  9. 蚂蚁灵波开源LingBot-Touch:触觉基础模型让机器人摸得更灵敏

    【TechWeb】11月10日消息,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进

    来源 腾讯网
  10. Claude Opus 5.5领跑WorkflowArena:长程任务完全解决率仅36.95%

    Einsia AI发布WorkflowArena基准,评测大模型在软件工程、法律等领域的多智能体编排能力。结果显示,即便最强的Claude Opus 5.5,面对复杂长程任务的完全解决率也不足37%。研究还发现,擅长执行任务的模型未必擅长编排,而优秀的编排策略能让弱模型性能显著提升。不同模型呈现出“谋定后动”与“小步快

    来源 AI 应用前沿
  11. Harness大战

    11月7日,微软发布了一份关于Agent执行系统的技术白皮书,包含一组有点出人意料的测试结果:同样使用Claude Opus 4.8,只换掉Copilot Studio背后的Harness,复杂任务通过率就提高了22.1个百分点。新系统每项任务调用模型的次数几乎翻倍,折算后的输入Token消耗却可以减少21%。 就在十

    来源 AI 行业观察
  12. AI短剧爆火,Agent也开始卷了

    界面新闻记者 | 佘晓晨界面新闻编辑 | 文姝琪 在2023年的时候,AI和短剧还是两个看起来没有太大关系的行业。一位AI内容创业者向界面新闻回忆,在当时的市场上,很少有人真正把这两件事结合起来——做AI的人看不上短剧,做短剧的人也不懂AI。在AI进入广告、影视等相对成熟的内容领域之后,短剧也没有成为技术创业者眼中的主

    来源 腾讯网
  13. 蚂蚁灵波LingBot-Touch开源:近5000小时触觉数据,26项真机测试

    IT之家 11 月 10 日消息,今日,蚂蚁灵波科技开源触觉基础模型 LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。 IT之家从官方介绍获悉,基于近 5000 小时真实触觉数据预训练,LingBot-Touch 覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,让积累的“手

    来源 AI 行业观察
  14. 腾讯元宝搜索上线:整条链路用大模型重做,so.qq.com可体验

    【TechWeb】11月11日消息,今日,腾讯正式发布面向C端用户的全新搜索产品“元宝搜索” 。据介绍,“元宝搜索”从召回、排序、网页理解到答案生成,整条搜索链路都基于大模型重新构建。 传统搜索主要依靠关键词匹配来判断网页与问题是否相关,而“元宝搜索”的做法,是基于大模型能力,先派出“AI先遣队”,替用户把每个网页认真

    来源 AI 行业观察
  15. 芯界光核应莺:光互联取代铜缆,超节点3个月融资数亿

    编辑 | 子钺图源 | 芯界光核AI越来越强,而限制它进一步发展的,不再是算力,而是算力之间传数据的那根线——线不好,算力可能只能发挥30%的作用。AI大模型需要几百上千颗算力芯片不停交换数据,数据交换的效率高不高,直接决定整个系统的计算能力。以前,这根线一直是铜的,可铜对于AI而言有个致命缺陷,它走不远,超过2米..

    来源 腾讯网
  16. openJiuwen双轨自演进框架:Agent换环境为何失灵?

    同样的大模型和工具,换个文件路径或数据格式,Agent就可能反复试错。openJiuwen发布的TTSE框架借鉴认知科学,将经验拆分为“环境事实”和“执行技巧”两条轨道。在ALFWorld等五个基准测试中,该方法显著提升了任务成功率并减少了工具调用次数。目前该机制已落地WorkSwarm办公智能体,实测显示在Excel

    来源 AI 应用前沿
向下滚动自动加载更多




