华为诺亚BEHAVIOR-1K夺冠:0.683 Q-score如何拿下第一?
在2026年BEHAVIOR-1K具身智能挑战赛中,华为诺亚方舟实验室团队凭借HiPhys-RSI方案夺得冠军。不同于业界主流的“大力出奇迹”式Scaling,该方案通过编程智能体积累可执行的结构化知识,在100项复杂家庭任务中实现了48.2%的完整成功率。本文解析其技术路径:如何让机器人像老工匠一样,通过试错和复盘,
冠军背后的反直觉路径
2026年11月,韩国举行的机器人顶级会议 CoRL 上,BEHAVIOR-1K Challenge 结果揭晓,华为诺亚方舟实验室具身智能团队 The North Star 摘得冠军。
这个冠军有点意思。全球57支参赛队伍中,他们在隐藏测试的100项家庭任务上拿到约0.683的Q-score,完整任务成功率则达到48.2%。去年第一届比赛,最佳完整成功率只有12%。今年参赛人数从96人涨到265人,任务难度也翻倍——从50项增至100项,场景从3个增至7个,可头部选手的表现却翻了四倍。

斯坦福大学李飞飞团队开发的 BEHAVIOR-1K 基准,被视作具身智能领域的“T0级”试金石。它不看瞬间动作,不像简单的抓取测试,而是要求机器人在几分钟内连续完成整理、清洁等长时序任务。高层推理、跨房间导航、双臂精细操作,得紧密配合起来。

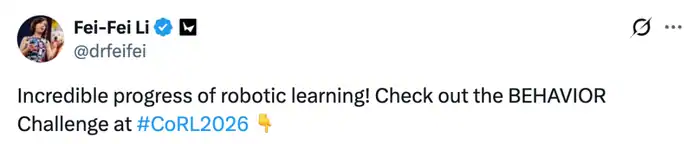
李飞飞也在社交媒体上谈到这次比赛的进展,邀请更多研究者关注。不过比起排名,华为团队提交的技术报告《Scaling by Structure: What Forms Can Scaling Take in Embodied AI?》抛出了一个更值得琢磨的问题:大模型已经能写代码、用工具了,具身智能的能力增长,是否只能靠堆算力和数据?

另一种 Scaling:把经验写成代码

过去几年,AI 的主流叙事是 Scaling Law——更大的模型、更多的数据、更强的算力。这套在语言和多模态领域很奏效,但落到机器人控制上,光靠端到端的神经网络,往往显得“不可控”。

华为团队走了另一条路:积累知识、规则和操作流程。他们提出的 HiPhys-RSI(分层物理递归自我改进)框架,核心思想是把“可执行程序”当作能力积累的载体。

换句话说,系统执行动作时,不再单纯依靠黑盒式的神经网络来输出。构建、检验并改进机器人执行流水线的活,交给了一个参数冻结的编程智能体(Programming Agent)。它建立在视觉语言模型(VLM)之上,但并不直接去驱动电机,它做的是写代码。

整个过程分三步:

第一步是读取与体验。智能体阅读任务说明,参考示范视频,再通过工具调用获得初步的交互经验。哪些操作有效、步骤之间有什么依赖关系、什么样的视觉反馈意味着任务推进了一步,这些它都得知道。

第二步是构建程序。经验被组织成明确的代码逻辑:感知输出如何转化为规划指令?控制器何时执行动作?失败后如何恢复?条件逻辑把这些连接起来。生成的流水线能自主执行,遇到异常则按自身的检查分支逻辑处理。

到了第三步,就是分析和迭代。执行完毕后,智能体会去看日志和视频:从日志里能知道调用了哪些函数,从视频里能看清物理世界真正发生了什么。比如抓取指令回报的是“成功”,可视频里物体还搁在桌面上,这种对不上的地方就成了改进的线索。接着智能体会找出出问题的模块,或者改工具的实现,或者调步骤的先后,再验证一遍。
整个过程中,编程智能体和 VLM 的参数都是冻结的,不需要重新训练。改进全部存储在可执行程序和结构化知识里。有效的改进被保留下来,成为后续任务可以调用的组件。
这就好比一个老工匠,每做完一个活都复盘哪里做得不好,把心得记在小本子上。下次遇到类似情况,直接翻本子,或者在此基础上微调。任务越多,本子越厚,解决问题的能力也就越强。
100项任务的实战表现
为了验证这套思路,团队在 BEHAVIOR-1K 的仿真环境里做了全面测试。评测覆盖100项任务,分移动取物、摆放分类、精细操作、工具使用、倾倒、设备操作和物体加工等八类。
对照实验设了三组,都基于2025年冠军方案的 VLA 设置:
- Meta-1-Epoch:在全部100项任务的示范数据上联合训练一个 epoch。
- Per-Task Post-Training:从上述检查点出发,对每项任务独立后训练,并引入深度信息等三维输入。
- Meta-2-Epochs:在全任务示范数据上联合训练两个 epoch。
结果显示,HiPhys-RSI 最终的混合系统在几乎所有任务上都优于这三组纯 VLA 方案。需要复杂逻辑的任务上,优势尤其明显。
有意思的是,训练轮次从1个epoch加到2个,带来的增益相对有限。逐任务后训练虽然提升了一些特定任务的表现,整体能力分布却没有本质变化。单纯靠数据喂养模型,边际效应在递减。结构化系统则通过显式分工——感知模块负责看,程序模块负责想,控制模块负责做——应对新任务时更灵活。
从“拼凑能力”到“发现策略”
结构化知识的增长不是一条直线。报告里的曲线把改进过程划成三个阶段。
头一个是快速提升期。这个阶段系统主要在拼“能力组合”。不少任务失败,原因不在某个动作不会做,而是步骤顺序搞错,或者工具挑错了。把这些配置改过来,系统很快就覆盖了大量基础任务。
接下来是平台期。好啃的骨头都啃完了,剩下的全是硬骨头。这时候再去调原有方案的参数,能拿到的收益已经很小。
最后是策略探索期。系统开始找出一些参考示范里没有的新解法。比如碰上不好抓的物体,它会先把物体姿态变一变,或者借环境支撑把操作难度降下来。
具体看几个例子:
- 锅柄难抓:锅柄被挡住、角度又刁钻的时候,机器人不再跟锅柄较劲,转去抓近侧的锅沿,让锅体保持水平,再搬到炉灶上。
- 独轮车搬运:把手被挡住时,机器人改从车轮一侧靠近,双手抓住前部车斗边缘把搬运做完。
- 喷壶启动:喷壶立着的时候很难按压,系统学会先把它放倒,再从侧面操作。
- 外卖打包:怕纸袋塌下去,机器人先把空纸袋立在盒子里,拿盒子当支撑,然后才放汉堡。
这些策略并非提前写死的,是智能体在试错中自己“悟”出来的。写进程序之后,它们就成了系统的永久知识。
暴露出的问题与局限
当然,这套办法也不是万能的。隐藏评测里,多数任务的 Q-score 出现下降,大部分降幅在0.2以内。系统有一定的跨实例迁移能力,但瓶颈仍然存在。
最疼的地方是搜索与导航。目标物体藏在看不见的位置,或者操作空间太窄,反复搜索和规划就会吃掉大量时间,最后超时。失败模式分析显示,HiPhys-RSI 主要栽在“抓取”和“超时”上,纯 VLA 基线则更多败在“放置”和“关节物体操作”上。
结构化方法还照出了评测体系的一些漏洞。比如“堆木头”任务,系统把木头两两配对接触,满足了评分规则里的“接触”条件,可预期的“堆叠”结构并没有形成。再比如在冰箱内切食物,系统拿到部分分数,后续的转移目标却没有完成。这些行为技术上“得分”了,但显然不合人类的意图。
这就提醒大家,成功的定义得再准确一些。系统能不能自己判断任务阶段和完成状态,也是一项值得单独评估的能力。
结构与模型的双向奔赴
HiPhys-RSI 有一个亮点:它没有把大模型丢掉,而是让结构化经验和模型训练互相咬合。
程序改进产生的执行轨迹(观察-动作序列),被混进基准示范数据里,用于 VLA 的逐任务后训练。也就是说,智能体探索出来的高效操作方式,变成了模型学习的新数据。训练出来的更强策略,又能反过来帮着搭建和执行流水线。
“结构+模型”这种双向协同,可能是具身智能往后走的一个重要方向。模型给的是泛化能力和感知理解,结构给的是逻辑约束和可解释性。两边一结合,纯端到端模型的不可控被绕开了,传统符号AI难以扩展的毛病也躲过去了。
华为团队这次夺冠,不只是一个排名的胜利,也是对具身智能发展路径的一次有力探索。它说明,算力之外,把知识结构化地攒起来,同样是通往通用机器人的一条可行之路。报告标题说得很直白:Scaling by Structure。结构化、可执行的知识不断积累和改进,具身系统的能力边界正在被重新划出来。