Anthropic冲IPO:1.5万亿估值与8.67亿股发行悬念
站在IPO关口,Anthropic开始向物理世界要增量
 Anthropic眼下正卡在一个颇为微妙的时点上。一边是充满变数的IPO考卷:估值虽说已收敛到约 1.5 万亿美元,可潜在投资者对这家公司巨额投入能换回多少回报,疑虑始终没散。路透社刚披露了一段耐人寻味的插曲——Anthropic曾给承销银行发去一份关键文件,里头写着约 8.67 亿股的发行规模、每股 70 至 80 美元的定价区间,按上限算对应约 693.6 亿美元的发行总额。
可文件发出之后,公司又火速撤回了相关定价信息,给出的说法是“并不准确,将另行更新”。
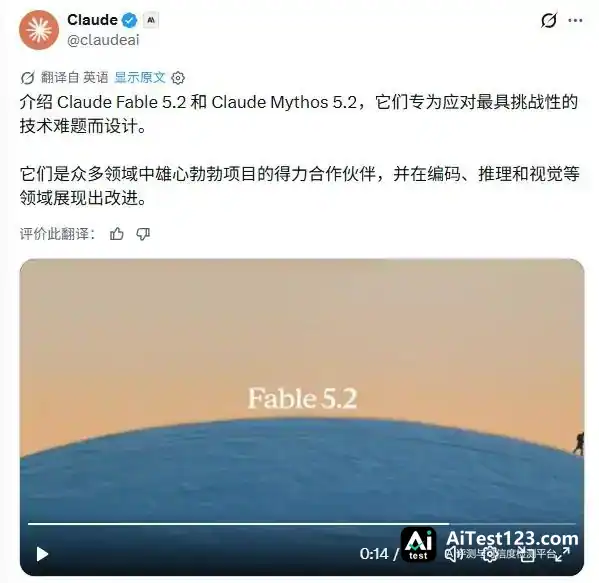
另一边,在资本市场的紧盯着之下,Anthropic亮出了筹备已久的技术底牌:新一代旗舰档位模型 Claude Fable 5.2 和 Mythos 5.2。两者的开放方式不同,Fable 5.2 带着网络安全和生物学领域的安全限制面向普通用户开放,Mythos 5.2 则主要提供给经过审核的网络安全和生命科学研究机构。
自主编程工程能力本是A社的传统强项,但这次多了一个新变量——朝物理世界与具身领域的渗透正在提速。
行业公认的权威基准、机械臂操作仿真 RoboDojo 上,Fable 5.2 的平均成功率跑到 64.9%。这个数字把上一代 Fable 5.1(27.6%)和 Opus 5.5(39.4%)都甩在了后头,还直接达到 GPT-6 Astra(29.8%)的两倍以上。
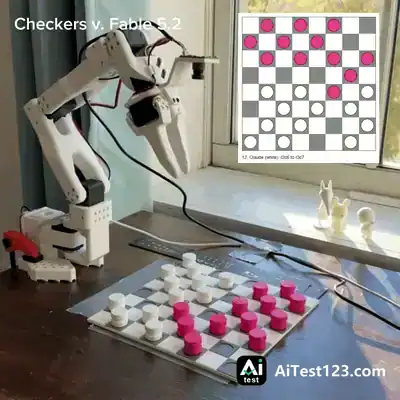
能力也在往现实里快速渗透。第三方开发者随后做了真机盲测,Fable 5.2 接管真实机械臂,完整下完一局 62 步的跳棋;过程中物理接触失误和硬件形变频频出现,它表现出的纠偏能力相当少见。
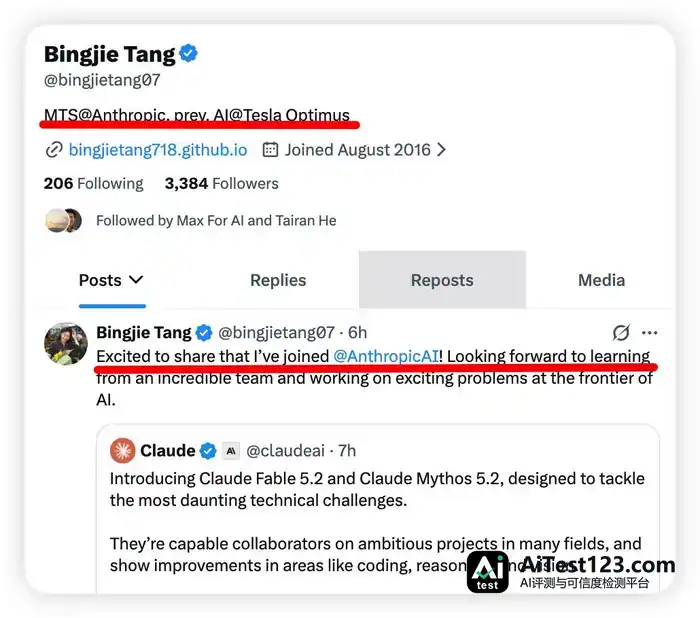
同一时间,前特斯拉  Optimus 团队灵巧操作工程师 Bingjie Tang 确认加入 Anthropic,身份是 MTS(Member of Technical Staff)。她在特斯拉期间长期做人形机器人基于学习的灵巧操作,数据采集、策略训练、模型评估、真实机器人部署都在她的工作范畴内;更早在英伟达机器人实验室,她研究的重点是接触丰富(Contact-rich)环境下的操作与仿真到真实迁移(Sim-to-Real)。
人才流动其实不是偶发动作。回看过去一年,Anthropic 在物理世界铺开的测试链条相当清晰:
2025 年启动 Project Fetch,先让 Claude 帮非机器人专家编程操控机器狗,接着又测试模型自主连接设备、读取传感器、执行任务的本事;
2026 年 7 月发布《Claude Plays Robotics》研究,测试范围扩到机械臂、四足机器人和人形机器人,探索通用大模型如何靠视觉感知、任务规划、调用运动策略来控制机器人。同月推出的 Project Pilot 把实验对象延伸到无人机,测的是自主导航与目标追踪。
8 月发布的 Model Hardware Standard(MHS),试图为 AI 操作显微镜、机械臂这类物理设备建立统一接口。
看得出来,Anthropic 已经不满足于让 Claude 只在软件环境里干活。往物理世界试探,说到底是一场被商业现实倒逼出来的边界突围。
眼下正处筹备上市的关键节点,资本市场对 Anthropic 高达 1.5 万亿美元估值的审视越来越严苛。整体营收还在狂奔,可第三季度环比增速已从上一季度的 144% 明显放缓到 47%。巨额算力投入又压着毛利,只靠屏幕内的 API 调用和企业软件订阅,正肉眼可见地撞上增速天花板。
Physical AI 的战略权重,就是这么被迅速抬上去的。
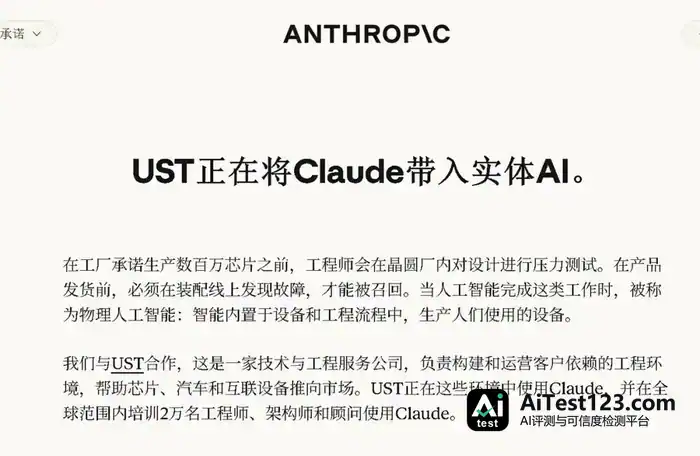
联手工程服务商 UST,把 Claude 嵌进芯片制造与汽车产线的实际研发;推出 MHS 规范,直接调度科研仪器与工业设备;再到眼下 Fable 5.2 机器人仿真跑分翻倍、前特斯拉 Optimus 灵巧操作工程师 Bingjie Tan 火速入职——Anthropic 想向投资者证明的是:Claude 不会止步于聊天框里的智囊,它有成为物理生产力执行核心的可能。
具身业务短期内还难挑业绩大梁,但行业竞争重心的偏移是明摆着的事实:大模型不再满足于“回答问题”,而是要“接管工作”。
按“最终交付结果”算账的逻辑,同样延伸到了软件开发端。Fable 5.2 身上随即出现一个颇具戏剧性的反差:它的 Token 标价是 Opus 5.5 的整整两倍,可在高难度工程任务里,实际交出的成本账单反而便宜了一半。
跑分倍超 GPT-6 实测学会纠偏
今年 9 月,GPT-6 Astra 在机器人仿真领域引发的那场讨论,还记得吗?
论文《An Unexpected Robot Policy》当时展示了一个颇有冲击力的方向:每项机器人任务不必专门训练策略模型,通用大模型靠视觉观察、推理和动作接口,也能直接参与机器人控制。不少人因此开始重新审视通用大模型与专用具身模型之间的关系。
如今,Anthropic 把这项成绩又大幅往前推了一步。
官方公布的 RoboDojo Sim 测试中,Fable 5.2 为 64.9%,GPT-6 Astra 为 29.8%,自家上一代 Fable 5.1 为 27.6%,Opus 5.5 为 39.4%。
换算下来,Fable 5.2 是 GPT-6 Astra 的 2.18 倍,是 Fable 5.1 的 2.35 倍。
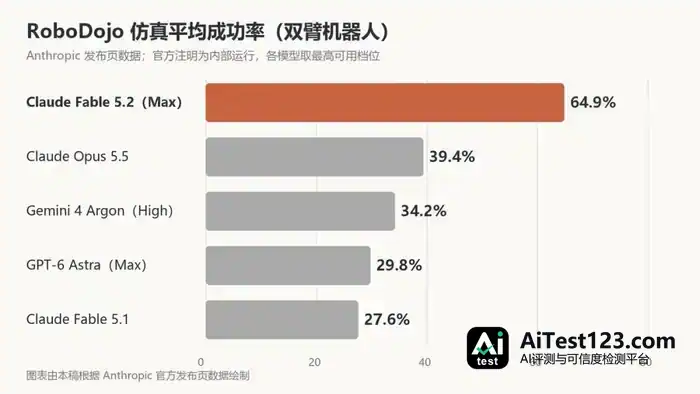
图源:Anthropic。上面这组 RoboDojo Sim 成绩,是 Anthropic 内部跑出来的,每个模型都取了自身可用的最高推理强度。
RoboDojo 不考概念理解,考的是从头到尾把任务做完:只给摄像头拍到的连续画面,模型得自己判断机械臂每个关节怎么走、抓取时用多大力。64.9% 的平均分说明它已经不再靠“碰运气”试错,跨场景规划连续动作开始稳得下来。
官方放出的真机演示里,Fable 5.2 没有针对具体任务做过微调,却完成了摆弄益智方块、拧开瓶盖、拿笔在纸板上画简笔画这些精细活。

第三方开发者的无滤镜实测,则进一步摸到了 Fable 5.2 泛化能力的上限。开发者 Karolina Dubiel(@karolina_dubiel)把 Fable 5.2 直接接到一台真实物理机械臂上,让它在真实桌面上跟人下完一整局跳棋。
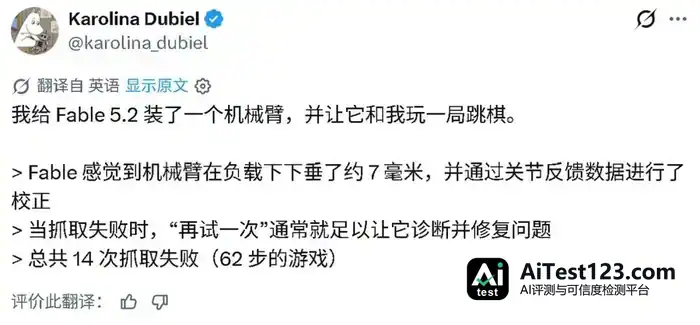
这种对抗测试看着简单,实际是在跟真实物理世界的粗糙和不可控较劲。先说容错:整局棋 62 步动作里,桌面反光、棋子轻微挪位、抓夹摩擦力不够,让机械臂先后 14 次抓脱或抓偏。没人重写代码,测试者只用自然语言说一句“再试一次”,Fable 5.2 就能结合视觉回传自己复盘上一步为什么失败,重新算抓取角度再试。
再看物理反馈感知与动态补偿:机械臂带负载伸展时,末端受重力和机械间隙影响下垂了约 7 毫米。面对这种没预设过的形变,Fable 5.2 没有死板执行原来的理论空间坐标,而是读取关节传感器回传的扭矩与位移遥测数据,在后续动作里自行叠加补偿偏量,把棋子准确落下。
不过 Dubiel 的测试也把当前方案的短板摆了出来。她在评论区补充,整局对弈实际花了约 46.5 分钟,平均每步约 45 秒;公开视频经过数倍乃至上百倍加速,真操作远没有视频里那么顺。
名义 Token 贵一倍 为何交付成本反砍半?
商业端上,Fable 5.2 造出一个表面上的定价悖论。它 API 输入每百万 Token 8 美元、输出 40 美元,比上一代降了 20%,但仍是主力模型 Opus 5.5 的整整两倍。按常规逻辑,单价翻倍,研发成本自然水涨船高。
可到了多项真实工程测试里,账本却往反方向走:
代码合并基准 FrontierCode 2.0:Fable 5.2 只开到 High 推理档位就跑到 45.3%,打平 Opus 5.5 最高档位的 45.5%,单任务总成本直接少约 50%;堆到 Xhigh 档位,成绩冲到 49.1%,把 GPT-6 Astra(42.8%)甩在后面。
知识与图表任务:在 Perplexity WANDR 大规模信息收集和 Chartography 图表基准中,Fable 5.2 分别用 Opus 5.5 约 40% 和不到 10% 的单任务成本,拿到相同甚至更高的准确率。
成本倒挂的根子,在于“一次通过率”(First-pass Yield)对算力消耗的降维打击。社区开发者实测把这个差距摆得很清楚:做 3D 潜艇场景时,Opus 5.5 花了 6 小时 40 分钟,还得人频繁介入纠错补细节;Fable 5.2 只花 1 小时 26 分钟,几乎一次成型。
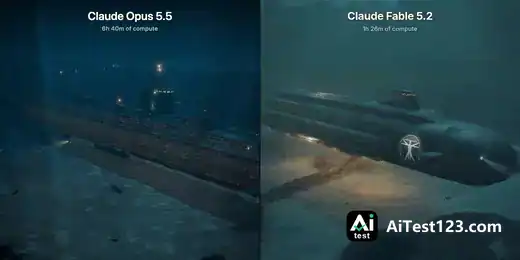
多轮嵌套的复杂工程里,传统大模型最烧钱的地方从来不是单次输出的 Token 标价,而是逻辑断点带来的无限次上下文返工、调试回溯,以及人类工程师搭进去的时间。
当然,这套优势不是哪儿都适用:系统操作测试 OSWorld 2.1 中,Fable 5.2(89.3%)只比 Opus 5.5 领先 2.1 个百分点;业务流 AutomationBench 里,它甚至以 51.4% 落后于 Gemini 4 Carbon 的 53.9%。换句话说,处理基础表格和浅层系统点击,Fable 5.2 可能是性能过剩的高价工具;但到了需要高容错、深度逻辑自洽的深水区,它是个能帮你省掉几十轮无效调试的熟练工。
智能体临界点:超长推理周期
代码和机器人测试展现的是局部生产力,而极限工程实验里,Fable 5.2 第一次让大规模智能体集群持续运转有了工业可用性。最典型的验证是费马大定理的形式化转写:Anthropic 调度约 1,000 个 Fable 5.2 智能体,在少有人工干预的环境下,仅用约 30 小时就用 Lean 语言走完定理形式化全流程,此前系统要耗 11 天。
任务推进到中后段,一组对照更能说明问题:连跑 18 小时后,Fable 5.2 的完成度已到 86%,Opus 5.5 只有 26%;再往后推到 30 小时,Fable 5.2 平稳收敛、跑满 100%,Opus 5.5 却勉强挪到 27%,卡进逻辑死锁出不来。

这种能在极深推理网络里顶住上下文漂移、绕开逻辑死循环的本事,也被直接搬进了真实工程开发。
白纸起步搭系统:给它的只是一个空文件夹,工程师调来 1,000 多个子智能体连轴转了 8 天,最后交出一套能用的笔记本操作系统原型——内核、驱动、文件系统、窗口交互齐全,还内嵌了 Claude。

底层架构换语言:另一组智能体把某个关键生产服务从 Python 整体改写成 Rust,上线之后,服务启动速度提高到原来的 26 倍。
软硬件一路打通:只给需求描述,它就和 Diode 联手做出三款实体电子产品,器件选型、画电路板、外壳 3D 建模、固件烧录一次走完,硬件打样回来不用改电路就能通电运行。
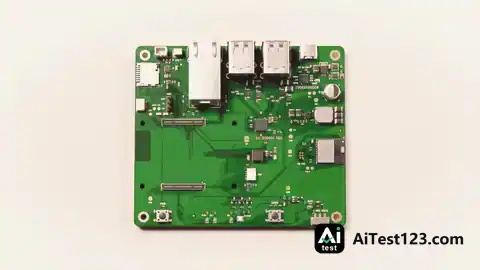
多 Agent 协作这件事,行业里谈了不少年。可工具链调用几十次之后,误差一层层叠加,整个系统就容易出现幻觉雪崩。Fable 5.2 带来的技术增量,正是把长程任务的容错阈值往外推了一大截。
结语
从屏幕里连续 8 天推理底层系统,到物理世界中让机械臂末端自己做自适应校正,眼下冲击二级市场的 Anthropic,显然已经不满足于只当一个高溢价的软件 Copilot。
资本市场盯着它的时候,它正在讲的新故事,是一个走向实体生产力的自主执行单元。