Salience获1.25亿美元融资:全光交换OCS能把延迟压到10ns?
光互联与光交换,推动AI计算架构重构
AI集群的GPU数量已经冲到数百乃至数千颗,系统跑得快不快,越来越看GPU之间搬数据的效率。铜互连在带宽密度、传输距离和功耗上卡得越来越紧,光互连功耗更低、带宽更高、还能拉长距离,正在加速进入AI算力中心。
问题是,眼下多数主流AI算力中心仍靠电子交换机转发数据:光信号进交换机后先做光电转换、再走电子交换、最后重新变回光信号送出,延迟和功耗反而被抬高。Salience Labs(下称Salience)想从交换层动手,它做了一套基于硅光的全光路交换机(OCS),光信号进到交换层后一直留在光域里,直接在端口之间完成光路切换。
首款32端口OCS的单跳延迟不到10ns(纳秒)。博通旗舰级以太网交换芯片的延迟约250ns,前者只有它的二十五分之一;其他高性能以太网交换机通常为450-650ns,差距更大。
近日这家公司完成了新一轮1.25亿美元融资,由Bullhound Capital领投,AMD Ventures、Intel Capital、SBI Group、Hudson River Trading和British Business Bank参投;Applied Ventures LLC、Oxford Science Enterprises、Cambridge Innovation Capital及Silicon Catalyst Ventures等老股东继续跟投。
更早之前,Salience拿过1150万美元种子轮和3000万美元A轮,投资方中有ICM HPQC Fund、Temasek(淡马锡)前董事会成员Yew Lin Goh等。
全光硅光OCS,将交换延迟从数百纳秒降到10纳秒
Salience从牛津大学和明斯特大学分拆而来,核心创始团队包括CEO Vaysh Kewada和CTO Johannes Feldmann。Kewada在帝国理工学院拿到物理硕士学位,之后在McKinsey任职多年,是公司商业侧的核心角色;Feldmann曾在牛津大学Harish Bhaskaran团队做博士后,公司第一颗原型芯片由他设计并测试。
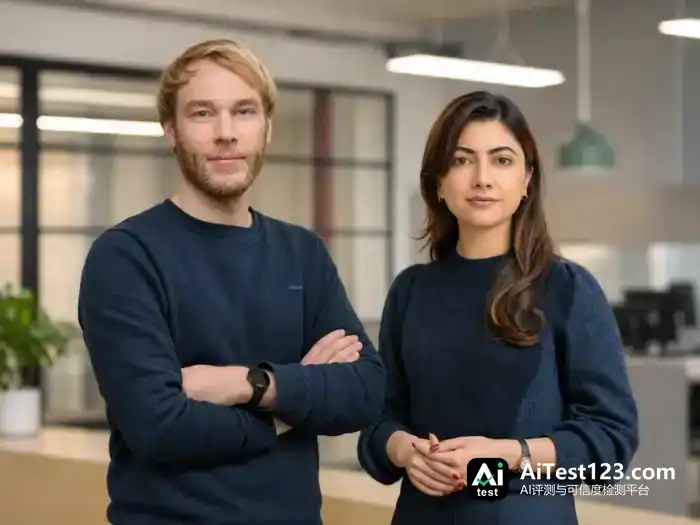
Vaysh Kewada(CEO)和Johannes Feldmann(CTO),图片来源:Salience Labs
Harish Bhaskaran和Wolfram Pernice是公司的学术创始人。Bhaskaran曾任牛津大学教授,长期研究相变材料、纳米制造以及光子/类脑计算;Pernice是集成光子学专家,也是莱布尼茨奖获得者。
Salience刚入行时的核心技术是相变光电子学(phase change optoelectronics),当时团队想用“存上计算”架构做AI计算芯片,把光子学的超高速率、电子学的灵活性和CMOS工艺的可制造性揉在一起。
到2025年,公司把重心转向连接AI集群的光子交换机。创始人Vaysh Kewada解释,这一转变很大程度上是客户需求在转移:AI集群扩张太快,数据移动和网络基础设施慢慢成了新的瓶颈。另一边,CPO(Co-Packaged Optics,共封装光学)、NPO(Near-Packaged Optics,近封装光学)等技术让光连接在AI算力中心里更好用,不少公司都在往这个方向投,Salience则凭自己的技术底子盯上了一个问题:数据中心里的光连接越来越多,这些光信号该怎么交换。
注:CPO和NPO都是让光引擎进一步靠近交换芯片或GPU的封装方案,以缩短高速电信号传输距离、降低功耗并提升带宽。
到B轮融资时,Salience拿出的是一套面向量产的集成硅光OCS方案,搭载在首款产品OC-32M上。
这次转向背后,是AI算力中心及其连接需求在快速膨胀。GPU数量、机架功率密度一路往上走,交换层的延迟、功耗和光模块成本也跟着快速增加。Dell’Oro Group预计,2026年至2030年,AI后端网络数据中心交换机的累计支出将接近1万亿美元。
OCS(Optical Circuit Switch,光路交换机)可以理解为给光信号“直接改道”的设备。传统电子交换机得先把光信号转成电信号,判断数据往哪走,再转回光信号发出去;OCS直接在光域里建一条从输入端到输出端的通路,数据顺着这条光路走。
OCS本身不算新技术。传统产品多用MEMS微镜,靠电信号控制微型反射镜角度,把输入光束直接偏转到指定输出光纤;Google等公司已把这类方案用在数据中心,但重新配置一条光路通常要毫秒级时间。
Salience的做法是把光路交换直接集成进硅光芯片,重配置时间缩短到300微秒以内。比起机械式OCS,硅光集成还有个好处:能借半导体制造工艺提升可制造性,大规模量产后每端口成本也能降下来。
不过硅光集成也带出一个直接问题:损耗。光在芯片内部过波导和多个交换器件时会不断衰减。Salience的应对是两颗芯片:一颗全集成硅光OCS芯片负责片上光路交换,另一颗自研的阵列式光放大和信号调理芯片负责补偿片上损耗,两颗芯片背靠背装在PCB上。创始人Kewada把这颗光放大芯片称作整个技术栈的核心。
 Salience的这颗芯片。图片Salience Labs
这家公司的第一款产品叫OC-32M,是一块32端口的全光硅光OCS。每个通道最高能跑200Gbps,换算成理论原始数据速率大约25GB/s;端口到端口单跳延迟不到10纳秒,而高性能以太网交换机一般处在数百纳秒的量级。
 图片来源:Salience Labs
在一项用576颗GPU运行Megatron 2T模型的模拟里,Salience给出的结果是:网络延迟降下来之后,单用户每秒Token吞吐量最多能提升80%。
 图片来源:Salience Labs
64端口版本已经演示过了,接下来公司打算在同一套架构上做到128端口和256端口。
跟传统电子分组交换机比,OC-32M最突出的一点是去掉了交换机侧的光-电-光(OEO)转换,连带着也省掉了相应的光收发器,数据直接在光域里完成交换。光电转换和数据包处理带来的延迟因此减少,高速收发器的功耗和成本也一并省下;网络带宽和规模越往上走,这部分节省就越明显。
但OCS替代不了电子交换机。它擅长的是提前建好一条能维持一段时间的光路,电子交换机那种针对每个数据包实时决定转发路径的做法,它做不来;OCS自身也没有电子交换机那样的缓存能力,节点之间的连接得靠外部系统提前调度。
所以两者更可能是长期并存的关系:短小、突发、随机变化的流量交给电子交换,高带宽、通信关系相对稳定、可以提前预判的任务则适合OCS。AI训练和推理中大量GPU通信正好是结构化、同步性强的,这也是OCS重新被关注的关键原因。
Salience的产品先盯的是AI集群的纵向扩展(scale-up)。NVIDIA和AMD的高带宽scale-up域眼下大多还局限在单机架之内,Salience想用低延迟OCS把更多GPU或其他XPU跨机架连起来,把一致性内存域做大。
注:所谓 Scale-up,指的是在一个 AI 计算系统内部,把更多 GPU/XPU 用高带宽、低延迟的互联方式连起来,让这些芯片像一台规模更大的机器那样协同运转。
到了横向扩展(scale-out)网络,Salience给OCS安排的是分担部分汇聚层工作和集群重构任务。光路能随不同工作负载重新配置,GPU集群在训练、推理或资源重新分配时可以调整连接关系,更细粒度、变化更快的数据流量仍旧留给电子分组交换机。
注:Scale-out指通过网络连接更多服务器、机架和计算节点,把多个相对独立的计算单元扩展成更大的AI集群。
商业化方面,Salience已与Tower Semiconductor合作制造硅光芯片,靠对方的硅光工艺平台推进预量产和规模化生产;测试环境则是和Keysight一起搭的,用来验证性能、互操作性和大规模部署能力。
光互联与光交换,推动AI计算架构重构
OCS这条路上,推进产品和技术的公司不止Salience一家。
iPronics不久前完成1.25亿美元B轮融资,NVIDIA也参与了投资。它的32端口ONE-32走集成硅光路线,单跳延迟低于30纳秒,重配置时间低于300微秒,并且已经与Fabrinet推进专门的封装、组装和测试产线。
Lumentum走的是传统MEMS路线,R300已经做到300×300端口,典型插损约1.5dB,MEMS微镜累计运行时间超过1万亿小时。
PsiQuantum展示的是一款8×8硅光OCS,没有用光放大器,典型插损1.2dB,重配置时间低于3毫秒。
把这几条路线和Salience摆在一起看,OCS往后拼的是几项指标:端口规模继续做大、插损进一步压低、重配置时间缩短、功耗和每端口成本降下来。
视角再放大一些,光互联会朝几个方向推进。
一是Scale-up从单机架走向多机架,用光连接把数百甚至数千颗GPU/XPU放进同一个低延迟、高带宽的计算域。
二是已经大量使用可插拔光模块的Scale-out网络,会继续抬高机架和集群之间的带宽密度,同时把每比特传输的功耗降下去。
封装与集成方式也在往更贴近交换芯片或GPU的方向走,可插拔模块之后,OBO、NPO、CPO等形态会陆续登场。再往远处看,Optical I/O以及2.5D、3D光子中介层同样被列为方向。
光网络自身的可编程程度会越来越高。短期内的着力点,是用软件动态调整网络拓扑和光路;再往前一步,则是在部分架构里把波长和带宽放到一起调度,并让它们与电子分组交换网络配合运转。
放到光互联产业整体来看,创业路线大致能分出几条:光继续挺进GPU、内存及其他计算芯片附近;光网络从单机架走向多机架、走向更大规模的集群;封装、制造、测试和网络控制这些能力也跟着一起升级。