

安纳智芯AX100流片:单次矩阵方程求解不到100纳秒
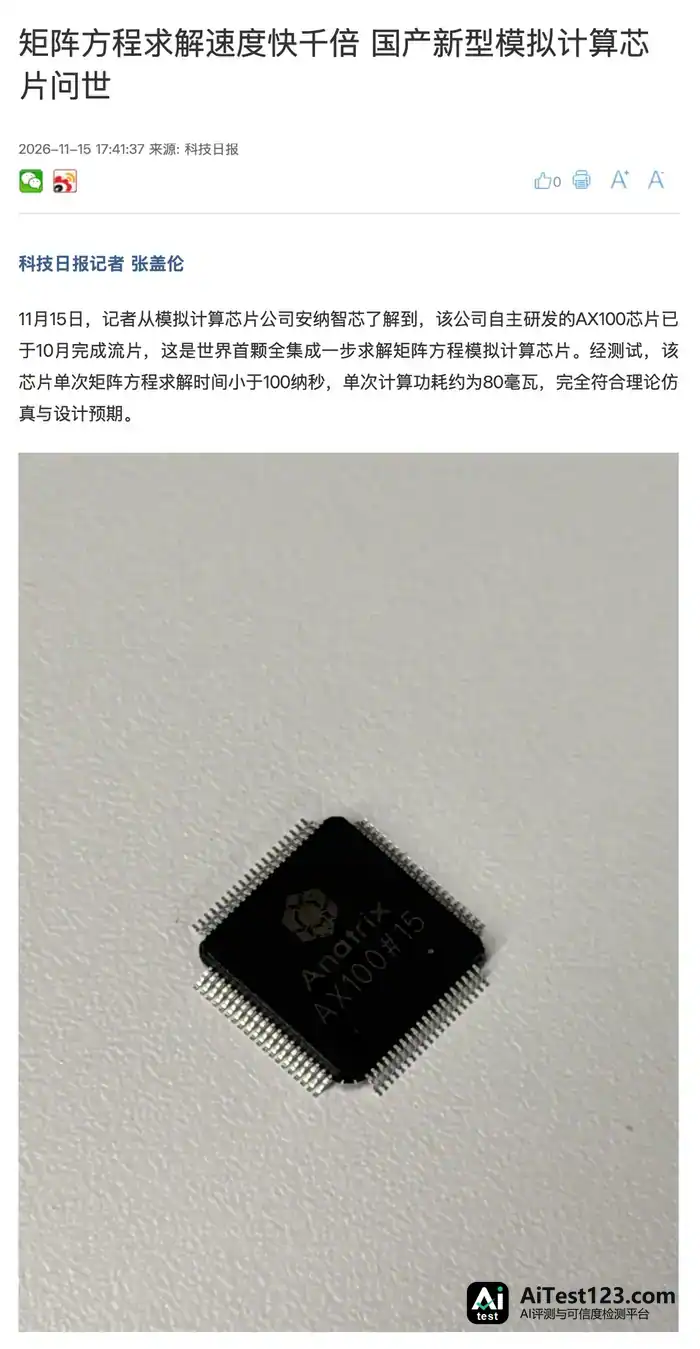
IT之家 11 月 15 日消息,据科技日报从模拟计算芯片公司安纳智芯了解到,该公司自主研发的 AX100 芯片已于 10 月完成流片,这是世界首颗全集成一步求解矩阵方程模拟计算芯片。 经测试,该芯片单次矩阵方程求解时间小于 100 纳秒,单次计算功耗约为 80 毫瓦,完全符合理论仿真与设计预期。 据介绍,我们熟悉的
据科技日报从模拟计算芯片公司安纳智芯处了解,这家公司自己研发的AX100芯片已在10月完成流片。11月15日消息,这是全球首颗全集成、一步求解矩阵方程模拟计算芯片。
测试结果显示,该芯片求解一次矩阵方程用时不到100纳秒,单次计算功耗约80毫瓦,与理论仿真和设计预期完全吻合。
按介绍,大家熟悉的AI大模型训练参数优化、机器人动作控制与空间规划、通信基站信号处理,说到底都是在解复杂的矩阵方程。数字芯片走的路子,是把“求解”变成海量乘加迭代,计算量随矩阵规模按立方级往上走——拿512阶矩阵方程求解来说,大约要5亿次乘加,耗时数十至上百微秒。模拟计算则直接借物理定律做并行运算,延时低、功耗低,在算力受限的局面下有先天优势。安纳智芯CEO向锐的说法是,“矩阵方程被直接映射为电路,电路自平衡后一次读出结果,无需迭代。”
问题在于,怎么让模拟计算既可靠又能扩展,进而在现代计算任务里发挥先天优势,这是全球科学界头疼了很多年的世纪难题。2025年10月,北京大学人工智能研究院研究员孙仲团队在《自然・电子学》发文,把模拟计算的精度从之前的百分之一量级提到千万分之一量级。当时有学者评论说,孙仲的研究“复活”了模拟计算这个长期被忽略的领域。
论文正式发表到现在才一年,靠国内成熟的芯片制造封装产业链,安纳智芯把孙仲团队的技术从实验室搬到了产线上。
芯片已在三种场景下做过测试。大模型训练方面,团队用293万参数的Autoencoder模型和272万参数的Transformer模型验证,对应实验中采用的二阶优化方案让两类模型的训练更新消耗分别少了92%和56%。具身智能方面,芯片能提升机器人实时计算能力,运动控制与规划端到端算法提速150%到500%,三维重建与SLAM(实时定位建图)核心算法环节提速200%到500%。无线通信方面,评估结果显示,对128×128规模的信道格拉姆矩阵,模拟计算芯片的等效吞吐比现有数字ASIC芯片与GPU提升20至207倍,等效能效提升27.6至61.3倍。
据悉,该芯片的制造不依赖先进制程,用当前成熟工艺就能做到全链路自主可控。
向锐表示,“AX100芯片和GPU类数字芯片在架构和底层逻辑上完全不同,且具备现代模拟计算顶尖计算能力,有望实现芯片领域的‘开道超车’。”他说,这是中国企业第一次有机会参与定义一种重要计算范式,将为广泛的矩阵方程求解需求提供全新且更高效的计算底层硬件。
















