英伟达AI内存全栈设计:Agent吞吐量升30倍,HBM只增3%

资讯 快科技 全文 2831 字 · 约 8 分钟读完 配图 4 张 分类HBM英伟达模型发布智能体存储

快科技11月6日消息,英伟达发布博客文章,详解其AI内存全栈协同设计策略。文章强调,随着大模型参数规模、上下文长度和智能体(Agent)应用持续扩张,AI基础设施的内存压力正在加剧,单纯增加GP

所属频道 模型发布算力与芯片智能体与 Agent

11月6日,英伟达发布博客文章,详细介绍了其AI内存全栈协同设计策略。文章提到,大模型参数规模、上下文长度和智能体(Agent)应用都在持续扩张,AI基础设施面临的内存压力随之加剧,光靠增加GPU内存容量已经不够用了。

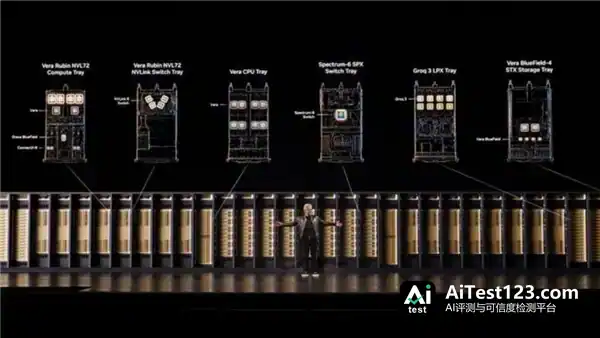
按照英伟达的设想,要把GPU、CPU、网络、存储和软件放在一起做协同设计,再配合模型权重量化、KV Cache压缩与分层存储、检索数据优化等手段,提升整个AI基础设施的内存利用效率。

英伟达披露了一组对比数据:从Blackwell Ultra到Vera Rubin平台,单颗GPU的HBM容量只增加约3%,而在特定Agent工作负载下,每美元可实现的吞吐量最高能提升30倍。
英伟达详解AI内存全栈协同设计:Agent吞吐量提升30倍 HBM容量仅增3%

这套策略的关键,是把AI工厂的内存和存储看成一个整体的数据层级,而不是一味把更多数据塞进速度最快、成本最高的GPU内存,用更低的单位成本处理更多AI任务。英伟达同时指出,大模型参数规模越做越大,上下文窗口越来越长,Agent还要在多轮推理和工具调用之间持续保留历史信息,GPU高带宽内存(HBM)承受的压力正不断加大。

推理过程中,KV Cache(键值缓存)是重要的内存消耗来源。它保存模型处理请求时已经算过的上下文信息,让模型后续生成内容时不必重复处理相同信息。对Agent来说,一次任务可能涉及多轮模型推理、工具调用和结果返回,历史上下文不断累积,KV Cache也跟着膨胀。
英伟达详解AI内存全栈协同设计:Agent吞吐量提升30倍 HBM容量仅增3%

英伟达称,部分Agent任务轨迹涉及的处理上下文规模已经达到300万Token。检索增强生成(RAG)同样会推高需要处理和保留的数据量——它要把企业文档转成向量表示,并在模型推理时检索相关内容。

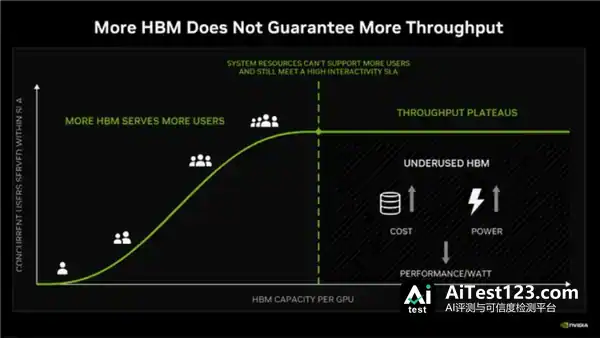
英伟达强调,推理时模型权重和KV Cache都要占用HBM,而HBM恰恰是AI工厂里速度最快、成本最高、供应也最受限的内存层级,单纯加HBM容量解决不了所有问题。英伟达打了个比方:HBM像仓库,内存带宽像仓库的装卸码头,仓库再大能装更多货,可装卸速度跟不上,增加仓储空间也提不高实际吞吐量。

在AI推理中,HBM更多确实能容纳更多用户的模型工作负载和KV Cache,但所有用户仍要共享GPU计算资源和内存带宽。一旦计算能力或带宽成为瓶颈,多出来的内存容量就可能用不上,反而推高成本和功耗。所以英伟达认为,真正要紧的不是单纯加内存容量,而是让不同类型的数据进入最合适的存储层级,需要时及时调回GPU,把整个系统的利用效率提上去。

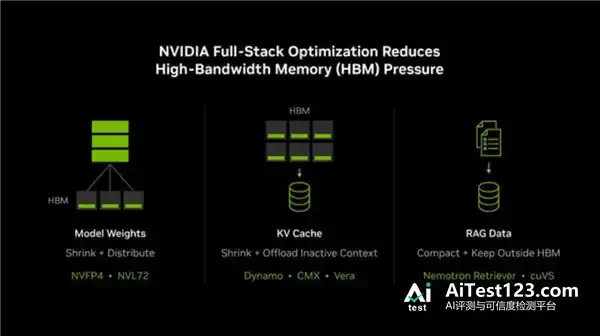
模型权重占用大量HBM的问题,英伟达的办法是用NVFP4低精度格式压缩,并借助NVLink实现跨GPU分布式存储。具体来说,NVFP4能把模型权重压到4位精度,相比FP8进一步节省存储空间。
英伟达详解AI内存全栈协同设计:Agent吞吐量提升30倍 HBM容量仅增3%

据英伟达介绍,采用NVFP4格式发布模型权重的模型开发商越来越多,Black Forest Labs、Thinking Machines Lab、Reflection、Meta等机构和公司的部分模型就在其中。

硬件层面,英伟达用NVLink搭建了NVL72机架级GPU互联系统,模型权重可以分布在最多72颗GPU上,单颗GPU只存模型的一部分,腾出的HBM空间用来放KV Cache、服务更多并发用户。说到底,英伟达是想靠低精度量化和机架级互联一起解决模型权重占内存的问题,而不是只让单颗GPU不停加HBM容量。

相比之下,KV Cache带来的挑战更动态。Agent持续推理、调用工具、等待外部结果的过程中,部分上下文要保留,但并非所有信息都得一直占着最快的GPU内存。对此英伟达从压缩、暂存和分层卸载三个方面优化KV Cache。

其一,NVFP4也能用来压缩KV Cache,相比FP8减少内存占用,让更多上下文留在GPU的HBM里。其二,Vera CPU负责加速工具调用,缩短Agent等待外部工具执行结果时KV Cache闲置的时间;Vera CPU还配有大容量LPDDR内存,通过NVLink-C2C与Rubin GPU连接,为暂时不活跃的上下文提供离GPU较近的存储空间,需要时再快速调回。

其三,英伟达Dynamo推理软件能把暂时不活跃的KV Cache从GPU内存卸载到CMX上下文内存存储平台。CMX是面向大容量、低成本数据存储设计的层级,每比特存储成本远低于HBM,并能在上下文再次被调用前把数据调回。和本地SSD不同,CMX可以跨服务器共享;和传统企业存储不同,它不必为这些短生命周期的上下文承担长期数据保护带来的额外开销。

另外,Dynamo的KV Cache Reuse功能把GPU内存、CPU内存和存储中的KV Cache当作一个系统级资源统一管理,已经计算过的上下文可以在整个系统内复用,减少重复计算。

模型权重和KV Cache之外,英伟达还盯上了检索增强生成(RAG)给内存带来的压力,并给出了一套优化方案。

RAG的做法,是先把企业文档转成向量嵌入(Embedding),再建起可供检索的向量索引,让模型能根据用户提问,从庞大的知识库里挑出相关信息。问题是,这些向量数据要是全塞进GPU的HBM,模型推理本身那点宝贵内存就更紧张了。

英伟达的思路是分头处理:向量数据的存储交给NeMo Retriever,索引的存储交给cuVS。

NeMo Retriever模型能生成更小的向量嵌入,检索准确性还更高,需要存储和传输的数据量随之减少。cuVS则可以在CPU内存和存储层级上构建、运行大型向量索引,企业知识库不必再占着GPU的HBM。

真正被检索出来、模型需要处理的相关文本片段,才会进入模型上下文。英伟达希望靠这一方式,压低模型权重、闲置上下文和RAG数据对HBM的占用,把更多GPU内存留给实际推理任务和并发用户。

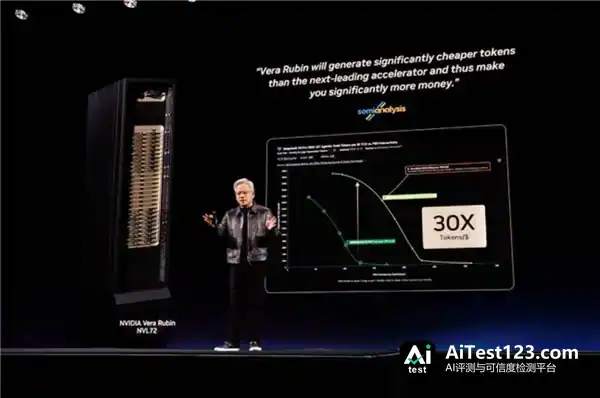
这次全栈协同设计文章里,最值得关注的是英伟达公布的性能数据。公司引用SemiAnalysis AgentX基准测试中的DeepSeek V4 Pro工作负载,对比不同代际AI计算平台的吞吐量与成本效率。

在每位用户每秒100个Token的服务速度下,英伟达GB300 NVL72相较H200平台,每美元可实现的吞吐量最高提升10倍,单颗GPU的HBM容量大约翻倍。
英伟达详解AI内存全栈协同设计:Agent吞吐量提升30倍 HBM容量仅增3%

服务速度提到每位用户每秒125个Token时,Vera Rubin NVL72相较GB300 NVL72,每美元可实现的吞吐量最高提升30倍,单颗GPU的HBM容量只增加约3%。

也就是说,在英伟达强调的特定Agent推理场景中,性能和成本效率的提升,远远超过了单纯堆内存容量能换来的收益。

压缩模型权重和KV Cache、把闲置上下文卸载到更低成本的存储层级、优化GPU、CPU和网络之间的数据调度——这几件事做到位,规模相近的内存资源就能产出更多有效计算。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 英伟达AI内存策略:HBM容量仅增3%,Agent吞吐量每美元最高涨30倍

    美东时间11月5日周四,英伟达发布公司博客文章,详解其AI内存全栈协同设计策略,强调随着大模型参数规模、上下文长度和智能体(Agent)应用持续扩张,AI基础设施的内存压力正在加剧,单纯增加GPU内存容量已不足以解决问题。英伟达提出,通过协同设计GPU、CPU、网络、存储和软件,并结合模型权重量化、KV Cache压缩

    来源 腾讯网
  2. 英伟达详解AI内存全栈协同设计:HBM容量增3% 每美元吞吐量最高升30倍

    美东时间11月5日周四,英伟达发布公司博客文章,详解其AI内存全栈协同设计策略,强调随着大模型参数规模、上下文长度和智能体(Agent)应用持续扩张,AI基础设施的内存压力正在加剧,单纯增加GPU内存容量已不足以解决问题。英伟达提出,通过协同设计GPU、CPU、网络、存储和软件,并结合模型权重量化、KV Cache压缩

    来源 腾讯网
  3. NVIDIA 全栈协同设计破解 AI 内存瓶颈

    IT之家 11 月 6 日消息,英伟达昨日(11 月 5 日)发布技术解读,指出随着大模型参数规模、上下文长度和智能体应用快速增长,GPU 显存正面临前所未有的压力,HBM 供应趋紧、价格上升,在可以预见的未来仍将持续。为了破解当前 AI 内存瓶颈,英伟达探索引入了“全栈协同设计”理念,将 GPU、CPU、网络、存储和

    来源 腾讯网
  4. 申通快递携千问办公:AI办公体系落地全国网点

    【TechWeb】11月6日消息,申通快递与千问办公正式达成战略合作。双方将围绕快递核心场景打造 AI 办公体系,以Agent能力支撑申通快递全国网点的增长战略落地,推动AI从总部管理向末端网点规模化输出,加速物流服务智能化升级。申通快递总

    来源 TechWeb
  5. 申通快递联手千问办公:Agent能力下沉全国网点

    【TechWeb】11月6日消息,申通快递与千问办公正式达成战略合作。双方将围绕快递核心场景打造 AI 办公体系,以Agent能力支撑申通快递全国网点的增长战略落地,推动AI从总部管理向末端网点规模化输出,加速物流服务智能化升级。申通快递总裁韩永彦与千问办公CEO陈宇森等共同见证签约。 申通快递作为中国头部快递企业,拥

    来源 AI 行业观察
  6. 深度|对话阿里千问AI算法负责人:Personal Agent拼的不是上限而是下限,生态是最大的墙

    推荐语过去一年,Agent 进展最扎实的领域是写代码。原因在于代码自带判卷标准,测试过没过,模型自己就能知道。强化学习有了稳定的反馈信号,能力就能一直往上训。生活服务没有这样的标准。订错一张票,记混一条病史,系统不会报错,用户只会悄悄流失。过去一年几款通用 Agent 先爆火、后冷却,问题大多出在任务完成率上。...

    来源 腾讯网
  7. Pangram 正式发布其 AI 图像检测模型,准确率达 99.96%

    IT之家 11 月 6 日消息,Pangram Labs 是一家专注人工智能生成内容识别的 AI 实验室。其在本月 4 日正式发布了 Pangram Image 1.0 模型。该模型可通过热力图定位 AI 生成的内容。Pangram Labs 利用 12 种前沿 AI 图像生成器,基于 100 张真实图片制作了一个 1

    来源 腾讯网
  8. 8800 GTX二十周年:G80架构如何成为AI计算的起点

    快科技11月6日消息,在英伟达GeForce 8800 GTX发布二十周年之际,行业专家回顾了其搭载的G80架构对现代AI计算的奠基性贡献。 这款诞生于2006年的旗舰游戏显卡,通过首次引入统一着色器架构和CU

    来源 快科技
  9. Box联合英伟达推智能体检索系统:速度提4倍,token降90%

    企业内容管理平台 Box 推出了一套采用“智能体优先”思路的内容检索系统,其核心基于英伟达 Nemotron 开源模型。据称,新系统响应查询的速度提升至原来的四倍,错误率降低 20%,而消耗的 token 数量减少 90%。这标志着企业搜索正从“检索增强生成”的单轮问答,转向由模型自主规划、多步执行任务的智能体检索架构

    来源 AI 科技快讯
  10. Karpo做城市生活AI:从心情出发,帮用户把念头变成安排

    谁能更早承接用户尚未明确的需求,谁就更有机会成为新的消费入口。 一笔消费,究竟从什么时候开始?很多人会觉得,是下单付款的那一刻。但只要回想一次最近的外出,就会发现它的起点其实早得多。 订下一家餐厅之前,可能经历过想见朋友、想庆祝、想换个环境等不同念头;同样一句今晚想出去,最终可能对应一顿饭、一场演出,...

    来源 腾讯网
  11. 苹果AI国行版开放测试:千问接入Siri,新Siri缺席

    苦等两年多,国行用户终于等来了苹果AI。11月4日,苹果发布了iOS 27.3开发者Beta版,国行版Apple Intelligence(苹果智能)首次开放测试。 这是苹果AI第一次真正进入中国大陆市场,但其首次发布在2024年6月。两年期间,国产手机厂商已经将AI消除、智能摘要、实时翻译乃至跨应用智能体等功能陆续装

    来源 AI 行业观察
  12. 奇富科技开源ModelEvo 2.0:自动建模Agent新增自主搜索与经验复用

    【TechWeb】11月6日消息,尽日,奇富科技正式开源自动建模Agent ModelEvo 2.0。新版本面向结构化与表格数据,在标准化建模流程的基础上,进一步实现自主搜索、可信评估与跨任务经验积累复用。用户明确业务目标、提供建模样本与验证方案后,Agent可在给定预算内分析数据、规划实验并持续优化,对通过确认与交付

    来源 AI 行业观察
  13. METR报告:Anthropic能力进步翻倍,80%增量由AI贡献

    AI 帮助研发下一代 AI 的速度,终于有了具体数字。 11 月 5 日,第三方评估机构 METR 发布一份关于 Anthropic 的调查报告表示:这家公司过去一年取得的基准能力进步,大致相当于此前两年的进步。 从 8 月 12 日到 10 月 29 日,这个机构花费了约 11 周时间进入 Anthropic 内部查

    来源 AI 行业观察
  14. 美“核武级”AI禁令悬顶:美股恐慌收跌,马斯克财富单日缩水800亿美元

    AI概念股受挫,马斯克财富单日缩水近800亿美元政治立法的风吹草动迅速传导至资本市场。受“AI禁令”恐慌情绪影响,存储、光通信等AI概念股遭遇重挫。福布斯实时富豪榜显示,截至美股11月5日收盘,马斯克个人财富约为7895亿美元,单日缩水793亿美元。彭博亿万富翁指数则显示,马斯克个人财富达到7850亿美元,单日缩水79

    来源 TechWeb
  15. 马斯克单日身家缩水近800亿美元:民主党推超级AI禁令,美股应声重挫

    AI概念股受挫,马斯克财富单日缩水近800亿美元政治立法的风吹草动迅速传导至资本市场。受“AI禁令”恐慌情绪影响,存储、光通信等AI概念股遭遇重挫。福布斯实时富豪榜显示,截至美股11月5日收盘,马斯克个人财富约为7895亿美元,单日缩水793亿美元。彭博亿万富翁指数则显示,马斯克个人财富达到7850亿美元,单日缩水79

    来源 TechWeb
  16. 英伟达发布Realtime-Bench:GPT-6-Astra实时任务成功率仅44%

    人工智能大模型在文本创作、代码编写和图像生成等静态任务上已经展现出惊人的实力,但在瞬息万变的实时交互场景中,它们的真实表现究竟如何?近日,英伟达携手得克萨斯大学奥斯汀分校(UT-Austin)等顶尖机构正式发布了全新的实时交互任务基准——Realtime-Bench。该基准的诞生,旨在为评估人工智能在动态环境下的综合表

    来源 AI 开发者社区
  17. NVIDIA Cosmos 3新增四款开放模型:96GB显存门槛如何落地?

    2026年11月5日,NVIDIA在HuggingFace发布四个Cosmos 3 Nano开放权重检查点,涵盖自动驾驶多视角仿真与双臂机器人交互模拟。每个模型含160亿参数,采用OpenMDW-1.1许可支持商业使用。这是继5月31日Computex主体发布后的重要扩展,但Nano级别要求96GB显存的硬件门槛,让"

    来源 AI 科技快讯
向下滚动自动加载更多






