MOSS-Live发布:全双工语音交互系统如何让助手边聊边干活
OpenMOSS团队推出MOSS-Live,解决语音助手“打断即重置”的痛点。该系统支持全双工对话,能区分背景噪音与有效指令,并在执行查酒店、看天气等耗时任务时保持前台对话流畅。基准测试显示,其在工具调用成功率和多轮任务完成率上表现优异,尤其擅长处理插话和语气词,让语音交互更接近真人交流节奏。
语音助手为什么总像“听不全”话
用过智能音箱或手机语音助手的人,多半碰过这样的情况:你问“明天上海天气怎么样”,它刚念到“明天上海晴转多云……”,你忽然想起一件事,插嘴问“那后天呢?”。多数助手会马上停掉当前回答,重新识别新指令,再从头播报后天的天气。上下文就这么断了,对话显得生硬、机械。
背景噪音是另一重麻烦。在咖啡馆里跟朋友聊天,顺口问助手一句,它很可能把朋友的闲聊也当成指令,也可能因为环境太吵干脆没反应。还有,助手要联网查数据时(比如比三家酒店的价格),往往一声不吭,直到结果出来才开口。这段时间里,用户不知道该等着,还是再问点别的。
2026年11月7日,OpenMOSS团队发布MOSS-Live系统,想补上这些长期存在的体验断层。它的核心目标不是把语音识别做得更准——现有模型已经够准了——而是让交互节奏更接近真人。真人对话是全双工的:能边听边说,能随时插话,能在对方思考时继续聊别的话题,也能自动过滤周围的无关谈话。
前台聊天,后台干活
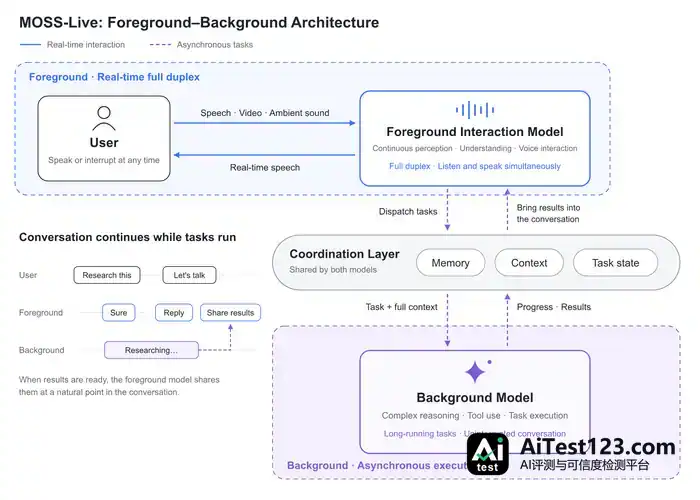
MOSS-Live的思路很直接:把“聊天”和“干活”拆开。
传统架构里,语音识别、意图理解、工具调用和语音合成常常串在一条管道上,一步卡住,全线等待。MOSS-Live加了一个协调层,把交互分成“前台”和“后台”两个时间尺度。
前台管“聊”,盯的是毫秒级的对话节奏。它要一直监听用户的语音流,判断哪些是发给它的指令、哪些是背景噪音、哪些只是“我在听”的语气词(如“嗯”、“啊”)。用户一插话,前台得立刻停住当前的语音输出,记下中断点,处理完插话后再选择性地回到之前的话题,而不是粗暴地重启。
后台管“做”。查酒店、规划路线、多步推理,这些耗时操作都丢给后台跑。关键在于,后台运行时前台并不闲着。用户可以在等待期间问别的问题,比如“那附近停车方便吗?”。助手先答停车,后台继续查酒店。等酒店信息查好了,助手会自然地把它插进对话:“刚才查到的酒店是……另外,附近停车场在……”
对话因此保持了连续性。用户不必为了迁就机器的处理速度刻意停顿,机器也不必为了执行任务切断对话流。
三个真实场景里的表现
为验证这套逻辑,开发团队展示了三个典型用例,覆盖从复杂协作到个人助理的不同需求。
小组会议里的“隐形秘书”
一场关于活动策划的群聊中,MOSS-Live作为参与者加入。大家讨论去上海还是杭州时,它开始在后台查两地的天气和近期大型活动。中途有人插话确认会议室预订情况,助手立即响应并处理该请求,后台的查询任务没有被打断。最后它主动总结:“杭州下周有雨,但上海有个音乐节可能影响交通。根据刚才的讨论,我们暂定上海,对吗?”
这里的关键能力是选择性注意。它能从多人交谈中分辨出哪些话是对它说的、哪些是成员间的私下交流,还能在长对话中保持上下文记忆,最后给出结构化总结。
自驾途中的计划变更
用户计划去舟山两日游,原定 hiking(徒步),路上改了主意,想在海边放松。MOSS-Live在后台重新检索酒店和轮渡信息。这时车载导航正在播报路况,环境噪音不小。助手既过滤了导航语音的干扰,也处理了用户关于“停车场位置”的临时提问。新的酒店列表准备好后,它结合用户“想放松”的新需求,推荐了靠近沙滩的住宿,而不是此前搜索的山景房。
这个场景考验的是动态上下文更新和抗噪能力。计划变了,之前的搜索约束条件(如“靠近登山口”)要废弃,新的约束(“靠近海滩”)要应用,而这一切发生在移动且嘈杂的环境中。
城市探索中的视觉辅助
一位英语游客站在上海街头,用手机摄像头对准和平饭店。MOSS-Live实时识别建筑,并用英语介绍其历史。游客中途打断,问“今晚有餐厅营业吗?”。助手暂停历史介绍,查询餐饮信息并回答。随后游客把镜头移开,过了一会儿又移回来,助手能接上之前的话题,提到建筑顶部的绿色屋顶设计。
这展示了实时视觉理解与语音对话的融合。视觉输入不再是独立的“拍照识图”功能,而成了对话的一部分。即使视线中断,对话的记忆依然保留。
数据怎么说:不只是快,更是稳
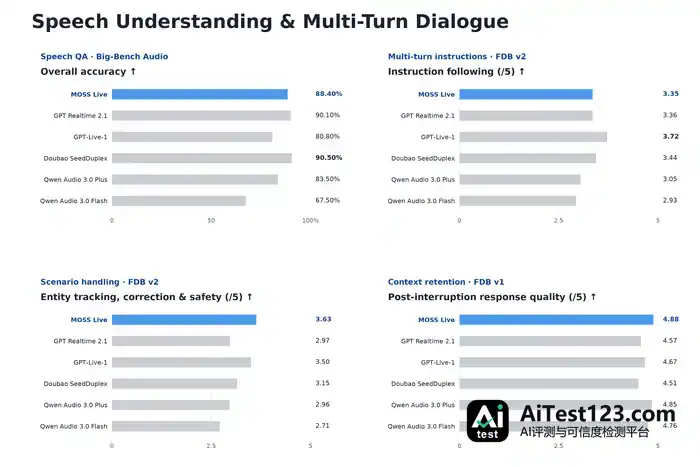
评估一个全双工系统,不能只看响应速度,更要看它是否“懂规矩”。OpenMOSS团队用了FDB(Full-Duplex Benchmark)系列、Big-Bench Audio和τ-Voice等多个基准做测试,对比对象包括GPT Realtime 2.1、Qwen Audio 3.0等主流模型。
全双工交互能力:不抢话,不漏听
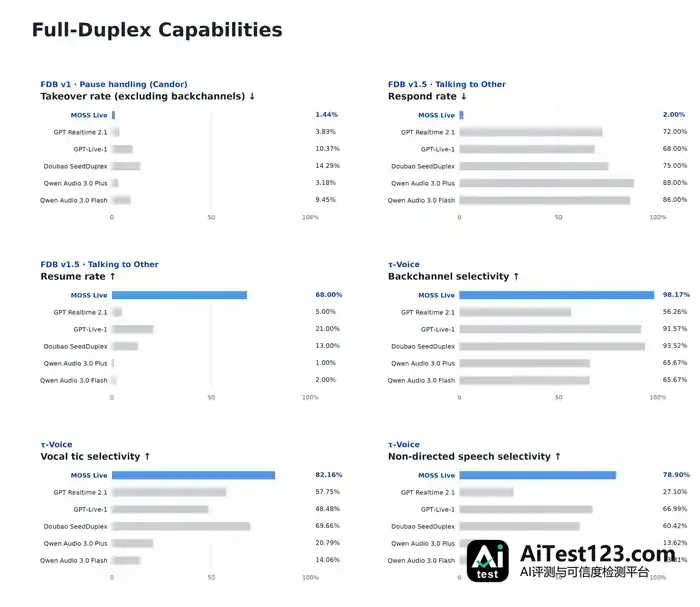
在FDB v1与v1.5的测试里,MOSS-Live有几项关键指标很能打:
- 抢话率(Takeover rate):用户只发出“嗯哼”这类语气词(Backchannel)时,MOSS-Live的抢话率为0.00%,不会把这些无意义音节当成发言结束。部分模型则会误判。
- 背景语音过滤方面,身边有人交谈(Talking to Other)时,MOSS-Live的响应率只有2.00%,恢复率(Resume rate)为68.00%。大部分时间它都能保持安静,不被无关对话带跑,干扰结束后也能较快回到待命状态。对比之下,GPT Realtime 2.1在同样场景下的响应率高达72.00%,经常错误地插进别人的聊天。用户强行打断助手发言时,MOSS-Live中断后的回复质量评分为4.88/5,高于GPT Realtime 2.1的4.57分。它不光能停下来,还记得停在哪里,能接着往下聊。
工具使用与多轮任务:边聊边干
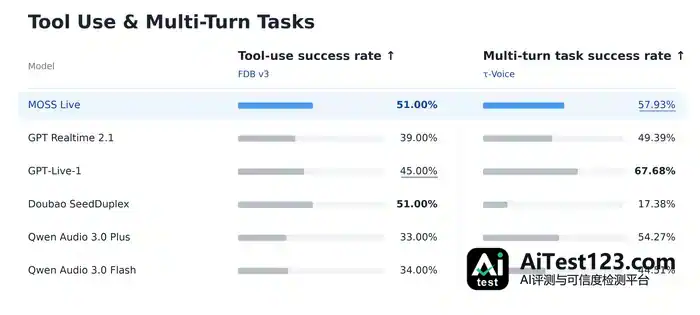
FDB v3测试中,MOSS-Live的工具调用成功率达到51.00%,与Doubao SeedDuplex并列第一。Qwen Audio 3.0 Plus在参数准确率上略高一些,但MOSS-Live在语义任务成功率(66.00%)和工具调用后的回复质量(83.00%)上依然有竞争力。
τ-Voice测试中的多轮任务成功率更能说明问题。MOSS-Live达到57.93%,仅次于GPT-Live-1的67.68%,远高于Doubao SeedDuplex的17.38%。处理需要多次交互、中间还可能穿插其他问题的复杂任务时,它的稳定性较好。
语音理解与选择性注意
τ-Voice专门测了模型过滤非指向性语音的能力。MOSS-Live在非指向性语音选择性(Non-directed speech selectivity)上得分78.90%,远超GPT Realtime 2.1的27.10%。嘈杂环境里,它更少“自作多情”地去回应无关谈话。
语气词选择性(Vocal tic selectivity)上,MOSS-Live得分82.16%,同样大幅领先。区分“我在听”和“我说完了”这两个微妙状态,正是它的长处。
技术细节与局限
数据亮眼,但MOSS-Live并非没有短板。FDB v3的工具调用延迟测试中,它的平均响应时间为2.36秒,慢于GPT Realtime 2.1的1.61秒。后台任务协调机制可能带来了一定开销。简单查询场景追求极致速度的话,这算一个权衡。
背景噪音过滤表现不错,但极端嘈杂环境(比如地铁进站口)下的具体表现,公开资料中没有详细数据。视觉理解目前主要靠摄像头或屏幕共享输入,复杂三维空间的理解能力还有提升空间。
如何体验
MOSS-Live已经在OpenMOSS平台上线。开发者可以照着API文档把它集成进应用,普通用户则能直接在在线Playground里试。
想感受它的特性,可以试试下面几种操作:
- 故意插话:等它回答长问题时,中途抛一个新问题进去,看它能不能平滑切换。
- 制造噪音:在旁边放播客或者跟人聊天,观察它会不会误触发。
- 多任务并行:让它查一个复杂行程,等待期间问它别的无关问题,看它最后能不能把行程结果补全。
对开发者来说,MOSS-Live的价值在于给出了一套处理“非理想化”语音交互的参考架构。语音助手不必是“一问一答”的机器,也可以成为能应付混乱、中断和多线程任务的对话伙伴。
引用
如果在研究或项目中使用MOSS-Live,可引用以下信息:
@misc{openmoss2026mosslive,
  title  = {{MOSS-Live}: A Full-Duplex Real-Time Interaction System},
  author = {{OpenMOSS}},
  year   = {2026},
  url    = {https://github.com/OpenMOSS/MOSS-Live}
}