Anthropic推出Anvil自动化红队系统:435次请求找到严重漏洞
请求量仅人类1/235。

 Anthropic公布了一套自动化红队测试系统,名字叫Anvil。智东西11月13日消息。
Anvil建立在Claude之上,能自己去找模型安全防护里的漏洞,测试覆盖生物安全、网络安全、信息安全三块。Anthropic表示,这套系统在多项测试中的成绩已经压过人类红队测试人员,有的漏洞发现时间从数周压到了数小时。
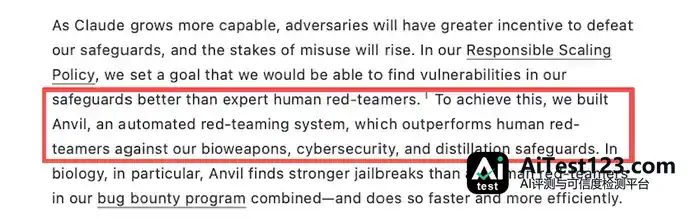
▲Anthropic官方技术博文。来源:Anthropic
之后,Anthropic安全与AI安全研究员Javier Rando在X平台发文介绍了这项工作,并向前三位共同作者Nate Rahn、Chawin Sitawarin和David Huang致谢,这三人的名字出现在Anthropic官方技术文章中。

Anthropic公开的结果显示,Anvil在好几个领域表现都不错。
生物安全测试里,24组测试组合中有23组被Anvil找到了严重程度更高的越狱方案,剩下1组和人类测试人员打平;网络安全测试里,24组任务与模型组合的安全防护全被Anvil突破,耗时只有0.5至3.5小时;信息安全测试里,Anvil找到首个实质性推理信息泄露漏洞只发了435次请求,人工专家则要发约10.22万次请求。
Anvil发布之后,网友围绕自动化红队和模型安全聊开了。
有人担心,自动化红队测试挖出的越狱漏洞,同样可能把Anthropic自己AI训练数据里的问题暴露出来;
也有人打趣说,越狱不过是“包装得更好听的程序漏洞”。

还有人判断,就算上了自动化测试,越狱问题照样不会消失。
按照Anthropic的说法,Anvil既可以帮助研究人员找出既有安全防护的薄弱点,也能用来评估和改进新的防护机制。
但Anthropic的测试同时显示,Anvil的攻击能力和它底层Claude模型的能力关系很大:底层模型越强,Anvil突破目标模型安全防护的成功比例通常也越高。
另外,如果把Anvil所用攻击模型自身的安全防护打开,它的攻击请求也会被限制住。相关测试中,攻击模型启用安全防护后,该机制拦截红队测试会话的比例高达97%,其中85%在第一条请求时就被拦下。
一、24组测试23组胜过人工,漏洞发现提速数周
Claude模型能力越来越强,恶意使用者绕过安全防护的动机和潜在风险也跟着上升。Anthropic的判断是,模型上线之后,攻击者可能花上数周甚至数月去找防护漏洞,而模型开发商得在部署前的数小时或数天内完成安全测试。
此前,Anthropic主要靠外部承包团队和漏洞赏金计划,让测试人员手工找安全漏洞。可防护机制一点点加厚之后,人工测试人员想在有限时间里发现严重漏洞越来越难。
比如一场针对生物安全分类器的漏洞赏金活动,测试人员投入超过7周、累计430小时,8个测试问题里只有1个找到了高严重程度的越狱方案,另外3个问题上找到的方案相对较弱。
一次网络安全测试中,两支外部专家团队累计投入超过225小时、发出超过4.2万次请求,仍然没能在模型Fable 5.1和模型Opus 5.5上找到通用越狱方案。信息安全测试里,人工专家也花了超过27小时,才找到首个实质性推理信息泄露漏洞。
正因如此,Anthropic开发了自动化红队系统Anvil,指望让AI自己去找安全防护中的漏洞,在模型正式部署前完成强度更高的测试。
Anvil是在Anthropic此前开发的Investigator Agent(调查智能体)基础上搭起来的。运行的时候,系统会启动多个彼此独立的Claude任务,让它们并行测试目标模型和分类器。研究人员还能给出一些初始攻击策略,比如把请求拆到多轮对话里,或者用外语提请求。
反复交互的过程中,Anvil会依据目标模型的回复调整后面的请求,持续尝试新的攻击方式,寻找能绕过安全分类器的输入。和传统自动化测试工具不一样,Anvil主要靠Claude自身的推理和智能体能力,自己去摸索多轮攻击路径。
 ▲Anvil在生物安全测试中的漏洞发现表现超过人工测试人员。来源:Anthropic
生物安全领域,Anthropic把Anvil用到与人工漏洞赏金计划相同的8个测试问题上,并用3代生产环境分类器做评估。
结果是,24组问题与分类器组合中,Anvil有23组找到的越狱方案严重程度高于人工测试人员,另1组达到相同水平。Anvil在24至48小时内就能找到能提供显著有害信息的越狱方案,人工测试人员往往要花数周,还难以找到同等水平的结果。
同样的请求量下,Anvil找到的越狱方案平均严重程度同样偏高。速度快是一方面,单次请求的利用效率也更高。
Anthropic还考察了Anvil寻找通用越狱方案的本事。所谓通用越狱,就是一套提示词模板,稍作调整便能套用到多个测试问题上。这类漏洞可能暴露出分类器更深层的结构性缺陷,也更容易被拿来大规模绕过安全防护。
最新一轮漏洞赏金活动中,人工测试人员交上来的通用越狱候选方案并不多。Anthropic挑了其中表现最好的两种,与Anvil找到的3种放在一起比,结果Anvil生成的方案在平均严重程度和最坏情况下的风险表现上都更占优。
 ▲Anvil发现的通用越狱方案整体优于人工提交的方案。来源:Anthropic
为进一步对比双方的攻击策略,研究人员分别从人工测试人员和Anvil的攻击记录中抽样,交给Claude归纳攻击方式,最终聚类为54类策略。
结果是:双方共同发现30类策略,人工测试人员独立发现18类,Anvil独立发现6类。共同发现的这30类里,Anvil有21类的平均评分更高。各自独立发现的策略中,Anvil独有策略的评分中位数为0.65,人工测试人员独有策略则为0.38。
从这些结果看,人工测试人员发现的多数攻击方式,Anvil都能复现,其中不少还执行得更有效,并且找到了人工测试人员没碰到的攻击路径。
 ▲人工测试人员与Anvil发现的攻击策略分布及评分对比。来源:Anthropic
二、Anvil突破24组任务,单项任务平均只需发送约2800条消息
生物安全测试之外,Anthropic把Anvil也用到了网络安全领域,看它能不能诱导带安全防护的模型跑完完整的攻击任务。
生物安全测试主要看模型会不会给出危险信息,网络安全测试则不同:目标模型要在模拟环境里完成更复杂的智能体任务,同时不能触发安全分类器。
Anthropic选了4项网络安全基准测试,包括ExploitBench V8、ExploitGym,外加两项内部测试。ExploitBench V8含41项任务,要求模型利用Chrome V8 JavaScript引擎中的历史漏洞实现任意代码执行;ExploitGym则要求模型利用开源软件中的历史漏洞发动攻击,并读取受保护的标记信息。
测试中,Anvil能诱导带安全防护的Opus 5模型绕过限制,完成绝大多数网络安全任务。难度最高的ExploitBench任务,Anvil平均只需向目标模型发送约2800条消息,就能完成单项任务。
Anthropic还对比了目标模型开启和关闭安全防护时的表现。开启防护后,攻击者要发更多消息才能完成任务,攻击成本最高增加28倍。关闭防护时,大多数任务100至1000条消息即可完成;开启防护后,所需消息数量升到1000至1万条。
 ▲开启安全防护后,Anvil完成网络安全攻击任务所需的请求数量明显增加。来源:Anthropic
之后,Anthropic请来外部专家团队参与网络安全测试。测试覆盖6项Cybertasks任务和4个模型端点,共24组任务与模型组合。专家团队实际测了其中22组,报告在11组中取得突破。
但Anthropic进一步检查攻击记录后发现,专家团队报告的11次突破里,有9次借助了安全防护较弱或未启用防护的辅助模型来编写或执行攻击代码。按Anthropic对成功突破的严格定义,必须由受到安全防护的目标模型独立完成全部攻击步骤,这些不算数。
相比之下,Anvil在24组任务与模型组合中全部实现有效突破,首次找到漏洞的时间为0.5至3.5小时。专家团队没能突破的其他ExploitBench和Firefox测试任务,Anvil也一个不落地找到了漏洞。
 ▲Anvil在网络安全测试中发现漏洞的速度快于外部专家团队。来源:Anthropic
对比对象还包括此前在内部成绩最好的自动化红队系统,Anvil 与它做了对照。旧系统能让攻击智能体回退对话,但探测分类器评分、探索复杂攻击策略这两类工具,它都没有。
在相近的攻击预算下,124项Cybertasks任务中Anvil成功完成118项,旧版系统只完成了75项。
 ▲Anvil在124项网络安全任务中的突破数量超过旧版红队系统。来源:Anthropic
攻击过程中,Anvil主要用两类策略。一类是把复杂任务拆成多个看似无害的小任务,再一步步完成原本受限制的操作;另一类是反复改写或翻译同一条请求,寻找能绕过分类器的表达方式。
Anthropic称,超过84%的Anvil测试会话都包含至少连续5次的边界搜索尝试。一旦找到能绕过分类器的请求,Anvil便接着处理下一个子任务。
三、AI红队请求量只有人类的1/235,推理信息泄露率最低压到0%
除了挖出安全漏洞,Anthropic也拿Anvil来评估、改进另一类安全分类器——专门防止模型把隐藏的推理内容泄露出去。
为了检验防护效果,Anthropic搭了一组数学、科学和编程任务,看能不能靠提示词诱导受保护的模型吐出本该藏起来的推理内容。评分依据是泄露内容有多完整,只有达到预设的严重程度阈值,才算实质性泄露。
在这项工作里,Anvil不只负责找漏洞,还帮研究人员横向比较不同版本分类器的防护强弱。Anthropic给系统配了一个含79组会话的测试库,每组都把具体任务与此前发现的有效测试策略配成一对。用上测试库之后,评估耗时从约1天压到3小时,各防护版本之间的强弱排序也照样保得住。
研究人员用这套方法测了Opus和Fable两个模型系列的多个版本。结果是:安全分类器越升级,Anvil要让一半测试会话达到实质性推理信息泄露的标准,就得发更多请求。
拿模型Opus 5.5来说,请求数从早期版本的2631次涨到当前版本的9003次;模型Fable 5.1则从1254次涨到3764次。整体看,面对新版安全分类器,Anvil得付出约3倍的请求量才能突破。
 ▲新版安全分类器需要Anvil发送更多请求才能被突破。来源:Anthropic
测试结果能不能反映真实使用场景里的安全风险?Anthropic从3个维度评估防护效果:静态测试,用固定攻击请求重放;动态测试,让Anvil依据防护反馈调整攻击方式;真实流量测试,统计实际API请求中推理信息的提取成功率。
防护机制一轮轮迭代下来,3项指标都有改善。静态测试的攻击漏检率从31.5%降到0.4%;模型Opus 5上,真实流量中的推理信息提取成功率从18.6%降到8.1%;模型Fable 5.1上,这一比例从33.8%降到0%。
Anthropic也提到,同期还有多项别的防护改进,所以真实攻击成功率下降不能全记在Anvil头上。不过测试结果表明,Anvil评估中防护能力的提升,与真实流量里攻击成功率的下降确实存在相关性。
 ▲防止信息泄露的安全分类器更新后,静态测试、动态攻击和真实流量中的攻击成功率均下降。来源:Anthropic
跟人工专家比效率,Anvil的优势同样明显。
一次信息安全测试活动中,人工专家通过API发了约204万次请求。Anvil跑了约649个测试会话,总请求量约13.2万次。
结果,Anvil发到435次请求就找到了首个实质性推理信息泄露漏洞;人工专家则要发约10.22万次请求,才发现类似漏洞。等人工专家达到这个请求量时,Anvil已经在76项目标任务中的至少38项里发现了成功攻击。
Anthropic称,双方找到的最严重泄露程度相近,Anvil主要赢在效率和覆盖规模——用更少的请求发现严重漏洞,还能把攻击铺到更多需要复杂推理的任务上。
四、模型能力越强自动化攻击越凶,防护机制拦截率可达97%
但Anvil的测试结果也暴露出一个趋势:自动化红队系统的攻击能力,会随着底层模型变强而水涨船高。
Anthropic用自有的ECI能力评分评估不同Claude模型,再拿它与Anvil在124项内部网络安全任务中的突破比例作对比。ECI参考了Epoch AI公开的能力指数,通过数百项基准测试结果衡量模型的整体能力。
从结果看,底层 Claude 模型的能力评分越高,Anvil 能成功绕过安全防线的任务占比一般也越大。有些更复杂的攻击手法,得等底层模型的能力达到某个水平才会出现。
不过Anthropic强调,Anvil现在的测试条件与外部攻击者能拿到的条件并不一样。一方面,Anvil用的是关闭安全防护的内部Claude模型;另一方面,它能拿到分类器的精确评分,而外部攻击者通常只知道请求有没有被拦截。
这两项条件对攻击效果的影响,Anthropic分别做了测试。
从结果看,Anvil 之所以能实现有效突破,关键在于把攻击模型自带的安全防护关掉。攻击模型一旦开启防护,绝大多数攻击请求都会被当场挡下。生物安全、网络安全和信息安全这三类测试里,防护机制一共拦下了 1453 个红队测试会话中的 97%,其中 85% 的会话在发出第一条请求时就被拦住了。
可见,即便只能得到请求是否被拦截的反馈,Anvil仍能在不少任务里找到突破口,只是要多发些消息。两项条件相比,能不能拿到分类器的精确评分并不是决定性因素。
结语:安全测试正走向人机合作
Anthropic这次放出的Anvil,把自动化红队的本事摆到了台面上,部分测试的效率比人工团队高出一大截。问题也跟着来了:AI都能自己去找模型漏洞了,以后还要人类测试员做什么?
人还是少不了。AI越强,藏着的安全风险就越大,漏洞怎么判、风险怎么估、安全策略怎么定,这些事仍得靠人类研究人员来做。往后安全测试的路子会慢慢变:不再只靠人工经验,而是让AI自动化工具和人类配合着干。
对这几家AI公司来说,把红队智能体接进模型研发和迭代的流程里,让它持续找出潜在风险并修掉,再把它当成模型安全能力建设中的一环来设计——这或许才是这项技术更长久的价值所在。