谷歌Meta开源TorchTPU:PyTorch原生支持TPU,8000芯片近线性扩展
在圣何塞举行的 2026 年 PyTorch 北美大会上,谷歌和 Meta 开源了 TorchTPU——这是谷歌张量处理单元(TPU)的原生 PyTorch 后端。
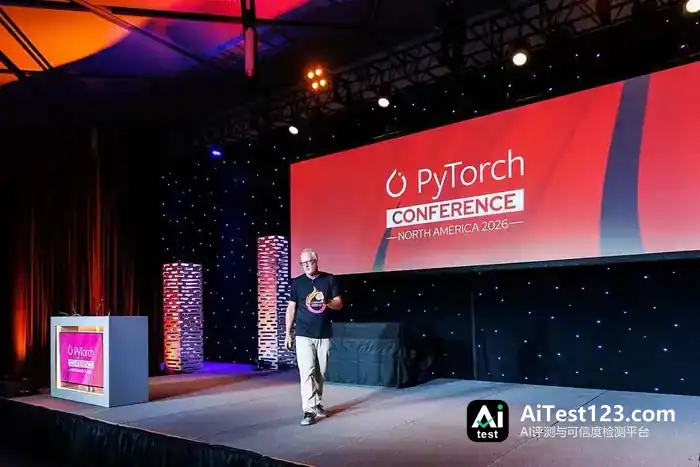
2026 年 PyTorch 北美大会在圣何塞举行,谷歌与 Meta 在会上开源了 TorchTPU。这是谷歌张量处理单元(TPU)的原生 PyTorch 后端。10 月 21 日的主题演讲中,Meta 软件工程师 Zongwei Zhou 表示,Meta 计划借助这个后端,把规模更大的 LLM 工作负载迁到 TPU 上运行。PyTorch 正是 Meta 在 2016 年创建的。
TorchTPU 接替的是 2020 年推出的惰性张量桥接库 PyTorch/XLA。按照公告的说法,该库“需要对源代码进行侵入性修改”。新后端想要达到的效果,是让模型移植变得跟把 model.to(“cuda”) 改成 model.to(“tpu”) 一样省事。谷歌云在公告中写道,“借助 TorchTPU,TPU 将与 GPU 和 CPU 一起成为 PyTorch 的原生选项。”这份公告由 Core ML/AI 工程副总裁 Bill Jia 共同撰写。
Jia 和 Zhou 一起登台做了主题演讲,题目是“智能体时代的工作负载可互换性:将原生 PyTorch 带入云端 TPU”,在此之前已有两场演讲铺垫市场需求。PyTorch 基金会执行董事 Mark Collier 表示,推理已经取代训练,成为数据中心里最大的工作负载,由此带来了“对 token 的巨大需求”。他把社区的目标描述为开发一种开源软件,让模型能够“在任何云端的任何芯片上运行,并且能够连接到任何智能体”。基金会演讲幻灯片上的数字显示了市场变化之快:DeepSeek 的 Flash 模型在 37 天内把成本降低了 60%;Kimi K3 在相同硬件上用了不到 33 天,就把运行速度提高了 68%。

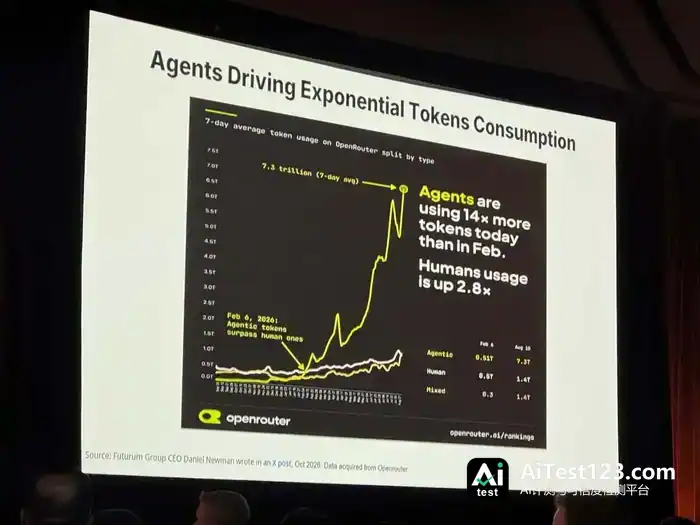
Agentic AI 基金会执行董事 Mazin Gilbert 表示,2026 年 2 月 6 日,智能体 token 消耗量已经超过人类消耗量。这之后,智能体 token 消耗量涨了 14 倍,人类消耗量只涨了 2.8 倍。Gilbert 说,“所以基本上,这是一条呈‘曲棍球杆’状的爆发式增长曲线。”不过从业者在引用这些数据之前,应该先核实其适用范围,因为公开数据只来自一个平台——OpenRouter。
据演讲者介绍,TorchTPU 集成进了 PyTorch 的底层调度器,因此 Hugging Face 的模型可以开箱即用。vLLM 和 SGLang 推理引擎能原生运行;TorchTitan 则支持面向大规模训练的密集型、专家混合型和扩散型模型。Ray 和 llm-d 可以在 Kubernetes 上跨多个主机扩展 TPU 工作负载。已开源的代码库一共四个:TorchTPU、vLLM-TorchTPU、SGLang-TorchTPU 和 TorchTitan。
Jia 展示了 TPU 芯片数量超过 8000 个时的近线性扩展能力:集群规模扩大,单芯片吞吐量基本保持恒定。谷歌公布的结果中,有一项是在 8192 个 TPU v7x 芯片上运行 Qwen3 235B 专家混合模型,模型 FLOPs 利用率为 28%。公告也坦言,这一行代码的修改仅仅是个起点。
只做这个简单改动,还达不到 TPU 的峰值性能。原因是模型的结构、分片和运算可能更适合 GPU 架构。不过模型应该可以开箱即用。
针对这一调优缺口,谷歌给出的办法是增加智能体数量。演讲末尾,Jia 发布了 TPU 代理套件。该套件目前已在 GitHub 上开放预览,能集成到编码框架中,自动完成环境接入、故障诊断和性能调优。
Zhou 表示,Meta 的 PyTorch 团队与谷歌共同开发了 TorchTPU,“旨在让 TPU 成为 PyTorch 的第一类原生目标”。他提到,这出于生产环境对性能、可靠性和可维护性的需求。“所有这些都是开源的,今天就可以使用,而这仅仅是个开始。”在谷歌云的公告里,Meta PyTorch 工程总监 Jana van Greunen 说明了这一举措的动机:
在 Meta,推动前沿 AI 的发展需要巨大的计算规模和丰富的硬件多样性。我们不能被单一的硬件架构所束缚。
谷歌并非独此一家。10 月 20 日,亚马逊云科技宣布公开测试其 Trainium 芯片的原生 PyTorch 后端 TorchNeuron,代码只需改成 .to(‘neuron’)。两个后端都通过 PyTorch 面向自定义硬件的扩展点 PrivateUse1 注册。TorchNeuron 的首个版本眼下还有些不足:The Next Web 报道称,它目前不支持动态输入形状,还跳过了约 22000 个 PyTorch 测试用例。Blair Hayes 在为 Forkast 撰写的分析文章中指出,供应商锁定并没有消失,只是转移了地方:
尽管 PyTorch 的扩展点为开发者提供了一种通用语言,优化层和供应层却仍牢牢握在供应商手里。
Hacker News 上,关于 TorchTPU 发布的讨论帖拿到 379 分。网友们的反应里既有松一口气,也有现实的疑虑。一位评论者写道,“我还记得当年为了让 PyTorch 在 TPU 上运行,不得不与 XLA 周旋的日子,看来我们终于获得了官方支持!”也有人打听到底在哪里能买到 TPU。另一位曾代表公司考察过谷歌本地部署版 TPU 的评论者则冷静得多:“我们评估过这些产品,但决定继续使用 Nvidia,至少再用一代。”
数据中心之外,可移植性同样是卖点。Meta 的 Anthony Shoumikhin 和 Jacob Szwejbka 在一场关于用 ExecuTorch 部署机器人策略的会议上提到,策略从训练到设备端都能留在 PyTorch 里,不必切换技术栈。同一套量化方案和运算符图,在 NVIDIA Jetson TensorRT、Intel OpenVINO 等目标平台上都能跑。
训练分会场则拿出了成本账。RadixArk 的 Yueming Yuan 介绍 Miles 强化学习框架时称,把两个对数概率计算合并进一个内核,这一步提速超过 10 倍;在一次大规模运行中,Delta 更新让每次权重同步要传的数据从 62 GB 压到 1 GB 以下。围绕用强化学习(RL)训练智能体的开源工具,也有多场会议分享:Anyscale 的 SkyRL 把训练、推理和环境拆开,由 Ray 负责协调;Hugging Face 的 OpenEnv 给每个强化学习环境提供统一接口,该项目已于 10 月 22 日 加入 Agentic AI 基金会。Hugging Face 的 Sergio Paniego Blanco 用 TRL 和 OpenEnv,让四个编程智能体训练一个小型 Liquid AI 模型,模型在保留任务上的得分从 42% 升到 54%。
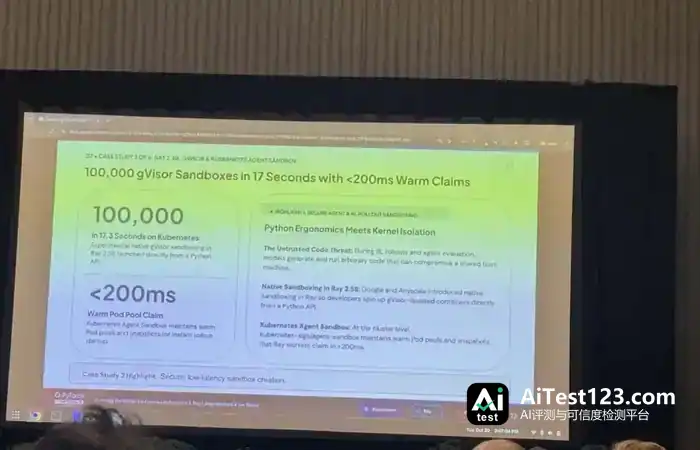
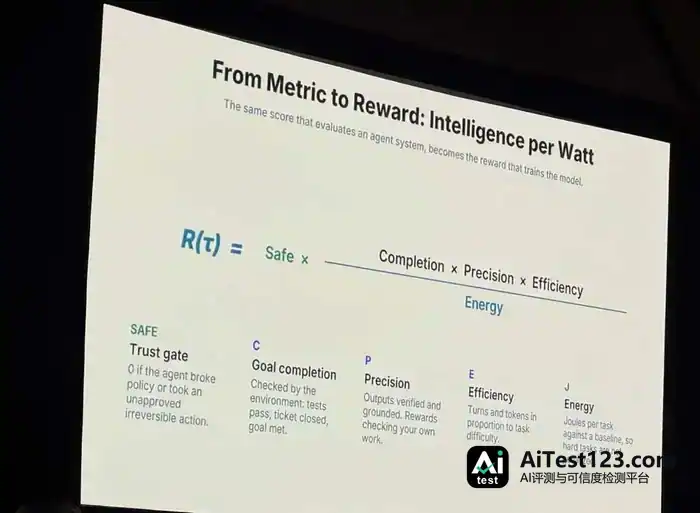
对正在盘算迁移的团队来说,改动一行设备代码就能让模型跑起来,但还谈不上调优。所以,分片和内核的活要提前留出预算,TPU 的容量也得先确认。想深入了解的开发者,可以去看 TorchTPU 公告、翻 TorchTPU 代码库,或者读 InfoQ 对 PyTorch Conference 2024 的报道。会议录像会在活动结束后两周内放到 PyTorch 基金会的 YouTube 频道上。