AI4Chip能不能接棒Coding?基模厂研究员和十年芯片工程师吵起来了
AI芯片设计的冷与热。
(本文作者为 霞光AI实验室,钛媒体经授权发布)
AI4Chip,会不会成为Coding之后的下一个战场?
同一个问题,两个人给出的答案几乎完全相反。
剁椒酱是某基础大模型厂商(下称"基模厂")的研究员。他从大模型公司的立场出发看芯片设计:AI的智力在往上走,人类之所以要分工,根子在于"context有限",AI却没这道枷锁。几千人协作才能完成的芯片设计,早晚会被一个足够聪明的AI压扁。他的判断是,AI4Chip会成为下一个Coding场景——第一步帮工程师提效30%,第二步端到端做出简单芯片,最终走到self-improve的芯片设计。他还在社交平台上抛了一句自己的"暴论":基模厂迟早都会有自己的芯片厂。
另一位是晒哥,做数字芯片设计近十年,也是AI芯片设计领域的知识博主。听到“下一个Coding场景”这个说法,他的第一反应是笑。随后他给出一个毫不客气的判断:“它不是下一个vibe coding的场景。因为芯片设计本身不只单纯那点代码。”
两人说的都有道理。这场分歧本身,恰恰是理解AI4Chip最好的入口。
不过在进入他们的观点之前,有个背景得先摆上桌——为什么“AI4Chip是下一个Coding场景”这句话,会在2026年这个时间点被提起?
继Coding之后,基模厂商为什么选中了AI4Chip?
答案藏在Coding的成功里,也藏在Coding的天花板里,更藏在基模厂商的算力账单里。
大模型厂商在Coding场景上的成功,已经不需要论证了。Claude Code能写代码,Codex能改“仓库”,Coding agent成了过去两年里大模型最扎实的落地场景——任务可验证、数据可获取、付费意愿明确、使用频率高。
可Coding这块市场的容量终归有上限。模型能力继续往上爬之后,基模厂绕不开一个问题:下一个能撑起同等量级收入的高价值任务域,在哪里?
AI4Chip被推上前台并非偶然。它符合“下一个Coding”的几个核心特征:任务高价值、专家经验密集、结果可验证、有大量可被学习的过程数据、且付费方是利润丰厚的芯片和EDA公司。更关键的是,芯片是算力的上游——对基模厂来说,做AI4Chip不只是卖工具,是往产业链更深处走一步。
招聘市场已经把信号摆得很直白了。社交平台上,基模厂商招芯片相关人才的帖子扎堆出现,岗位从数字前端的RTL、验证,到数字后端的布局布线、时序都有,有的甚至直接写明"欢迎vibe芯片的AI-native新人"。业内的普遍看法是,这其实是同一拨人在干两件事:训练AI做芯片设计的能力,以及自己造芯。
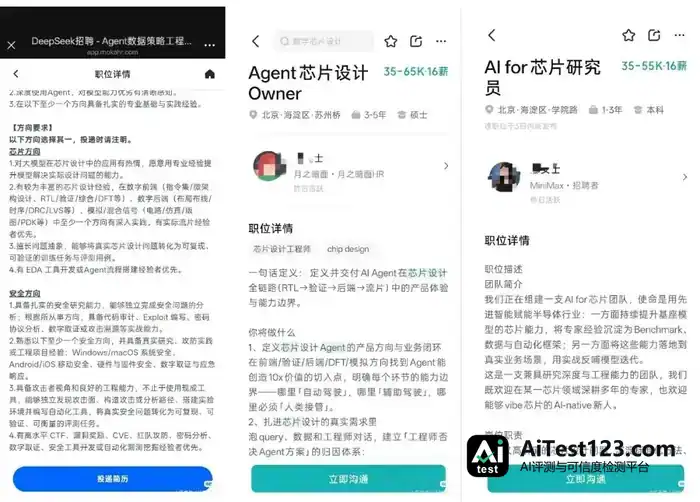
国内各个基模厂的招聘信息在社交平台被广泛讨论
基模厂为什么非要做这两件事?
一头是"练兵"。芯片是眼下最长的链条之一——规格、RTL、验证、综合、布局布线、时序、物理检查、流片,一环扣一环。大模型要能在这条极限链条上被验证,那还有什么场景是"征服"不了的?
另一头则极其现实:算力账单。剁椒酱说:"如果你有一个智力程度是碾压级别的模型,那你为什么还要买别人的卡呢?它既然是AGI,为什么不自己造卡呢?"这句反问戳的正是要害——基模厂做芯片,不只是为了卖工具,是要摆脱对上游算力巨头的依赖。对国内厂商来说,还多了一层"缺卡"的倒逼:"如果根本原因是缺算力,那为什么要优化细枝末节,而不是直接去优化这个根本约束呢?"
晒哥完全认同这个判断,并从商业终局上补了最后一环。在他看来,模型提供商卖的产品就是模型能力,跟电力一样,最终会走向寡头竞争和国家强监管。"发电厂"的利润相对固定,基础能源价格不可能太离谱。基模厂若还想求增长,就必须有自己的硬件产品。
于是AI4Chip被推上台面:它不只是技术演进,也是商业上的必然——大模型需要下一个现金流,基模厂需要摆脱算力依赖,芯片行业需要效率,政策需要弯道超车的抓手。几股动力叠在一起,基模厂商"自己下场"就成了不得不走的一步棋。
但动力归动力,当下是否成立是另一回事。这就回到了下面这个核心问题,也是两位受访者分歧的起点。
AI4Chip,是不是下一个Coding场景?
先别急着站队:两个人说的“AI4Chip”,不是同一件事。
剁椒酱的逻辑是从上往下看的。
他的出发点是AI能力的演进节奏。在他看来,今天做一颗大芯片要几百人甚至上千人协作,每人只懂其中一小块——这并非因为分工天然如此,而是因为"个人的智力带宽有限,个人能处理的 context 极其有限,因而不得不把工作流切分成很细的小块"。AI没有这个限制。一个足够聪明的AI能无限复制,能同时懂前端、后端、验证、物理设计。所以长期看,芯片设计一定会被AI加速,而且不只是加速某个环节,是软硬件co-design的整个循环,"AI for Chip,Chip for AI,它自己把这个loop转起来。"他把这个时间表放在未来5~10年。
眼下这条路线要务实不少,思路直接借了Coding的经验:先让AI学芯片工程师的知识,再学架构师的经验,然后才慢慢摸到co-design。早期它就是个提效工具,能替工程师省下30%的活;到了中期,可以端到端完成一些相对简单的芯片设计;最前沿的自我迭代阶段,排在最后。
他之所以觉得这条路“可行”,是因为Coding已经完整走过一遍。大模型在代码生成上的演进给了他可迁移的信心:任务只要能拆成可验证的步骤,AI就能一步步“吃掉”。
他说,AI4Chip眼下的状态像“去年或者前年的 Coding”——“大家已经感觉到它基本上能给你写大段的代码了。你可以把任务交给它,但它也留下了10%~20%最难的部分给到你。”
在晒哥看来,“现在”和“将来”得分开讲:“AI4Chip是一个很前沿的话题,业内讨论也挺多,但它现在还不是下一个vibe coding的场景。”
RTL、验证、PPA、wafer,是他每天要面对的东西。他承认AI已经在替硬件工程师干活了——写点前端代码、生成小脚本、查工具用法。可他强调这只是冰山一角。芯片设计真正难的地方不在那点代码,最终要落回一个物理实体上。“你还要考虑物理设计、测试,以及 PPA(功耗、性能、面积)这个不可能三角……单纯输出代码其实是很简单的事,我们目前也已经在做了。但整体意义上的AI4Chip,其实是一个系统性的考量。代码,只是开头的那一小部分。”
对当前芯片设计环节里的AI工具,他给了一个很具体的分级:L0到L1。市面上大多数所谓“EDA Agent”还卡在L0到L1之间——“给模型接了一个 shell,就敢说自己是 Agent”。即便是EDA三巨头之一自己发布的AI工具,在他看来“更多像是小助手,能帮你查东西、生成小脚本,甚至还到不了半自动化的程度”。
也就是说,剁椒酱谈的是“AI能不能学会芯片设计这件事”,晒哥谈的是“AI目前学会的那部分,在真实芯片交付里到底占多大比重”。两件事不是一回事。
两人其实有个共同判断:AI会持续往芯片设计里走。分歧不在方向,在节奏和重心——剁椒酱盯的是能力曲线怎么延伸,晒哥盯的是这条曲线在真实交付里落在哪。动力既然不是问题,关键就在落地进展。问题也就自然变成:大家现在到底做到哪一步了?
大家现在做到哪一步?国内外是否存在差距?
对国内进展,剁椒酱的判断很克制:大家都在水下。水面上能看到的,是此前月之暗面发布的Kimi K3 使用开源 EDA 工具和 Nangate 45nm 工艺库,完成了一颗面积约 4mm² 的芯片设计。9月份,千问官宣分别开展了两项面向生产环境的实验:芯片设计这边,Qwen3.8-Max从一份 NoC 模块规格出发,走完了 RTL、验证和物理实现;另一项独立实验里,Qwen3.8-Max 把 Qwen3.8-Flash-Next 部署到平头哥真武M890,并持续优化端到端推理性能。
国外方面,Anthropic已官宣组建专门的芯片设计团队,开始用Claude做定制芯片的工程开发和设计。OpenAI联合新思科技宣布达成多年期战略合作,共同开发面向芯片设计的专用 AI 模型 GPT-Synopsys。把国外的AI4Chip组合放在一起看,国内在EDA和模型两方面都偏弱。不过总的来说,国内国外,这条路离商业化都还有一段距离。
难处他也讲得很直白。芯片公司的经验大量不在纸面上,而在工程师脑子里、在保密文档里。眼下能想到的解法就是雇专家,没有更好的办法。AI4Chip成果好坏的评价标准,同样得靠行业专家来建,“就像AI4Science里拉一堆基础学科大牛来做benchmark一样”。他自己日常碰到的难关是“怎么更好地scaling好的数据”,这个问题由“非常非常多细节堆起来”,很难说哪个环节特别难。
晒哥的视角,是从落地困境切入的。
他提到行业里一个普遍矛盾,“态度很Open,行动很谨慎”:老板既想在这件事上有建树,又不太愿意做第一个吃螃蟹的人。公司当前不会立一个项、砸几亿去支持一个从头到尾AI-native的芯片项目流片。工程师做demo可以,可demo不流片就只是demo;不少demo用的还不是商用EDA工具,而是开源的东西,跟全世界主流流程相悖,结果拿不到主流认可,也就进不了真实生产环境。
那国内外差距究竟多大?晒哥给了一个更具体的尺度:大约6个月。
在他看来,国外顶尖模型确实领先,但领先幅度“也就是6个月的时间”。更要紧的是,这6个月能靠工程手段补——比如不去继续堆模型参数,而是把Harness做得更好。
芯片终究是软硬结合的东西。被问到国外EDA、制造链条完整先进,长期累积下来国内外差距会不会反而拉大时,晒哥持乐观态度,他把国内的优势锚定在应用端和需求量上。应用铺开之后,产品出货量能正向指导它往哪个方向改进、升级,而不是靠旧有数据、旧有指标来指导改进。放到AI4Chip上也是同理:真实应用场景带来应用端的正反馈,这个正反馈再指导AI4Chip去增强。他强调这其实是一条“非常长的链条以及评价体系”,不是答卷那种“答完就得满分”的路子。
这也解释了他为何把国内赶超的路径概括成六个字:农村包围城市。他认为国内对AI4Chip的意愿其实更强——芯片这条路上,国内一直是追赶者,沿着旧有欧美路线走,弯道超车不太可能。“你想要超过他们,可能是有另外一条赛道,就类似于新能源汽车似的。”AI4Chip就是那条新赛道。
国内的政策也在这个时点跟上了。
8月,北京经开区(全称北京经济技术开发区)对外公布了《“AI4Chip”人工智能赋能集成电路产业跨越式发展行动计划(2026-2028年)》,这份文件也被叫作“AI4Chip 20条”。它是国内第一份专门面向AI4Chip的政策,落点在集成电路产业,围绕“AI原生全链赋能”、“AI+智能设计”焕芯、“AI+制造封测”筑芯、“AI+设备材料”强芯、“AI+产业生态”育芯五项行动集中推进。按照文件设定的目标,到2028年,北京经开区要基本搭起集成电路产业的AI融合发展体系,扶出3~5家在国际上有影响力的AI4Chip生态型领军企业,并形成10个以上能在行业内推广的标杆应用。
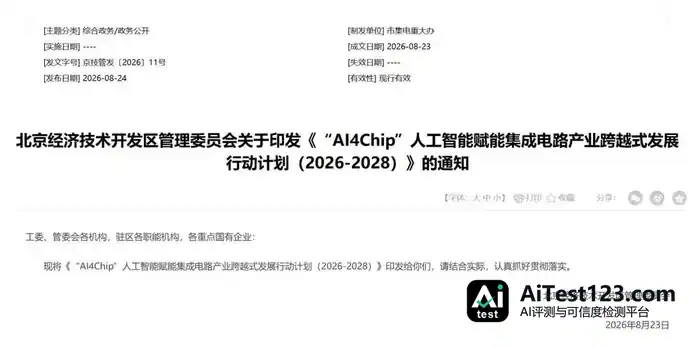
图源:北京经济技术开发区官网
不过,政策能不能解决“第一个吃螃蟹的人”的问题?答案恐怕还是偏谨慎。流片这笔账值不值得算,属于商业决策,政策替代不了。真正的拐点不在文件发布那天,而在某家公司肯拿出一个真实项目、一笔真实流片预算,把AI-native全流程跑完并且跑成了的那天。
说到底,眼下是“有demo、有政策、有招聘,但缺真实流片和商业闭环”。那要是真跑通了呢,芯片行业会被改成什么样子?
夹在中间的芯片设计公司:是被挤扁,还是被逼出新的形状?
前面两位已经在一点上想到了一起——AI会越来越深地进入芯片设计,可短期离“生成即交付”还差得远,卡住人的是验证、流片和责任。顺着这个往下问,问题就不再是“AI能不能做芯片”,而是更实际的另一层:AI真的一步步做进来,谁的利益会被重新分?
剁椒酱的判断很形象。他说,原来的芯片设计公司会被夹在大模型和EDA厂商中间。EDA和大模型都在把芯片公司的价值往中间压——模型公司出智力,EDA公司出工具,两头都在拿走原先由人提供的价值。哪头拿得多、哪头拿得少,他的说法是“目前还没有太清晰,得看谁做出了特别新、特别不可替代的东西”。
对这个“三明治结构”,晒哥没有直接反对,而是换了个角度补了一笔。他觉得EDA厂商不会随便下场做芯片:芯片种类太多、场景需求的总量他们接不住;更关键的原因不在技术,在基因。EDA厂商靠“卖license”赚钱,卖铲子的人不会轻易改行去挖金子。至于大模型厂商,他同意模型厂商为了把利润做大会有往上游走的动力,但走法更可能是深度参与AI4Chip、跟design house合作,而不是把芯片设计公司顶掉。
那芯片设计公司真正的压力从哪来?晒哥看到的是两头:一头是系统厂自己造芯片,云厂商、车企、互联网公司都在做;另一头是AI加持下的新兴公司从旁边包上来。传统芯片设计公司要是不变,很快会掉到第三方服务商的位置。“第三方服务不代表不赚钱,但成长空间有限——当你技术不是最领先、又没有足够的护城河时,你干的就是苦力活。”
放到整个芯片行业看,AI4Chip带来的改变,晒哥划了一条很利落的分界:得看是“AI+”还是“+AI”。只给现有流程加个AI助手,那叫“+AI”;真叫“AI+”,是组织形式和分工结构跟着变。
他设想,以后可能不再是动辄上万人的大公司,而是一群超级个体凑成的“Lab”式集群,“一个超级个体走得快,一群超级个体走得远”。大兵团作战大概会少下去,替上来的是认知对得上号的小型组织,靠AI干完以前只有大公司才干得成的事。当然,前提是有AI加持,而且急不得——他估计5年会有大转变,10年内也许整体范式都会变。
剁椒酱看到的变化在需求那一侧:长尾需求会被激活。中国应用端碎得很,不少定制芯片原先“商务上各种不划算”,AI要是把生成成本压下来,最先受益的就是一批中小公司和碎片化的需求。
那芯片设计公司会不会被挤?两位受访者的说法最后收到同一个点上:会重新分层。能做出不可替代的新东西的公司,会把两头挤出来的价值接走;只会做同质化交付的,会往第三方服务商滑;长尾市场里则会冒出一批新玩家,借AI用更小的团队、更低的成本做定制芯片。
那么,出现什么信号,才能说AI4Chip真的成立了?
发生了什么?就可以判定AI4Chip是下一个Coding场景
不是发布会,是流片、出货,还有“不再讨论”。
先把伪信号排掉。模型厂商发demo不算,招聘启事挂出来不算,政策发布不算,网上讨论热也不算。这些只说明“有人在押注”,说明不了“场景成立”。
真信号,按两位受访者的判断合起来,可以列成一张清单。
第一,真流片,不是demo。晒哥讲得挺直接:demo不流片就只是demo。时间表上,他的判断是“MPW 的流片近几年可能会越来越多,但肯定不会是先进工艺。full-mask的流片,未来3~5年可能会有,而从 full-mask 到完全量产,则还需要一段时间。”剁椒酱说的“端到端做简单芯片”对上的就是这个节点——不是生成一段RTL,是把整个流程走完、流片,拿回来还能工作。
第二,进得了商业EDA的signoff路径。不是开源工具跑通就算,得被主流流程认。商业EDA的signoff地位短期不会动,原因不在技术,在责任。AI4Chip的工具链要进真实生产,这个问题绕不过去。
第三,数据飞轮得转起来。晒哥在文章里写过:“EDA被攻破是时间问题,不是可能性问题。工具运行日志、仿真波形、时序报告,这些数据每天都在服务器上产生,一旦有商业模式把它们组织起来,稀缺性就会被打破。”剁椒酱提到的“更好的scaling好的数据”,说的其实也是同一件事。
第四,商业化分成要清楚。基模厂商、EDA、芯片设计公司之间得形成能持续的收费和分成模式,不能老停在试点。OpenAI和新思的分成试水,就是一个早期信号。
第五点在于讨论的对象换了。晒哥说,真正铺开的时候,恐怕不会出现"XX年发生了XXX"那种能写进历史书的大事件。"更多是大家在讲这些工具做出来的芯片指标怎么样、用在哪里、出货多少——等媒体开始这么报,而不是还在报模型本身,那才算真落地。"到那时候,这个疑问自己就没了,没人再问"是不是下一个 Coding 场景",大家都当寻常事。
两位受访者给出的时间表可以摆在一起看:剁椒酱估的终局是 5 到 10 年;晒哥认为 5 年会迎来一次大转变,10 年之内整个芯片行业的范式都会变。
当然,这些时间表都有个前提——世界照着剧本走。
可就在近日,行业用两天时间,给所有人连上了好几堂"黑天鹅"课。执掌英伟达 33 年、亲手把 CUDA 做成全球 AI 产业默认地基的黄仁勋辞任,市值一夜之间几乎跌穿 4 万亿美元。Anthropic 则在 IPO 前夜放出新一代旗舰模型 Claude Fable 5.2,还与电路板设计制造公司 Diode 合作,让 Fable 5.2 依据一段简短要求,设计出家庭语音助手中枢、USB 会议扬声器和掌上虚拟宠物三款设备,并开始"拆解"CUDA。
另一头,Claude Mythos Preview 只花了约 3 天,就让一个 Claude 模型在 AMD Instinct MI355X 上跑通了关键推理环节:近 100% 的 GPU 内核代码由模型移植或重写,人工干预很少。CUDA 的软件迁移壁垒,第一次被 AI 明显压了下去。
这两件事,事先没有一份研报预警过。行业的残酷也在这里:它只管让所有精心推演的时间表一夜作废。真到拐点来的时候,大概率也不会按我们此刻设想的样子出现。
不过无论从哪边看,时钟都已经开始走了。