DeepSeek宣布开放全家桶应用API:开发者可1:1复刻出完整的DeepSeek App

资讯 网易科技 作者:网易 全文 228 字 · 约 1 分钟读完 配图 2 张 分类DeepSeek深度求索Deepseek

sina qqZone renren ydCloud 0

所属频道 开源生态

11月13日,澎湃新闻记者获悉,DeepSeek开放了全家桶应用API(接口)。开发者只要在原有API中打开对应参数,就能获得深度思考搜索、文件输入等对话功能。语音和相关底层能力也已作为独立接口开放,涵盖OCR(光学字符识别)、ASR(自动语音识别)、TTS(文本转语音)等,可以单独调用,也能组合使用。借助这些接口,开发者能在自己的应用里实现复杂的对话功能,甚至1:1复刻出完整的DeepSeek App。

换句话说,深度思考搜索、文件输入等对话能力都能通过参数开关直接调起来;语音这一块,OCR、ASR、TTS等底层能力同样单独放出了接口,开发者按需取用即可。
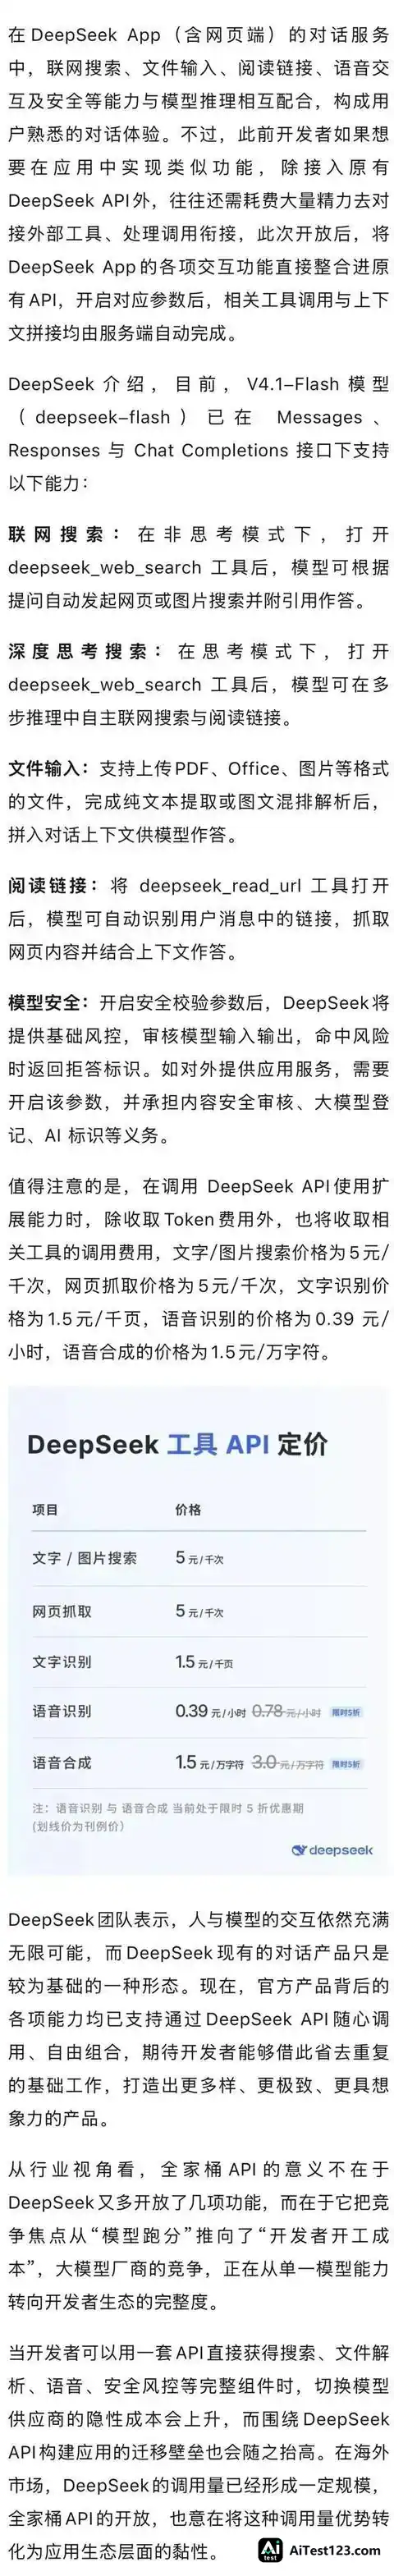
DeepSeek宣布开放全家桶应用API:开发者可1:1复刻出完整的DeepSeek App(配图 1)

本期编辑 陆枫

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek开放全家桶应用API:搜索、文件、语音能力一站式调用

    DeepSeek表示,在 DeepSeek App的对话服务中,联网搜索、文件输入、阅读链接、语音交互及安全等能力与模型推理相互配合,构成了用户熟悉的对话体验。开发者可以在自己的应用中轻松实现复杂的对话功能,甚至 1:1 复刻出完整的 DeepSeek App。具体来看,本次更新将 DeepSeek App 的各项交互

    来源 TechWeb
  2. DeepSeek发布全家桶应用API

    DeepSeek正式开放全家桶应用 API:在原有API中开启对应参数,即可获得深度思考搜索、文件输入等对话功能;语音及相关底层能力也已开放独立接口。开发者可以在自己的应用中轻松实现复杂的对话功能,甚至1:1复刻出完整的DeepSeek App。

    来源 华尔街见闻
  3. DeepSeek前端代码现额度管理:Coding Plan要来了?

    IT之家 11 月 14 日消息,有开发者在 chat.deepseek.com 的前端代码中发现了一整套额度管理逻辑,提示文案包括“使用额度已达上限,请额度恢复后再试”。 此外,其代码还包含额度耗尽后的错误处理分支,以及“分享对话后继续聊”场景下对 quotas 数组中 is_exhausted 状态的检查。 根据开

    来源 AI 行业观察
  4. DeepSeek人才为何不创业:顶尖AI扎堆,出走多进大厂

    几乎从未见到DeepSeek走出的创业者。 但这里聚集着大批学历顶尖的年轻AI人才。即便此前有少数员工离开,他们大多数的选择也是加入其他大厂,而并非创业。与这份清冷形成反差,今年几乎是AI大厂人才出走最鼎盛一年,他们离职创业便动辄拿下几十亿估值。 “不诱于誉,不恐于诽,率道而行,端然正己。”DeepSeek今年4月发布

    来源 AI 行业观察
  5. NaiveAI开源模型Naive-N0.5-Flash,获Latent Space首期实测

    梦瑶 发自 凹非寺量子位 | 公众号 QbitAI国产大模型,又杀出一匹黑马!而且这回,还是被硅谷超火的硬核AI技术媒体Latent Space亲自实测出来的。就在11月10日,Latent Space推出全新模型测评栏目,专门做「不带立场」的新模型实测。而栏目首期,其就把目光投向了中国公司NaiveAI的开源模型Na

    来源 腾讯网
  6. AI模型明明算对了,却停不下来反复检查:这个“疑心病”该怎么治

    你有没有过这种经历:一道数学题,你其实在心里已经算出答案了,但还是不放心,又拿起笔重新验算一遍,甚至反复算了三四次,哪怕前几次结果一模一样。现在的AI推理模型,比如Qwen3、DeepSeek-R1这类能够“思考”的大模型,正患上一种类似的毛病。它们在给出答案之前会写一长串思考过程,专业上叫**思维链**思维链:模型在

    来源 腾讯网
  7. 门罗风投报告:美国企业开源模型支出89%流向中国模型

    硅谷知名风险投资机构门罗风投(Menlo Ventures)发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。前三名中,Kimi占61%,DeepSeek占15%,GLM占11%。 市场很愿意接受一套简洁叙事:依靠性能与定价,国产大模型抢走海外开发者预算。 但同一份报告里还有

    来源 AI 行业观察
  8. 豆包工作开放第三方模型接入:Kimi K3.1Pro等可选,按倍率计费

    豆包工作11月12日更新,接入多款第三方大模型并推出限时特惠计划。用户在豆包2.1Lite与Pro两款自研模型之外,新增可选Kimi K3.1Pro、GLM5.3、DeepSeek V4.1Flash等模型,选择范围由自研体系扩至外部主流阵容。 因模型使用成本不同,豆包工作在模型选择页面标注各模型的额度消耗倍率,系数越

    来源 AI 开发者社区
  9. DeepSeek-V4等6款模型:Blackwell指纹涉12000块GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 科技快讯
  10. 六款国产AI模型现Blackwell硬件痕迹:约12000块受管制GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 行业观察
  11. 对话前Hugging Face王铁震:当开源模型走入“至暗时刻”,别再卷参数了,赶紧赚钱吧

    过去三年,国内几乎每一次现象级的开源大模型出海,背后都有王铁震的身影。2022 年底,曾参与把 TensorFlow 塞进手机和单片机的他离开 Google,加入 Hugging Face 负责亚太生态。在那个“开源就是把模型权重扔进网盘”的草莽年代,他帮国内团队做 Day 0 上架、定开源策略、在海外造势,亲历了零一

    来源 腾讯网
  12. 马斯克裁掉xAI多模态团队,同时又挂出同方向招聘

    硅谷这么大瓜,也没耽误马斯克又把麾下一个部门整窝端了。 量子位获悉,老马近期裁撤了xAI的整个multimodal团队,团队约70人无一幸免。 多模态不做了? 但几乎同时,xAI官方招聘立刻上新了“Model Engineer, Multimodal Understanding”岗位,base地在加州Palo Alto

    来源 AI 行业观察
向下滚动自动加载更多